


 Дом
Google представляет Gemini Embedding2: собственная мультимодальная модель, объединяющая семантические пространства
Недавно компания Google представила свою новую нативную мультимодальную модель вложений — Gemini Embedding2. Она позволяет отображать текст, изображения, видео, аудио и PDF-документы в единое семантическое векторное пространство, что призвано оптимизировать сложные рабочие процессы с данными искусственного интеллекта и улучшить мультимодальный поиск и понимание. Это стало важным прорывом для Google в области технологий вложений, ознаменовавшим переход от одномодального текста к унифицированному мультимодальному семантическому моделированию.
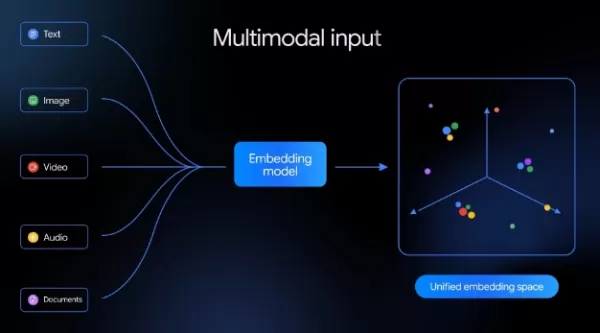
Ранее, в июле 2025 года, Google представила модель текстового встраивания gemini-embedding-001. Она поддерживала более 100 языков и достигла лучших результатов в многоязычном тесте MTEB. Новая Gemini Embedding2 основана на архитектуре Gemini, но значительно расширяет ее возможности. Теперь она обрабатывает пять различных модальностей — текст, изображения, видео, аудио и PDF-файлы — и проецирует их в единое векторное пространство. Это позволяет проводить прямые семантические сравнения между различными типами медиа без необходимости использования нескольких специализированных моделей или дополнительных этапов обработки. Эта возможность особенно ценна для таких приложений, как семантический поиск, генерация с расширением поиска (RAG), анализ тональности и кластеризация данных.
Что касается возможностей ввода, новая модель поддерживает до 8192 текстовых токенов, что в четыре раза превышает прежний лимит в 2048 токенов. Она может обрабатывать до шести изображений в формате PNG или JPEG на один запрос, видео длительностью до 120 секунд и PDF-документы объемом до шести страниц. Примечательной особенностью является встроенная поддержка Gemini Embedding2 для обработки аудио, что устраняет необходимость преобразования речи в текст и позволяет избежать потенциальной потери информации при транскрипции. Google также представила технологию «чередующегося ввода», позволяющую разработчикам комбинировать несколько модальностей в одном запросе — например, смешивать изображения с описательным текстом — для лучшего отражения семантических отношений между ними.
С архитектурной точки зрения модель по-прежнему использует Matryoshka Representation Learning (MRL). Эта техника использует иерархическую структуру для динамической настройки размерности векторов. Размерность встраивания по умолчанию составляет 3072, при этом доступны дополнительные конфигурации 1536 и 768, что дает разработчикам гибкость для балансировки точности поиска и эффективности хранения.
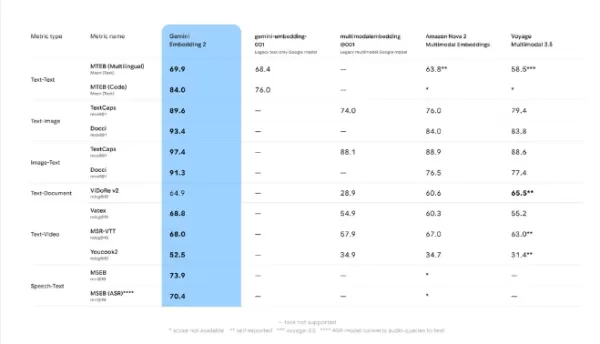
Результаты тестирования Google показывают, что Gemini Embedding2 демонстрирует лидирующую производительность при выполнении задач с текстом, изображениями, видео и речью. Например, при поиске по тексту и видео она набирает 68,8 баллов, превосходя Amazon Nova2Multimodal Embeddings (60,3) и Voyage Multimodal3.5 (55,2). При сравнении текста и изображений он набирает 93,4 балла, что значительно превосходит результат модели Amazon (84,0).
В настоящее время Gemini Embedding2 доступен разработчикам через Gemini API и Vertex AI. Он интегрируется с популярными фреймворками и векторными базами данных, такими как LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB и Vector Search. Чтобы помочь разработчикам начать работу, Google предоставляет интерактивные ноутбуки Colab и демонстрации облегченного мультимодального семантического поиска.
Конкуренция в области мультимодального встраивания набирает обороты. В частности, в конце февраля этого года поисковая система на базе ИИ Perplexity выпустила свои модели встраивания с открытым исходным кодом: pplx-embed-v1 и pplx-embed-context-v1.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (0)
Недавно компания Google представила свою новую нативную мультимодальную модель вложений — Gemini Embedding2. Она позволяет отображать текст, изображения, видео, аудио и PDF-документы в единое семантическое векторное пространство, что призвано оптимизировать сложные рабочие процессы с данными искусственного интеллекта и улучшить мультимодальный поиск и понимание. Это стало важным прорывом для Google в области технологий вложений, ознаменовавшим переход от одномодального текста к унифицированному мультимодальному семантическому моделированию.
Ранее, в июле 2025 года, Google представила модель текстового встраивания gemini-embedding-001. Она поддерживала более 100 языков и достигла лучших результатов в многоязычном тесте MTEB. Новая Gemini Embedding2 основана на архитектуре Gemini, но значительно расширяет ее возможности. Теперь она обрабатывает пять различных модальностей — текст, изображения, видео, аудио и PDF-файлы — и проецирует их в единое векторное пространство. Это позволяет проводить прямые семантические сравнения между различными типами медиа без необходимости использования нескольких специализированных моделей или дополнительных этапов обработки. Эта возможность особенно ценна для таких приложений, как семантический поиск, генерация с расширением поиска (RAG), анализ тональности и кластеризация данных.
Что касается возможностей ввода, новая модель поддерживает до 8192 текстовых токенов, что в четыре раза превышает прежний лимит в 2048 токенов. Она может обрабатывать до шести изображений в формате PNG или JPEG на один запрос, видео длительностью до 120 секунд и PDF-документы объемом до шести страниц. Примечательной особенностью является встроенная поддержка Gemini Embedding2 для обработки аудио, что устраняет необходимость преобразования речи в текст и позволяет избежать потенциальной потери информации при транскрипции. Google также представила технологию «чередующегося ввода», позволяющую разработчикам комбинировать несколько модальностей в одном запросе — например, смешивать изображения с описательным текстом — для лучшего отражения семантических отношений между ними.
С архитектурной точки зрения модель по-прежнему использует Matryoshka Representation Learning (MRL). Эта техника использует иерархическую структуру для динамической настройки размерности векторов. Размерность встраивания по умолчанию составляет 3072, при этом доступны дополнительные конфигурации 1536 и 768, что дает разработчикам гибкость для балансировки точности поиска и эффективности хранения.
Результаты тестирования Google показывают, что Gemini Embedding2 демонстрирует лидирующую производительность при выполнении задач с текстом, изображениями, видео и речью. Например, при поиске по тексту и видео она набирает 68,8 баллов, превосходя Amazon Nova2Multimodal Embeddings (60,3) и Voyage Multimodal3.5 (55,2). При сравнении текста и изображений он набирает 93,4 балла, что значительно превосходит результат модели Amazon (84,0).
В настоящее время Gemini Embedding2 доступен разработчикам через Gemini API и Vertex AI. Он интегрируется с популярными фреймворками и векторными базами данных, такими как LangChain, LlamaIndex, Haystack, Weaviate, Qdrant, ChromaDB и Vector Search. Чтобы помочь разработчикам начать работу, Google предоставляет интерактивные ноутбуки Colab и демонстрации облегченного мультимодального семантического поиска.
Конкуренция в области мультимодального встраивания набирает обороты. В частности, в конце февраля этого года поисковая система на базе ИИ Perplexity выпустила свои модели встраивания с открытым исходным кодом: pplx-embed-v1 и pplx-embed-context-v1.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai












