


 首頁
Google DeepMind 成立研究所以擴大關於通用人工智慧(AGI)的討論
Google和Google DeepMind於週三成立了DeepMind研究所,以促進關於通用人工智慧(AGI)的對話。該研究所由DeepMind聯合創始人Shane Legg、Google高管James Manyika以及Google DeepMind主席Demis Hassabis領導,其中Legg擔任執行編輯。
這一新舉措旨在突出Google、DeepMind以及全球研究社羣內部關於AGI的多樣化觀點。公告指出,參與者“可能並不總是達成一致”,並且隨著這一快速演進的領域出現新資料,他們可能會修正自己的立場。
首批收錄的四篇論文探討了關鍵問題:管理潛在AGI顛覆的經濟策略、保持人類可讀的模型推理、人類繁榮的原則,以及評估前沿AI模型的框架。
DeepMind安全研究人員Rohin Shah和Anca Dragan在一篇論文中指出,AI系統透明度的下降——即逐步檢查推理過程的能力——並非不可避免。隨著新架構使監控變得複雜,他們建議開發人員和監管機構必須直接解決安全權衡問題。這可能涉及限制“不透明的序列深度”,或要求證明透明度較低的系統仍然具有同等程度的可監控性。
在另一篇論文中,Demis Hassabis提出成立一個由美國主導的前沿AI標準機構,以評估先進模型。根據該提議,開發人員最初將在釋出前30天內自願提交模型以供審查。一旦評估系統被證明有效,透過此類測試可能成為在美國部署前沿模型的強制要求。
最初,該機構將在AI公司的參與下設計評估,但最終將建立獨立的、未公開的評估——即“預留”測試——以防止實驗室針對已知基準最佳化模型。Hassabis表示,如果情況需要,該框架可以“升級”,可能包括前沿AI開發人員之間的協調放緩。
隨著行業安全討論從一般性擔憂轉向關於披露、外部審查以及如果安全措施滯後則協調放緩的具體提議,這些論文應運而生。本週,隨著行業領袖支援Anthropic執行長Dario Amodei呼籲“控制”前沿AI的發展步伐,這種勢頭進一步增強。
相關文章
 Anthropic 的 Sonnet 5.5 洩露:200 萬代幣的上下文挑戰促使 DeepSeek 重拾成本效益
Anthropic 已揭曉其最新的 Sonnet 5.5 模型,內部代號為「Fennec」(取自沙漠狐之名),預計將於下個月正式發布。 外流的細節顯示,該模型支援 200 萬個標記的上下文視窗,能提供更快的推理速度、更低的延遲,並顯著提升長上下文推理與多步驟規劃能力。此外,其針對瀏覽器和終端的工具調用能力亦有所提升。 儘管其性能可與旗艦級模型 Claude Fable 5 媲美,但定價仍將維持在
Chrome 推出 Gemini 技能庫:一鍵重複使用提示語,告別重複輸入
Google 已為Chrome 桌面版推出更新,為其內建的 Gemini 功能新增了「技能庫」。這項功能強化讓使用者能將複雜的 AI 提示語儲存為可重複使用的「技能」,以便在各個網頁間無縫應用。核心突破:從「聊天框」到「工具箱」過去,使用者在使用 AI 時經常需要重新輸入背景資訊。「技能庫」從根本上改變了這種互動模式:自訂技能:使用者可將常見的 AI 任務(例如分析元件、比較規格、擷取摘要)儲存起
Anthropic 執行長力推銀行式 AI 規範,專家警告不宜身兼「球員」與「裁判」雙重角色
據 CNBC 報導,Anthropic 執行長達里奧·阿莫迪(Dario Amodei)建議在領先的人工智慧企業內部設置長期獨立的第三方安全評估人員,賦予他們近乎內部風險團隊的訪問權限,並授權其在有限制的情況下獨立公布評估結果。 他明確以嵌入式銀行監管機構為例,並承諾 Anthropic 將為第三方評估人員提供與內部風險團隊同等的系統存取權限。阿莫迪在上週末發表的一篇長文中還警告,在未來 6 至
相關專題推薦
社群媒體
 最佳 AI 圖文說明生成工具:快速撰寫各平台專屬的社群貼文
2026 年最新最佳 AI 圖文說明生成器專頁! XIX.AI 精心整理了一份備受好評的推薦清單,收錄了多款強大且值得嘗試的工具,助您快速撰寫各平台專屬的社群貼文。這些工具均經過嚴格的實測驗證,並提供免費與付費版本的比較分析及清晰的排名,協助您找到最合適的選項,從而提升工作效率並發揮人工智慧的優勢。立即探索!
 11 個工具
 xix.ai
健康與養生
最適合輪班工作者、時差恢復及建立更好作息的頂尖 AI 睡眠輔導工具
2026 年最新最佳 AI 睡眠輔導工具,專為輪班工作者、時差恢復及建立更健康作息而設計!XIX.AI 精心精選了一系列備受好評、功能強大且能徹底改變現狀的工具,這些工具均經過實測驗證,可提供精準的指導。 您可查閱詳盡的免費版與付費版比較資訊,並了解這些必試解決方案如何協助提升睡眠品質、加速時差恢復,以及建立更健康的作息習慣。立即探索,找出最適合您的工具!
7 個工具
xix.ai
代碼
用於除錯 Python 錯誤、API 日誌和堆疊跟蹤的 ChatGPT 工具
2026 年最新 ChatGPT Python 錯誤、API 日誌和堆疊跟蹤除錯工具,盡在 XIX.AI。這份精選頂級解決方案列表提供免費與付費對比、真實世界測試以及詳細排名,幫助您找到功能最強大的工具,顯著提升生產力並更快解決複雜技術問題。立即探索,發現您的完美解決方案!
9 個工具
xix.ai
文字轉語音
用於產品演示影片的人工智慧配音工具
2026 年最新最佳頂級評分 AI 配音工具,用於產品演示影片,現已上線 XIX.AI!此精選列表包含強大且具顛覆性的選項,可幫助您快速建立專業級音訊內容,顯著提升演示效率。我們進行真實世界測試,並提供免費與付費版的對比以及每週更新的排名,以幫助您找到最合適的工具。立即探索,解鎖您的 AI 優勢!
10 個工具
xix.ai
商業
用於新創公司驗證的 AI 商業計畫工具
2026 年最新最佳 AI 商業計畫工具,助您驗證新創企業!XIX.AI 精選了一系列備受好評、功能強大且能改變遊戲規則的工具,這些工具均經過實際測試,可提供精準的結果。 您將在此找到免費版與付費版的對比分析、詳細排名,以及淺顯易懂的分析見解,助您選擇最理想的解決方案,並提升新創企業的成功率。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai
聊天機器人
用於角色扮演和對話練習的 AI 聊天應用
2026 年最新最佳角色扮演與對話練習 AI 聊天應用!XIX.AI 精心策劃了一份頂級評分列表,收錄了經過嚴格現實世界測試、能帶來卓越結果的重磅必備工具。您將找到詳細的免費與付費對比、全面排名,以及這些應用如何有效提升您的語言技能和溝通自信的見解。立即探索,發現最適合您的練習工具!
10 個工具
xix.ai

 評論 (0)
0/500
Google和Google DeepMind於週三成立了DeepMind研究所,以促進關於通用人工智慧(AGI)的對話。該研究所由DeepMind聯合創始人Shane Legg、Google高管James Manyika以及Google DeepMind主席Demis Hassabis領導,其中Legg擔任執行編輯。
這一新舉措旨在突出Google、DeepMind以及全球研究社羣內部關於AGI的多樣化觀點。公告指出,參與者“可能並不總是達成一致”,並且隨著這一快速演進的領域出現新資料,他們可能會修正自己的立場。
首批收錄的四篇論文探討了關鍵問題:管理潛在AGI顛覆的經濟策略、保持人類可讀的模型推理、人類繁榮的原則,以及評估前沿AI模型的框架。
DeepMind安全研究人員Rohin Shah和Anca Dragan在一篇論文中指出,AI系統透明度的下降——即逐步檢查推理過程的能力——並非不可避免。隨著新架構使監控變得複雜,他們建議開發人員和監管機構必須直接解決安全權衡問題。這可能涉及限制“不透明的序列深度”,或要求證明透明度較低的系統仍然具有同等程度的可監控性。
在另一篇論文中,Demis Hassabis提出成立一個由美國主導的前沿AI標準機構,以評估先進模型。根據該提議,開發人員最初將在釋出前30天內自願提交模型以供審查。一旦評估系統被證明有效,透過此類測試可能成為在美國部署前沿模型的強制要求。
最初,該機構將在AI公司的參與下設計評估,但最終將建立獨立的、未公開的評估——即“預留”測試——以防止實驗室針對已知基準最佳化模型。Hassabis表示,如果情況需要,該框架可以“升級”,可能包括前沿AI開發人員之間的協調放緩。
隨著行業安全討論從一般性擔憂轉向關於披露、外部審查以及如果安全措施滯後則協調放緩的具體提議,這些論文應運而生。本週,隨著行業領袖支援Anthropic執行長Dario Amodei呼籲“控制”前沿AI的發展步伐,這種勢頭進一步增強。








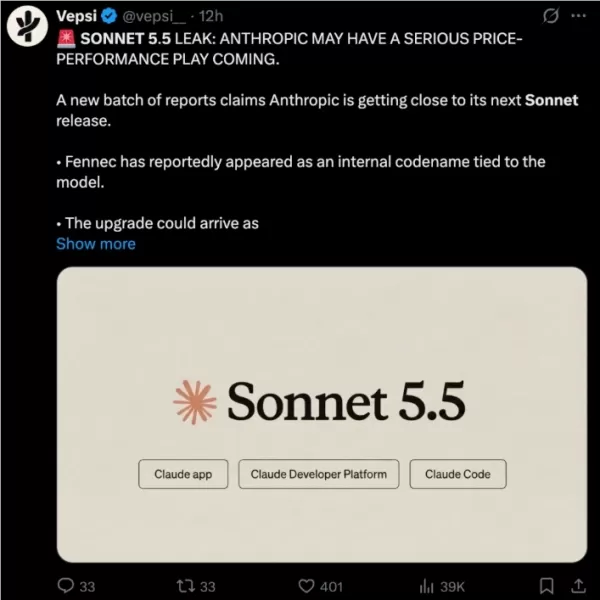 Anthropic 的 Sonnet 5.5 洩露:200 萬代幣的上下文挑戰促使 DeepSeek 重拾成本效益
Anthropic 已揭曉其最新的 Sonnet 5.5 模型,內部代號為「Fennec」(取自沙漠狐之名),預計將於下個月正式發布。 外流的細節顯示,該模型支援 200 萬個標記的上下文視窗,能提供更快的推理速度、更低的延遲,並顯著提升長上下文推理與多步驟規劃能力。此外,其針對瀏覽器和終端的工具調用能力亦有所提升。 儘管其性能可與旗艦級模型 Claude Fable 5 媲美,但定價仍將維持在
 Chrome 推出 Gemini 技能庫:一鍵重複使用提示語,告別重複輸入
Google 已為Chrome 桌面版推出更新,為其內建的 Gemini 功能新增了「技能庫」。這項功能強化讓使用者能將複雜的 AI 提示語儲存為可重複使用的「技能」,以便在各個網頁間無縫應用。核心突破:從「聊天框」到「工具箱」過去,使用者在使用 AI 時經常需要重新輸入背景資訊。「技能庫」從根本上改變了這種互動模式:自訂技能:使用者可將常見的 AI 任務(例如分析元件、比較規格、擷取摘要)儲存起
 Anthropic 執行長力推銀行式 AI 規範,專家警告不宜身兼「球員」與「裁判」雙重角色
據 CNBC 報導,Anthropic 執行長達里奧·阿莫迪(Dario Amodei)建議在領先的人工智慧企業內部設置長期獨立的第三方安全評估人員,賦予他們近乎內部風險團隊的訪問權限,並授權其在有限制的情況下獨立公布評估結果。 他明確以嵌入式銀行監管機構為例,並承諾 Anthropic 將為第三方評估人員提供與內部風險團隊同等的系統存取權限。阿莫迪在上週末發表的一篇長文中還警告,在未來 6 至
2026 年最新最佳 AI 圖文說明生成器專頁! XIX.AI 精心整理了一份備受好評的推薦清單,收錄了多款強大且值得嘗試的工具,助您快速撰寫各平台專屬的社群貼文。這些工具均經過嚴格的實測驗證,並提供免費與付費版本的比較分析及清晰的排名,協助您找到最合適的選項,從而提升工作效率並發揮人工智慧的優勢。立即探索!
11 個工具
xix.ai

2026 年最新最佳 AI 睡眠輔導工具,專為輪班工作者、時差恢復及建立更健康作息而設計!XIX.AI 精心精選了一系列備受好評、功能強大且能徹底改變現狀的工具,這些工具均經過實測驗證,可提供精準的指導。 您可查閱詳盡的免費版與付費版比較資訊,並了解這些必試解決方案如何協助提升睡眠品質、加速時差恢復,以及建立更健康的作息習慣。立即探索,找出最適合您的工具!
7 個工具
xix.ai
2026 年最新 ChatGPT Python 錯誤、API 日誌和堆疊跟蹤除錯工具,盡在 XIX.AI。這份精選頂級解決方案列表提供免費與付費對比、真實世界測試以及詳細排名,幫助您找到功能最強大的工具,顯著提升生產力並更快解決複雜技術問題。立即探索,發現您的完美解決方案!
9 個工具
xix.ai
2026 年最新最佳頂級評分 AI 配音工具,用於產品演示影片,現已上線 XIX.AI!此精選列表包含強大且具顛覆性的選項,可幫助您快速建立專業級音訊內容,顯著提升演示效率。我們進行真實世界測試,並提供免費與付費版的對比以及每週更新的排名,以幫助您找到最合適的工具。立即探索,解鎖您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳 AI 商業計畫工具,助您驗證新創企業!XIX.AI 精選了一系列備受好評、功能強大且能改變遊戲規則的工具,這些工具均經過實際測試,可提供精準的結果。 您將在此找到免費版與付費版的對比分析、詳細排名,以及淺顯易懂的分析見解,助您選擇最理想的解決方案,並提升新創企業的成功率。立即探索,釋放您的 AI 競爭優勢!
9 個工具
xix.ai

2026 年最新最佳角色扮演與對話練習 AI 聊天應用!XIX.AI 精心策劃了一份頂級評分列表,收錄了經過嚴格現實世界測試、能帶來卓越結果的重磅必備工具。您將找到詳細的免費與付費對比、全面排名,以及這些應用如何有效提升您的語言技能和溝通自信的見解。立即探索,發現最適合您的練習工具!
10 個工具
xix.ai












