


 首頁
DeepSeek 推出首款專為 AI 代理設計的開源多模態模型
DeepSeek 已在 Hugging Face 上發布 DeepSeek-V4-Flash-Vision-Exp,這標誌著 V4 系列中首個採用 MIT 授權的多模態實驗性模型正式亮相。 該模型擁有 3050 億個參數,並基於 V4-Flash-0731 基礎模型打造,將視覺編碼器和 Aligner 整合至其核心語言架構中,透過持續訓練實現穩健的圖像理解能力。
鎖定多模態代理,而不僅是圖像描述
有別於專注於視覺問答的傳統多模態模型,DeepSeek 重新定義了 Vision 版本的宗旨:優先考量多模態代理人的能力。 官方文件強調,代理程式能直接解讀視覺輸入(例如網頁截圖、軟體介面及圖表),並透過調用工具來執行任務。本質上,這對「眼睛」是專為機器代理程式設計,而非人類使用者。
這個開源套件內容完整,包含模型權重、Tokenizer、提示編碼參考實作,以及最簡化的 PyTorch 推論設定。它涵蓋了視覺編碼器、Aligner、DFlash Attention、MoE 和 Hyper-Connections 等核心模組。 社群反應迅速,Hugging Face 上已提供七種針對 llama.cpp、LM Studio 及 Ollama 的量化版本。
值得注意的時間軸細節顯示出其策略性的推出方式:該模型於 8 月 21 日首度現身於 DeepSeek API 上,當時僅能透過 API 存取,且未提供模型權重分發。 開發者可同時輸入文字與圖像,圖像處理費用按代號計費。十天後,權重正式發布,使本地部署與二次開發成為可能。這種「先 API,後開源」的策略,凸顯了 DeepSeek 作為 API 服務提供者的核心定位。
效能接近 Claude Opus 4.8,並經官方實測驗證
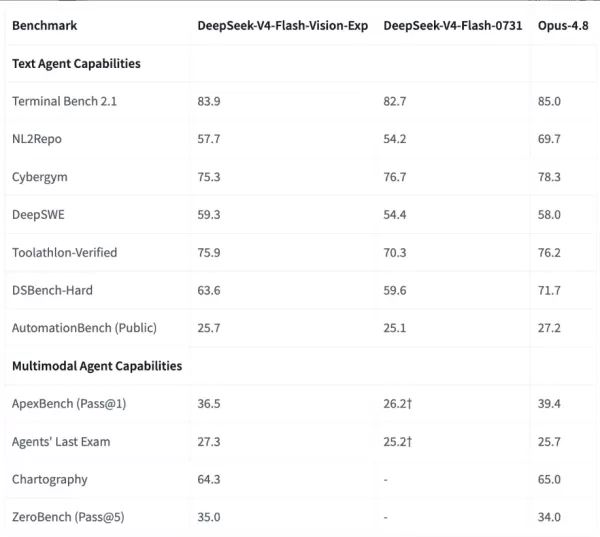
基準測試結果顯示,新增視覺能力並未顯著影響純文字代理的表現:Terminal Bench 2.1 分數從 82.7 上升至 83.9,DeepSWE 分數則從 54.4 提升至 59.3,超越了 Opus 4.8 的 58.0。 多模態代理的提升更為顯著:ApexBench Pass@1 達 36.5, Agents' Last Exam 達 27.3(超越 Opus 4.8 的 25.7),而 ZeroBench Pass@5 則達 35.0,表現優於競爭對手的 34.0。
然而,DeepSeek 並未宣稱具備「全面優勢」:在 NL2Repo 專案中,其得分為 57.7,落後於 Opus 4.8 的 69.7。 官方聲明仍持謹慎態度,僅指出「多模態代理能力已接近 Claude Opus 4.8」。 近期更新顯示,DeepSeek 正逐步建構完整的代理技術堆疊:該模型負責推理與工具調用,Harness 管理持續的任務執行,而 Vision 則使代理能夠直接解讀電腦視覺資訊。此次開源發布是完善此生態系統的關鍵一步。
相關文章
 美國衛生機構評估 OpenAI 和 Anthropic 的 AI 模型
全美各地的公共衛生機構將透過「健康人工智慧聯盟」(Coalition for Health AI)主導、並與 OpenAI、Anthropic 及埃森哲(Accenture)合作的新計畫,對生成式人工智慧進行評估。「公共衛生應用案例與學習擴展引擎」(PULSE)將資助橫跨 10 個州、地方、部落及轄區的試驗計畫。這項計畫旨在為正考慮部署類似人工智慧系統的公共衛生組織,制定可付諸實行的實施指引。Op
支付寶的「一觸即付」服務將把 3,000 萬個線下接觸點轉化為一個由人工智慧驅動的商業網絡
繼推出全棧式 AI 支付系統及由 AI 驅動的支付寶助手「阿寶」後,支付寶於 7 月 8 日宣布,其「一觸即付」解決方案已完成全面的人工智慧升級。 部署於各商家、數量達數百萬台的「一觸即付」終端機已轉型為「一觸即付終端代理」,同時,支付寶也針對中小企業推出了「一觸萬物代理」服務平台,並同步推出「AI開放基地」。 歷經兩年密集開發,「一觸即付」現已服務4億用戶,與2,300家生態系服務供應商合作,並
Tealium:為何 RAG 品質取決於即時資料
Tealium 應用人工智慧部門首席產品經理弗雷迪·貝蘭蒂(Freddy Berlanti)深入探討檢索增強生成(RAG)技術。圖片來源:Getty ImagesTealium 應用人工智慧部門首席產品經理弗雷迪·伯蘭蒂(Freddy Berlanti),剖析了能創造價值的 RAG 系統與那些悄然削弱用戶信任的系統之間關鍵差異大多數企業級檢索增強生成(RAG)系統僅能檢索到客戶的瞬間快照:例如上週
相關專題推薦
寫作
 最佳 AI 編輯工具,助您撰寫清晰明瞭的商務文書
2026 年最新、最受好評的 AI 編輯工具,助您撰寫清晰明瞭的商務文案,盡在 XIX.AI!這份精心精選的清單收錄了強大且具顛覆性的解決方案,這些工具經過實際測試與嚴格評比,能助您大幅提升寫作效率。您還可參考免費版與付費版的比較,以挑選最適合您的工具。 立即探索,釋放您的 AI 優勢!
 10 個工具
 xix.ai
動畫創作
適用於短影片、廣告及遊戲預告片角色捕捉重定向的最佳 AI 動作清理工具
2026年最新、最優秀、評分最高的AI動作清理工具,專為短影片、廣告及遊戲預告片中的動作捕捉重定向任務設計!XIX.AI精心整理了一組極具顛覆性的工具合集,其中包含每週更新的排名榜單、免費版與付費版的對比資訊以及實際應用測試結果,助您找到能夠提升工作效率、激發創意潛能的理想解決方案。立即探索,為您尋找最適合實現完美動作編輯的工具。
9 個工具
xix.ai
漫畫創作
最佳用於連載故事的 AI 漫畫背景生成器
2026 年最新最佳頂級評分 AI 漫畫背景生成器,專為連載故事打造!此精選列表包含功能強大的變革性工具,幫助創作者快速製作令人驚歎的視覺內容,顯著提升生產力。每個選項均經過實際測試,以確保卓越品質。檢視免費與付費對比及排名,找到最適合您的方案。立即訪問 XIX.AI,解鎖您在漫畫創作中的 AI 優勢。
9 個工具
xix.ai
聊天機器人
最佳 AI 聊天夥伴:具備長期記憶,能進行自然對話
《2026 年最新最佳 AI 聊天伴侶排行榜》精選了廣受好評且功能強大的工具,這些工具以能夠進行自然對話並具備長期記憶能力而聞名。這份精心策劃的清單涵蓋了免費與付費層級中必試的選項,並經由實際測試驗證,且排行榜每週更新。XIX.AI 在這份精英名單中脫穎而出,成為值得信賴的首選。 立即探索,發掘最適合您的 AI 聊天夥伴,並從今天起釋放您的生產力優勢。
11 個工具
xix.ai
動畫創作
最佳 AI 動畫生成器:快速將創意轉化為動態影片片段
2026 年最新、最受好評的頂級 AI 動畫生成器!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,助您迅速將創意構想轉化為高品質的動態影片片段。 每項選項均經過嚴格的實際環境測試,並提供詳盡的免費版與付費版比較分析,以及每週更新的排行榜,助您找到最適合提升動畫製作效率的工具。立即探索,釋放您的 AI 優勢!
11 個工具
xix.ai
文字轉語音
頂尖的多語言 AI 語音生成器:大規模進行音訊在地化
2026 年最新評分最高的多語言 AI 語音生成器精選清單,專為大規模音訊在地化而設計。這份精心挑選的清單收錄了多款強大且具革命性的工具,能快速產出高品質的在地化音訊。每項選項均經過嚴格的實際環境測試,以確保其可靠性。 查看免費版與付費版的比較,找出最適合您專案的解決方案。立即前往 XIX.AI 探索,釋放您的 AI 競爭優勢。
18 個工具
xix.ai

 評論 (0)
0/500
DeepSeek 已在 Hugging Face 上發布 DeepSeek-V4-Flash-Vision-Exp,這標誌著 V4 系列中首個採用 MIT 授權的多模態實驗性模型正式亮相。 該模型擁有 3050 億個參數,並基於 V4-Flash-0731 基礎模型打造,將視覺編碼器和 Aligner 整合至其核心語言架構中,透過持續訓練實現穩健的圖像理解能力。
鎖定多模態代理,而不僅是圖像描述
有別於專注於視覺問答的傳統多模態模型,DeepSeek 重新定義了 Vision 版本的宗旨:優先考量多模態代理人的能力。 官方文件強調,代理程式能直接解讀視覺輸入(例如網頁截圖、軟體介面及圖表),並透過調用工具來執行任務。本質上,這對「眼睛」是專為機器代理程式設計,而非人類使用者。
這個開源套件內容完整,包含模型權重、Tokenizer、提示編碼參考實作,以及最簡化的 PyTorch 推論設定。它涵蓋了視覺編碼器、Aligner、DFlash Attention、MoE 和 Hyper-Connections 等核心模組。 社群反應迅速,Hugging Face 上已提供七種針對 llama.cpp、LM Studio 及 Ollama 的量化版本。
值得注意的時間軸細節顯示出其策略性的推出方式:該模型於 8 月 21 日首度現身於 DeepSeek API 上,當時僅能透過 API 存取,且未提供模型權重分發。 開發者可同時輸入文字與圖像,圖像處理費用按代號計費。十天後,權重正式發布,使本地部署與二次開發成為可能。這種「先 API,後開源」的策略,凸顯了 DeepSeek 作為 API 服務提供者的核心定位。
效能接近 Claude Opus 4.8,並經官方實測驗證
基準測試結果顯示,新增視覺能力並未顯著影響純文字代理的表現:Terminal Bench 2.1 分數從 82.7 上升至 83.9,DeepSWE 分數則從 54.4 提升至 59.3,超越了 Opus 4.8 的 58.0。 多模態代理的提升更為顯著:ApexBench Pass@1 達 36.5, Agents' Last Exam 達 27.3(超越 Opus 4.8 的 25.7),而 ZeroBench Pass@5 則達 35.0,表現優於競爭對手的 34.0。
然而,DeepSeek 並未宣稱具備「全面優勢」:在 NL2Repo 專案中,其得分為 57.7,落後於 Opus 4.8 的 69.7。 官方聲明仍持謹慎態度,僅指出「多模態代理能力已接近 Claude Opus 4.8」。 近期更新顯示,DeepSeek 正逐步建構完整的代理技術堆疊:該模型負責推理與工具調用,Harness 管理持續的任務執行,而 Vision 則使代理能夠直接解讀電腦視覺資訊。此次開源發布是完善此生態系統的關鍵一步。








 美國衛生機構評估 OpenAI 和 Anthropic 的 AI 模型
全美各地的公共衛生機構將透過「健康人工智慧聯盟」(Coalition for Health AI)主導、並與 OpenAI、Anthropic 及埃森哲(Accenture)合作的新計畫,對生成式人工智慧進行評估。「公共衛生應用案例與學習擴展引擎」(PULSE)將資助橫跨 10 個州、地方、部落及轄區的試驗計畫。這項計畫旨在為正考慮部署類似人工智慧系統的公共衛生組織,制定可付諸實行的實施指引。Op
 支付寶的「一觸即付」服務將把 3,000 萬個線下接觸點轉化為一個由人工智慧驅動的商業網絡
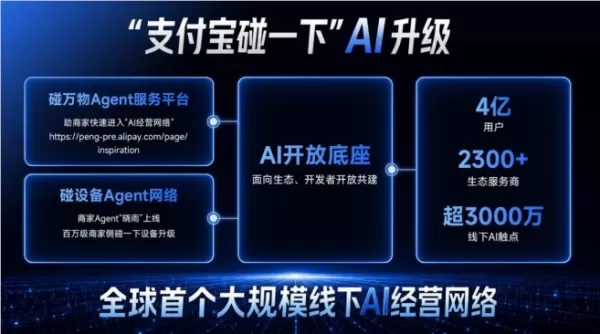
繼推出全棧式 AI 支付系統及由 AI 驅動的支付寶助手「阿寶」後,支付寶於 7 月 8 日宣布,其「一觸即付」解決方案已完成全面的人工智慧升級。 部署於各商家、數量達數百萬台的「一觸即付」終端機已轉型為「一觸即付終端代理」,同時,支付寶也針對中小企業推出了「一觸萬物代理」服務平台,並同步推出「AI開放基地」。 歷經兩年密集開發,「一觸即付」現已服務4億用戶,與2,300家生態系服務供應商合作,並
 Tealium:為何 RAG 品質取決於即時資料
Tealium 應用人工智慧部門首席產品經理弗雷迪·貝蘭蒂(Freddy Berlanti)深入探討檢索增強生成(RAG)技術。圖片來源:Getty ImagesTealium 應用人工智慧部門首席產品經理弗雷迪·伯蘭蒂(Freddy Berlanti),剖析了能創造價值的 RAG 系統與那些悄然削弱用戶信任的系統之間關鍵差異大多數企業級檢索增強生成(RAG)系統僅能檢索到客戶的瞬間快照:例如上週

2026 年最新、最受好評的 AI 編輯工具,助您撰寫清晰明瞭的商務文案,盡在 XIX.AI!這份精心精選的清單收錄了強大且具顛覆性的解決方案,這些工具經過實際測試與嚴格評比,能助您大幅提升寫作效率。您還可參考免費版與付費版的比較,以挑選最適合您的工具。 立即探索,釋放您的 AI 優勢!
10 個工具
xix.ai

2026年最新、最優秀、評分最高的AI動作清理工具,專為短影片、廣告及遊戲預告片中的動作捕捉重定向任務設計!XIX.AI精心整理了一組極具顛覆性的工具合集,其中包含每週更新的排名榜單、免費版與付費版的對比資訊以及實際應用測試結果,助您找到能夠提升工作效率、激發創意潛能的理想解決方案。立即探索,為您尋找最適合實現完美動作編輯的工具。
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 漫畫背景生成器,專為連載故事打造!此精選列表包含功能強大的變革性工具,幫助創作者快速製作令人驚歎的視覺內容,顯著提升生產力。每個選項均經過實際測試,以確保卓越品質。檢視免費與付費對比及排名,找到最適合您的方案。立即訪問 XIX.AI,解鎖您在漫畫創作中的 AI 優勢。
9 個工具
xix.ai

《2026 年最新最佳 AI 聊天伴侶排行榜》精選了廣受好評且功能強大的工具,這些工具以能夠進行自然對話並具備長期記憶能力而聞名。這份精心策劃的清單涵蓋了免費與付費層級中必試的選項,並經由實際測試驗證,且排行榜每週更新。XIX.AI 在這份精英名單中脫穎而出,成為值得信賴的首選。 立即探索,發掘最適合您的 AI 聊天夥伴,並從今天起釋放您的生產力優勢。
11 個工具
xix.ai
2026 年最新、最受好評的頂級 AI 動畫生成器!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,助您迅速將創意構想轉化為高品質的動態影片片段。 每項選項均經過嚴格的實際環境測試,並提供詳盡的免費版與付費版比較分析,以及每週更新的排行榜,助您找到最適合提升動畫製作效率的工具。立即探索,釋放您的 AI 優勢!
11 個工具
xix.ai
2026 年最新評分最高的多語言 AI 語音生成器精選清單,專為大規模音訊在地化而設計。這份精心挑選的清單收錄了多款強大且具革命性的工具,能快速產出高品質的在地化音訊。每項選項均經過嚴格的實際環境測試,以確保其可靠性。 查看免費版與付費版的比較,找出最適合您專案的解決方案。立即前往 XIX.AI 探索,釋放您的 AI 競爭優勢。
18 個工具
xix.ai












