


 Maison
DeepSeek dévoile le premier modèle multimodal open source conçu pour les agents IA
DeepSeek a publié DeepSeek-V4-Flash-Vision-Exp sur Hugging Face, marquant ainsi le lancement du premier modèle multimodal expérimental de la série V4 sous licence MIT. Avec 305 milliards de paramètres et s’appuyant sur la base V4-Flash-0731, ce modèle intègre un encodeur visuel et un Aligner au cœur de son architecture linguistique, permettant une compréhension robuste des images grâce à un apprentissage continu.
Cibler les agents multimodaux, et pas seulement la description d’images
Contrairement aux modèles multimodaux traditionnels axés sur la réponse à des questions visuelles, DeepSeek a redéfini l’objectif de la version Vision : donner la priorité aux capacités des agents multimodaux. La documentation officielle souligne que les agents peuvent interpréter directement des entrées visuelles — telles que des captures d’écran Web, des interfaces logicielles et des graphiques — et exécuter des tâches en invoquant des outils. En substance, cet « œil » est conçu pour des agents automatisés plutôt que pour des utilisateurs humains.
Le package open source est complet : il comprend les poids du modèle, un tokeniseur, des implémentations de référence pour le Prompt Encoding, ainsi qu’une configuration minimale d’inférence PyTorch. Il couvre les modules essentiels, notamment l’encodeur visuel, l’Aligner, le DFlash Attention, le MoE et les Hyper-Connections. La communauté a réagi rapidement : sept versions quantifiées sont d’ores et déjà disponibles sur Hugging Face pour llama.cpp, LM Studio et Ollama.
Certains détails notables du calendrier révèlent un déploiement stratégique : le modèle est d’abord apparu sur l’API DeepSeek le 21 août, accessible uniquement via l’API sans distribution des poids. Les développeurs pouvaient saisir simultanément du texte et des images, le traitement des images étant facturé au token. Dix jours plus tard, les poids ont été officiellement publiés, permettant ainsi un déploiement local et un développement secondaire. Cette stratégie « API d’abord, puis open source » souligne le positionnement principal de DeepSeek en tant que fournisseur de services API.
Des performances proches de celles de Claude Opus 4.8, avec des résultats officiels mesurés
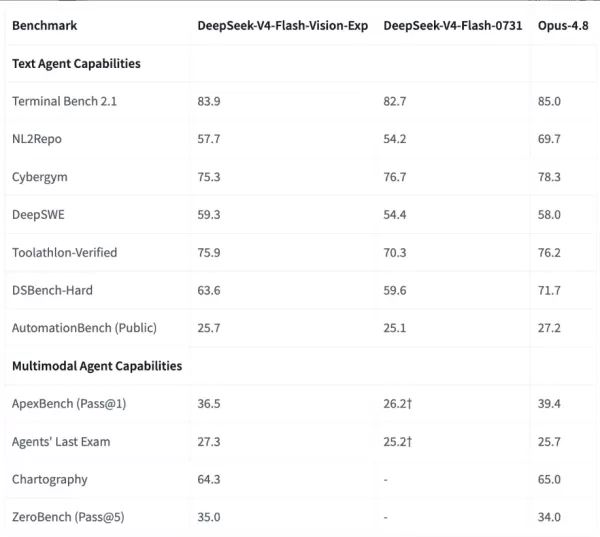
Les résultats des tests de performance indiquent que l’ajout de capacités visuelles ne compromet pas de manière significative les performances de l’agent textuel pur : les scores au Terminal Bench 2.1 sont passés de 82,7 à 83,9, et ceux de DeepSWE sont passés de 54,4 à 59,3, dépassant ainsi les 58,0 d’Opus 4.8. Les améliorations des agents multimodaux sont plus marquées : ApexBench Pass@1 a atteint 36,5, le score de l’« Agents’ Last Exam » s’est établi à 27,3 (dépassant les 25,7 d’Opus 4.8), et le score de ZeroBench Pass@5 a atteint 35,0, surpassant les 34,0 du concurrent.
Cependant, DeepSeek évite de revendiquer une « supériorité globale » : sur le projet NL2Repo, il a obtenu un score de 57,7, derrière les 69,7 d’Opus 4.8. Le communiqué officiel reste mesuré, se contentant de noter que « les capacités des agents multimodaux sont proches de celles de Claude Opus 4.8 ». Des mises à jour récentes montrent que DeepSeek met en place une pile technologique complète pour les agents : le modèle gère le raisonnement et les appels d’outils, Harness gère l’exécution continue des tâches, et Vision permet aux agents d’interpréter directement les informations visuelles provenant de l’ordinateur. Cette version open source constitue une étape cruciale dans la mise en place de cet écosystème.
Article connexe
 Les autorités sanitaires américaines évaluent les modèles d'IA d'OpenAI et d'Anthropic
Les agences de santé publique à l'échelle nationale s'apprêtent à évaluer l'IA générative dans le cadre d'une nouvelle initiative menée par la Coalition for Health AI, en partenari
La solution « Touch and Pay » d'Alipay va transformer 30 millions de points de vente physiques en un réseau commercial piloté par l'IA
Après le lancement d’un système de paiement entièrement basé sur l’IA et de l’assistant Alipay « Abao », alimenté par l’IA, Alipay a annoncé le 8 juillet que sa solution « Touch and Pay » avait fait l
Tealium : Pourquoi la qualité du RAG dépend des données en temps réel
Freddy Berlanti, chef de produit principal en IA appliquée chez Tealium, explore la génération augmentée par la recherche (RAG). Image : Getty ImagesFreddy Berlanti, chef de produit principal en IA ap
Recommandations de sujets spéciaux liés
en écrivant
 Meilleurs outils d’édition par IA pour un écrit professionnel clair
Les meilleures outils d’édition par IA de 2026, hautement notés et conçus pour un écrit professionnel clair, sont disponibles sur XIX.AI ! Cette liste rigoureusement sélectionnée présente des solutions puissantes capables de transformer votre façon de travailler, vous permettant d’améliorer considérablement l’efficacité de votre rédaction grâce à des tests en conditions réelles et à une évaluation approfondie. Vous y trouverez également une comparaison entre les versions gratuites et payantes afin de choisir celle qui correspond le mieux à vos besoins. Découvrez-les dès maintenant et tirez parti de l’avantage offert par l’IA !
 10 outils
 xix.ai
Création d'animations
Meilleurs outils d’édition de mouvements par IA pour le retargeting de mocap dans les vidéos Shorts, les publicités et les bandes-annonces de jeux
Les meilleures outils d’édition de mouvement par IA les plus récents et hautement notés en 2026 pour le retargeting via mocap dans les vidéos Shorts, les publicités et les trailers de jeux ! XIX.AI a sélectionné une collection révolutionnaire, mise à jour chaque semaine, comprenant des comparaisons entre versions gratuites et payantes ainsi que des tests pratiques, afin de vous aider à trouver la solution idéale qui améliorera votre productivité et libérera tout votre potentiel créatif. Découvrez dès maintenant l’outil parfait pour des montages de mouvement sans défaut.
9 outils
xix.ai
Création de bande dessinée
Meilleurs générateurs d'arrière-plans de manga par IA pour les histoires sérialisées
2026 Derniers Meilleurs Générateurs de Fonds de Manga par IA les mieux notés pour les Histoires Sérialisées ! Cette liste soigneusement sélectionnée présente des outils puissants qui changent la donne, aidant les créateurs à concevoir rapidement du contenu visuel époustouflant, augmentant considérablement leur productivité. Chaque option a été testée dans des conditions réelles pour garantir une qualité optimale. Consultez la comparaison entre les versions gratuites et payantes ainsi que les classements pour trouver celle qui vous convient parfaitement. Explorez dès maintenant sur XIX.AI pour débloquer votre avantage IA dans la création de manga.
9 outils
xix.ai
chatbot
Les meilleurs assistants de chat basés sur l'IA : engagez des conversations naturelles grâce à leur mémoire à long terme
Le classement 2026 des meilleurs assistants conversationnels IA présente des outils performants et très bien notés, réputés pour leur capacité à mener des conversations naturelles et à conserver une mémoire à long terme. Cette sélection comprend des options incontournables, tant gratuites que payantes, validées par des tests en conditions réelles et un classement mis à jour chaque semaine. XIX.AI s'impose comme un choix de confiance au sein de cette sélection d'élite. Découvrez dès maintenant l’assistant de chat IA qui vous convient le mieux et boostez votre productivité dès aujourd’hui.
11 outils
xix.ai
Création d'animations
Meilleurs générateurs d’animation par IA : transformez vos idées en clips animés rapidement
2026 Dernières Meilleures Générateurs d'Animation IA les mieux notés ! XIX.AI sélectionne une collection puissante et révolutionnaire d'outils incontournables pour transformer rapidement vos idées créatives en clips animés de haute qualité. Chaque option a été soumise à des tests rigoureux en conditions réelles, avec des comparaisons détaillées entre les versions gratuite et payante, ainsi que des classements mis à jour chaque semaine pour vous aider à trouver la solution idéale afin d'optimiser votre productivité en animation. Explorez dès maintenant pour débloquer votre avantage par l'IA !
11 outils
xix.ai
Synthèse vocale
Les meilleurs générateurs de voix IA multilingues : localisation audio à grande échelle
2026 : les meilleurs générateurs vocaux IA multilingues les mieux notés pour la localisation audio à grande échelle. Cette sélection regroupe des outils puissants et révolutionnaires qui permettent d'obtenir rapidement un contenu audio localisé de haute qualité. Chaque option a été soumise à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez notre comparatif entre les versions gratuites et payantes et découvrez la solution idéale pour vos projets. Découvrez-les dès maintenant sur XIX.AI pour tirer pleinement parti de l'IA.
18 outils
xix.ai

 commentaires (0)
DeepSeek a publié DeepSeek-V4-Flash-Vision-Exp sur Hugging Face, marquant ainsi le lancement du premier modèle multimodal expérimental de la série V4 sous licence MIT. Avec 305 milliards de paramètres et s’appuyant sur la base V4-Flash-0731, ce modèle intègre un encodeur visuel et un Aligner au cœur de son architecture linguistique, permettant une compréhension robuste des images grâce à un apprentissage continu.
Cibler les agents multimodaux, et pas seulement la description d’images
Contrairement aux modèles multimodaux traditionnels axés sur la réponse à des questions visuelles, DeepSeek a redéfini l’objectif de la version Vision : donner la priorité aux capacités des agents multimodaux. La documentation officielle souligne que les agents peuvent interpréter directement des entrées visuelles — telles que des captures d’écran Web, des interfaces logicielles et des graphiques — et exécuter des tâches en invoquant des outils. En substance, cet « œil » est conçu pour des agents automatisés plutôt que pour des utilisateurs humains.
Le package open source est complet : il comprend les poids du modèle, un tokeniseur, des implémentations de référence pour le Prompt Encoding, ainsi qu’une configuration minimale d’inférence PyTorch. Il couvre les modules essentiels, notamment l’encodeur visuel, l’Aligner, le DFlash Attention, le MoE et les Hyper-Connections. La communauté a réagi rapidement : sept versions quantifiées sont d’ores et déjà disponibles sur Hugging Face pour llama.cpp, LM Studio et Ollama.
Certains détails notables du calendrier révèlent un déploiement stratégique : le modèle est d’abord apparu sur l’API DeepSeek le 21 août, accessible uniquement via l’API sans distribution des poids. Les développeurs pouvaient saisir simultanément du texte et des images, le traitement des images étant facturé au token. Dix jours plus tard, les poids ont été officiellement publiés, permettant ainsi un déploiement local et un développement secondaire. Cette stratégie « API d’abord, puis open source » souligne le positionnement principal de DeepSeek en tant que fournisseur de services API.
Des performances proches de celles de Claude Opus 4.8, avec des résultats officiels mesurés
Les résultats des tests de performance indiquent que l’ajout de capacités visuelles ne compromet pas de manière significative les performances de l’agent textuel pur : les scores au Terminal Bench 2.1 sont passés de 82,7 à 83,9, et ceux de DeepSWE sont passés de 54,4 à 59,3, dépassant ainsi les 58,0 d’Opus 4.8. Les améliorations des agents multimodaux sont plus marquées : ApexBench Pass@1 a atteint 36,5, le score de l’« Agents’ Last Exam » s’est établi à 27,3 (dépassant les 25,7 d’Opus 4.8), et le score de ZeroBench Pass@5 a atteint 35,0, surpassant les 34,0 du concurrent.
Cependant, DeepSeek évite de revendiquer une « supériorité globale » : sur le projet NL2Repo, il a obtenu un score de 57,7, derrière les 69,7 d’Opus 4.8. Le communiqué officiel reste mesuré, se contentant de noter que « les capacités des agents multimodaux sont proches de celles de Claude Opus 4.8 ». Des mises à jour récentes montrent que DeepSeek met en place une pile technologique complète pour les agents : le modèle gère le raisonnement et les appels d’outils, Harness gère l’exécution continue des tâches, et Vision permet aux agents d’interpréter directement les informations visuelles provenant de l’ordinateur. Cette version open source constitue une étape cruciale dans la mise en place de cet écosystème.








 Les autorités sanitaires américaines évaluent les modèles d'IA d'OpenAI et d'Anthropic
Les agences de santé publique à l'échelle nationale s'apprêtent à évaluer l'IA générative dans le cadre d'une nouvelle initiative menée par la Coalition for Health AI, en partenari
 La solution « Touch and Pay » d'Alipay va transformer 30 millions de points de vente physiques en un réseau commercial piloté par l'IA
Après le lancement d’un système de paiement entièrement basé sur l’IA et de l’assistant Alipay « Abao », alimenté par l’IA, Alipay a annoncé le 8 juillet que sa solution « Touch and Pay » avait fait l
 Tealium : Pourquoi la qualité du RAG dépend des données en temps réel
Freddy Berlanti, chef de produit principal en IA appliquée chez Tealium, explore la génération augmentée par la recherche (RAG). Image : Getty ImagesFreddy Berlanti, chef de produit principal en IA ap

Les meilleures outils d’édition par IA de 2026, hautement notés et conçus pour un écrit professionnel clair, sont disponibles sur XIX.AI ! Cette liste rigoureusement sélectionnée présente des solutions puissantes capables de transformer votre façon de travailler, vous permettant d’améliorer considérablement l’efficacité de votre rédaction grâce à des tests en conditions réelles et à une évaluation approfondie. Vous y trouverez également une comparaison entre les versions gratuites et payantes afin de choisir celle qui correspond le mieux à vos besoins. Découvrez-les dès maintenant et tirez parti de l’avantage offert par l’IA !
10 outils
xix.ai

Les meilleures outils d’édition de mouvement par IA les plus récents et hautement notés en 2026 pour le retargeting via mocap dans les vidéos Shorts, les publicités et les trailers de jeux ! XIX.AI a sélectionné une collection révolutionnaire, mise à jour chaque semaine, comprenant des comparaisons entre versions gratuites et payantes ainsi que des tests pratiques, afin de vous aider à trouver la solution idéale qui améliorera votre productivité et libérera tout votre potentiel créatif. Découvrez dès maintenant l’outil parfait pour des montages de mouvement sans défaut.
9 outils
xix.ai

2026 Derniers Meilleurs Générateurs de Fonds de Manga par IA les mieux notés pour les Histoires Sérialisées ! Cette liste soigneusement sélectionnée présente des outils puissants qui changent la donne, aidant les créateurs à concevoir rapidement du contenu visuel époustouflant, augmentant considérablement leur productivité. Chaque option a été testée dans des conditions réelles pour garantir une qualité optimale. Consultez la comparaison entre les versions gratuites et payantes ainsi que les classements pour trouver celle qui vous convient parfaitement. Explorez dès maintenant sur XIX.AI pour débloquer votre avantage IA dans la création de manga.
9 outils
xix.ai

Le classement 2026 des meilleurs assistants conversationnels IA présente des outils performants et très bien notés, réputés pour leur capacité à mener des conversations naturelles et à conserver une mémoire à long terme. Cette sélection comprend des options incontournables, tant gratuites que payantes, validées par des tests en conditions réelles et un classement mis à jour chaque semaine. XIX.AI s'impose comme un choix de confiance au sein de cette sélection d'élite. Découvrez dès maintenant l’assistant de chat IA qui vous convient le mieux et boostez votre productivité dès aujourd’hui.
11 outils
xix.ai
2026 Dernières Meilleures Générateurs d'Animation IA les mieux notés ! XIX.AI sélectionne une collection puissante et révolutionnaire d'outils incontournables pour transformer rapidement vos idées créatives en clips animés de haute qualité. Chaque option a été soumise à des tests rigoureux en conditions réelles, avec des comparaisons détaillées entre les versions gratuite et payante, ainsi que des classements mis à jour chaque semaine pour vous aider à trouver la solution idéale afin d'optimiser votre productivité en animation. Explorez dès maintenant pour débloquer votre avantage par l'IA !
11 outils
xix.ai
2026 : les meilleurs générateurs vocaux IA multilingues les mieux notés pour la localisation audio à grande échelle. Cette sélection regroupe des outils puissants et révolutionnaires qui permettent d'obtenir rapidement un contenu audio localisé de haute qualité. Chaque option a été soumise à des tests rigoureux en conditions réelles afin de garantir sa fiabilité. Consultez notre comparatif entre les versions gratuites et payantes et découvrez la solution idéale pour vos projets. Découvrez-les dès maintenant sur XIX.AI pour tirer pleinement parti de l'IA.
18 outils
xix.ai












