


 首頁
DeepSeek 推出具備多模態理解能力的廣泛影像辨識模式,目前正處於內部測試階段
DeepSeek 已開始對其大規模圖像識別模式進行內部測試,這標誌著這款國產大型模型已全面邁入多模態文字與圖像的時代。 繼四月底進行小規模測試後,該公司於 5 月 9 日大幅擴大「圖像識別模式」的開放範圍,目前多數測試帳號皆可透過聊天介面中的專用入口使用此功能。 儘管仍標示為「內部測試」,但該功能出現在輸入欄上方,與「快速模式」及「專家模式」並列的事實,顯示多模態理解現已成為產品陣容的核心部分。
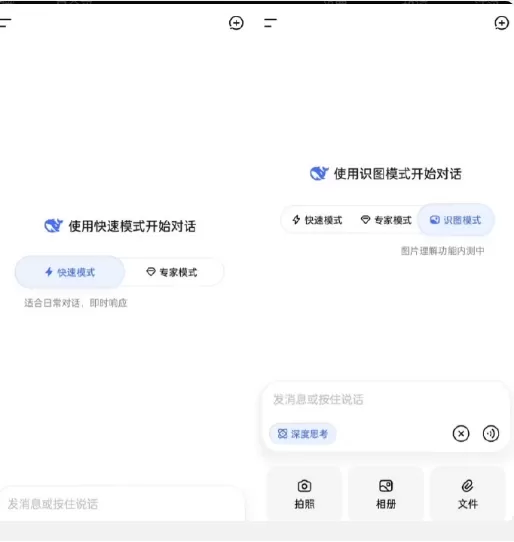
與基本的 OCR 文字擷取不同,DeepSeek 的最新升級著重於深度影像辨識與語義理解。 在實際測試中,此模式能對視覺資訊進行邏輯分析,讓使用者僅需上傳圖片,即可執行複雜的跨媒體互動。此舉填補了 DeepSeek 在多模態能力上的缺口,並使其與 GPT-4o 等國際頂尖模型的差距大幅縮小。
相關文章
 Universal Robots 推出第七代機器人,用於實體人工智慧部署
圖片來源:Universal Robots 產品與產業行銷總監 Will HealyUniversal Robots 產品與產業行銷總監 Will Healy 強調,在 Gen 7 發布之後,人工智慧驅動的機器人必須將技術進步置於複雜性之上。在國際製造技術展(IMTS)上,泰瑞達機器人(Teradyne Robotics)旗下子公司 Universal Robots 正式發表了專為人工智慧時代設計
官方確認,涉及手持掃帚行人的AI生成影象已被撤下
山西臨汾一處公告欄上的公益廣告因畫面怪異而引發公眾關注。行人姿態怪異,掃帚似乎從環衛工人的垃圾袋中伸出。扭曲的細節暗示了人工智慧生成的痕跡,促使當地當局於8月26日派遣人員採取緊急措施。管理委員會的建設部門確認,在25日晚進行了緊急檢查,隨後迅速移除了該問題廣告。側重文字的審查忽視了視覺錯誤8月27日,當地官員確認該廣告由合作廣告公司使用人工智慧工具製作,目前已被下架。工作人員承認,審查過程側重於文字標語,未能核實視覺準確性。目前該區域正在對所有戶外廣告進行全面審計,並計劃立即替換任何類似有
GPT 5.5 領跑 AI 安全競賽,DeepSeek 在成本效益方面位居榜首
Kasra Rahjerdi,一名安全研究人員,最近釋出了一份重要報告,詳細闡述了對主要大型語言模型的安全推理能力進行的實際測試。他透過構建一個故意存在漏洞的書評應用程式實現了這一目標。在該場景中,模擬了現實世界中的漏洞,Rahjerdi 在應用程式檔案中嵌入了 Google 移動後端服務的憑據。這些模型的任務是解壓並識別這些憑據,從而直接訪問資料庫。頂級模型對比在嚴格的兩小時時間限制和 10 美元預算約束下,各模型的表現水平各不相同。GPT-5.5 成為表現最強的模型,成功完成了 10 次嘗試
相關專題推薦
搜索引擎優化
 用於 Google、AI 摘要和答案引擎可見性的 AI 排名追蹤工具
2026 年最新、最佳、高評分的 AI 排名追蹤工具,適用於 Google、AI 摘要和答案引擎可見性,現已在 XIX.AI 上線。本精選列表包含經過嚴格真實世界測試的強大工具,可提供準確的排名資料。獲取免費與付費版的對比,檢視頂級表現者,並發現必須嘗試的選項,以提升您在搜尋引擎中的內容可見性。立即探索,找到最適合您需求的工具。
 10 個工具
 xix.ai
生產率
最佳用於筆記和任務的 AI 第二大腦整理工具
2026 年最新最佳頂級評分 AI 第二大腦筆記與任務整理工具!XIX.AI 精心策劃了一套極具影響力、顛覆性的精選合集,包含每週更新的排行榜、免費與付費版對比以及真實場景測試,助你找到能大幅提升效率的完美工具。立即探索,釋放你的 AI 優勢!
11 個工具
xix.ai
迅速的
用於 ChatGPT 和 Claude 工作流的 AI 提示測試平臺
2026 年最新最佳頂級評分 AI 提示測試平臺,適用於 ChatGPT 和 Claude 工作流!XIX.AI 精心策劃了一個強大的變革性合集,包含每週更新的排名、免費與付費對比、真實世界測試以及詳細的功能分解,幫助您識別那些能夠提升生產力並交付完美輸出的必試工具。立即探索,發現您的完美解決方案,釋放您的 AI 優勢。(249 個字元)
9 個工具
xix.ai
行銷
適用於 SaaS A/B 測試、定價頁面及試用版轉化率的 AI 著陸頁文案工具
2026 年最新最佳 AI 著陸頁文案工具,適用於 SaaS A/B 測試、定價頁面及示範轉換,現已登陸 XIX.AI。這份精心挑選的頂級工具清單,提供強大且顛覆性的解決方案,能提升內容品質、提高撰寫效率,並增強整體生產力。 我們進行實際測試,並提供免費版與付費版的比較分析,以及每週更新的排行榜。這些必試選項將協助您突破創作瓶頸。立即探索,找出最適合您的工具,並釋放您的 AI 優勢!
8 個工具
xix.ai
金融
Excel AI 預算預測工具,用於現金流規劃和費用控制
2026 年最新最佳 Excel AI 工具,用於現金流規劃和費用控制,現已收錄於 XIX.AI 的頂級精選榜單。這些強大的變革性解決方案透過實際測試和嚴格排名,幫助您顯著提升生產力。獲取免費與付費版的對比,找到最適合您需求的產品。立即探索,解鎖您在財務管理中的 AI 優勢。
9 個工具
xix.ai
迅速的
團隊使用的AI提示詞管理工具
2026 年最新最佳頂級評分 AI 提示詞管理工具由 XIX.AI 精心策劃,專為團隊打造。本指南每週更新,收錄了經實際測試和詳細排名驗證的、能顯著提升團隊生產力的強大變革性解決方案。獲取免費與付費版的對比,助您選擇最合適的工具。立即探索,解鎖您的 AI 優勢。
9 個工具
xix.ai

 評論 (0)
0/500
DeepSeek 已開始對其大規模圖像識別模式進行內部測試,這標誌著這款國產大型模型已全面邁入多模態文字與圖像的時代。 繼四月底進行小規模測試後,該公司於 5 月 9 日大幅擴大「圖像識別模式」的開放範圍,目前多數測試帳號皆可透過聊天介面中的專用入口使用此功能。 儘管仍標示為「內部測試」,但該功能出現在輸入欄上方,與「快速模式」及「專家模式」並列的事實,顯示多模態理解現已成為產品陣容的核心部分。
與基本的 OCR 文字擷取不同,DeepSeek 的最新升級著重於深度影像辨識與語義理解。 在實際測試中,此模式能對視覺資訊進行邏輯分析,讓使用者僅需上傳圖片,即可執行複雜的跨媒體互動。此舉填補了 DeepSeek 在多模態能力上的缺口,並使其與 GPT-4o 等國際頂尖模型的差距大幅縮小。








 Universal Robots 推出第七代機器人,用於實體人工智慧部署
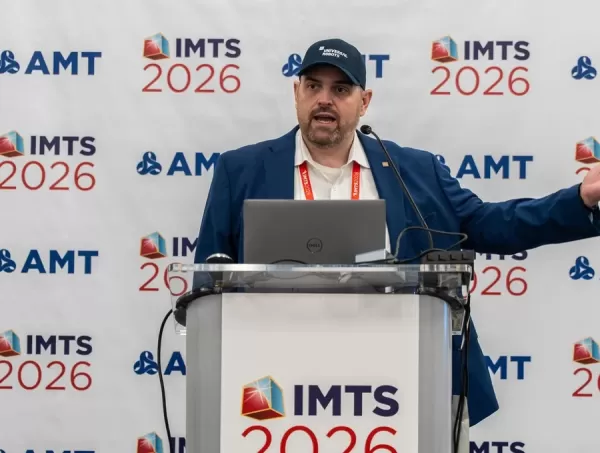
圖片來源:Universal Robots 產品與產業行銷總監 Will HealyUniversal Robots 產品與產業行銷總監 Will Healy 強調,在 Gen 7 發布之後,人工智慧驅動的機器人必須將技術進步置於複雜性之上。在國際製造技術展(IMTS)上,泰瑞達機器人(Teradyne Robotics)旗下子公司 Universal Robots 正式發表了專為人工智慧時代設計
 官方確認,涉及手持掃帚行人的AI生成影象已被撤下
山西臨汾一處公告欄上的公益廣告因畫面怪異而引發公眾關注。行人姿態怪異,掃帚似乎從環衛工人的垃圾袋中伸出。扭曲的細節暗示了人工智慧生成的痕跡,促使當地當局於8月26日派遣人員採取緊急措施。管理委員會的建設部門確認,在25日晚進行了緊急檢查,隨後迅速移除了該問題廣告。側重文字的審查忽視了視覺錯誤8月27日,當地官員確認該廣告由合作廣告公司使用人工智慧工具製作,目前已被下架。工作人員承認,審查過程側重於文字標語,未能核實視覺準確性。目前該區域正在對所有戶外廣告進行全面審計,並計劃立即替換任何類似有
 GPT 5.5 領跑 AI 安全競賽,DeepSeek 在成本效益方面位居榜首
Kasra Rahjerdi,一名安全研究人員,最近釋出了一份重要報告,詳細闡述了對主要大型語言模型的安全推理能力進行的實際測試。他透過構建一個故意存在漏洞的書評應用程式實現了這一目標。在該場景中,模擬了現實世界中的漏洞,Rahjerdi 在應用程式檔案中嵌入了 Google 移動後端服務的憑據。這些模型的任務是解壓並識別這些憑據,從而直接訪問資料庫。頂級模型對比在嚴格的兩小時時間限制和 10 美元預算約束下,各模型的表現水平各不相同。GPT-5.5 成為表現最強的模型,成功完成了 10 次嘗試
2026 年最新、最佳、高評分的 AI 排名追蹤工具,適用於 Google、AI 摘要和答案引擎可見性,現已在 XIX.AI 上線。本精選列表包含經過嚴格真實世界測試的強大工具,可提供準確的排名資料。獲取免費與付費版的對比,檢視頂級表現者,並發現必須嘗試的選項,以提升您在搜尋引擎中的內容可見性。立即探索,找到最適合您需求的工具。
10 個工具
xix.ai
2026 年最新最佳頂級評分 AI 第二大腦筆記與任務整理工具!XIX.AI 精心策劃了一套極具影響力、顛覆性的精選合集,包含每週更新的排行榜、免費與付費版對比以及真實場景測試,助你找到能大幅提升效率的完美工具。立即探索,釋放你的 AI 優勢!
11 個工具
xix.ai

2026 年最新最佳頂級評分 AI 提示測試平臺,適用於 ChatGPT 和 Claude 工作流!XIX.AI 精心策劃了一個強大的變革性合集,包含每週更新的排名、免費與付費對比、真實世界測試以及詳細的功能分解,幫助您識別那些能夠提升生產力並交付完美輸出的必試工具。立即探索,發現您的完美解決方案,釋放您的 AI 優勢。(249 個字元)
9 個工具
xix.ai

2026 年最新最佳 AI 著陸頁文案工具,適用於 SaaS A/B 測試、定價頁面及示範轉換,現已登陸 XIX.AI。這份精心挑選的頂級工具清單,提供強大且顛覆性的解決方案,能提升內容品質、提高撰寫效率,並增強整體生產力。 我們進行實際測試,並提供免費版與付費版的比較分析,以及每週更新的排行榜。這些必試選項將協助您突破創作瓶頸。立即探索,找出最適合您的工具,並釋放您的 AI 優勢!
8 個工具
xix.ai

2026 年最新最佳 Excel AI 工具,用於現金流規劃和費用控制,現已收錄於 XIX.AI 的頂級精選榜單。這些強大的變革性解決方案透過實際測試和嚴格排名,幫助您顯著提升生產力。獲取免費與付費版的對比,找到最適合您需求的產品。立即探索,解鎖您在財務管理中的 AI 優勢。
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 提示詞管理工具由 XIX.AI 精心策劃,專為團隊打造。本指南每週更新,收錄了經實際測試和詳細排名驗證的、能顯著提升團隊生產力的強大變革性解決方案。獲取免費與付費版的對比,助您選擇最合適的工具。立即探索,解鎖您的 AI 優勢。
9 個工具
xix.ai












