


 首頁
如何輕鬆製作會唱歌的 AI 虛擬人偶:完整的新手指南
人工智慧正在徹底改變數位內容的創作,特別是透過人工智慧驅動的歌唱虛擬人偶,提供非常逼真的表演。透過 Hedra AI 等直覺式平台,任何人現在都可以製作客製化的數位表演者,並提供精準的口型同步 - 不需要專業技術。這套全面的教學將引導您完成製作引人入勝的 AI 聲音虛擬人偶的每個步驟,適用於行銷、教育、娛樂等領域。
重點
無障礙的虛擬人偶製作:現代平台透過友善的工作流程將數位表演者的開發民主化。
迅速的製作要點:詳細的文字描述可顯著影響虛擬人像的品質與逼真度。
音訊最佳化:高品質的聲音音軌可確保自然的嘴部動作與表情。
創意自訂:從動畫到逼真的角色,您可以嘗試各種不同的視覺風格。
多產業應用:這些工具可為行銷、教育、客戶服務和娛樂領域的內容創作者提供服務。
AI 歌唱虛擬人偶簡介
了解數位聲樂表演者
AI 歌唱虛擬人偶是合成媒體的一項突破,結合了電腦產生的影像與先進的語音同步技術。這些數位表演者一開始是以文字為基礎的角色描述,然後由 AI 轉換成可視化的表現。當搭配音軌 (無論是錄音或 AI 產生的) 時,精密的演算法會將虛擬人偶的臉部特徵製成動畫,以令人信服的精確度來搭配聲樂表演。
這項技術的多樣性為眾多應用打開了大門。行銷人員可以開發品牌虛擬代言人、教育工作者可以創造動畫導師、藝人可以製作虛擬樂團或數位影響力。Hedra AI 等平台可透過直覺式介面簡化製作過程,從概念到最終產品都能引導使用者,無須動畫專業知識。
超越傳統動畫的優勢
與傳統動畫技術相比,AI 驅動的虛擬人像創作提供了明顯的優勢:
- 時間效率:將製作時間從數週縮短至數小時
- 預算輕鬆:省去昂貴的動畫工作室成本
- 創意自由:快速迭代角色設計
- 無障礙:使用者友善的平台,無需專業訓練
- 一致性:在多個虛擬人偶中維持一致的品質
製作高品質的 AI 頭像
掌握文字提示
出色的虛擬人偶生成始於詳細的描述性提示。考慮這些最佳做法:
- 指定視覺細節(髮型、衣服、臉部特徵)
- 包含藝術風格偏好(動畫、3D、逼真)
- 透過身體屬性描述個性特徵
- 參考光線條件和背景元素
- 使用比較性語言 (「像年輕的 David Bowie」)
改善範例:
基本:「創造一個女孩
增強型:「產生一個生氣勃勃的動漫角色,她扎著彩虹般的辮子,穿著皮夾克和霓虹吊飾,投擲岩石角,手上散發著電一般的能量」
優化音訊輸入
自然的唇語同步需要仔細的音訊準備:
- 在經過聲學處理的空間中使用專業麥克風錄音
- 在整個錄音過程中保持一致的音量和音調
- 在短語之間加入自然的停頓,以提供呼吸空間
- 考慮與化身外觀相符的聲音特徵
- 使用降噪工具消除背景雜訊
使用 Hedra AI 分步創作
平台導覽
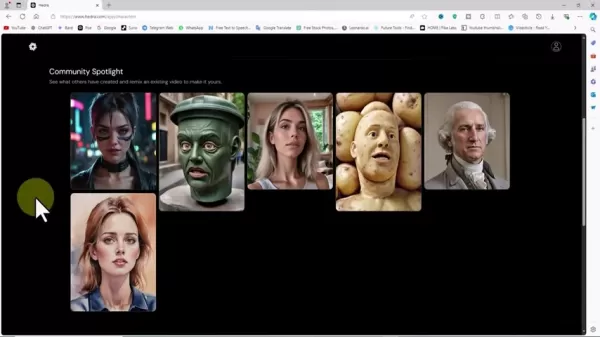
- 透過 Hedra AI 官方網站存取
- 使用您偏好的憑證註冊
- 探索測試版儀表板介面
三個核心工作流程面板
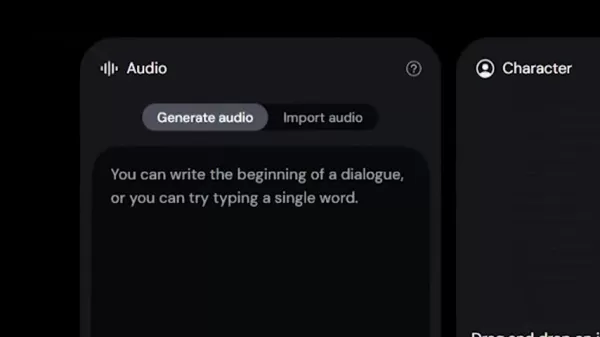
- 音訊模組:上傳錄音或產生合成人聲
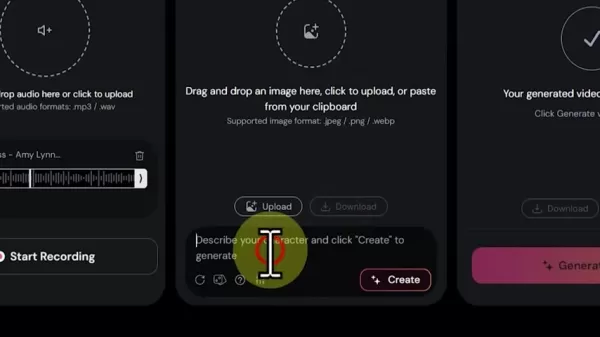
- 角色生成器:透過文字提示或圖片上傳設計頭像
- 視訊產生器:結合元素並呈現最終輸出
音訊整合流程
- 選擇音訊來源 (檔案上傳/錄音/TTS 轉換)
- 針對 TTS:輸入文字(300 字元限制)並選擇語音設定檔
- 用於上傳:使用以 44.1kHz 或更高頻率錄製的 MP3/WAV 檔案
- 調整時序標記以獲得精確的同步點
視覺設計階段
- 選擇圖片上傳或 AI 產生
- 針對 AI 創作:輸入詳細的角色描述
- 利用種子隨機化進行變體探索
- 調整生成參數以完善風格
最終渲染
- 預覽同步精確度
- 必要時調整時間偏移
- 以最佳解析度渲染專案
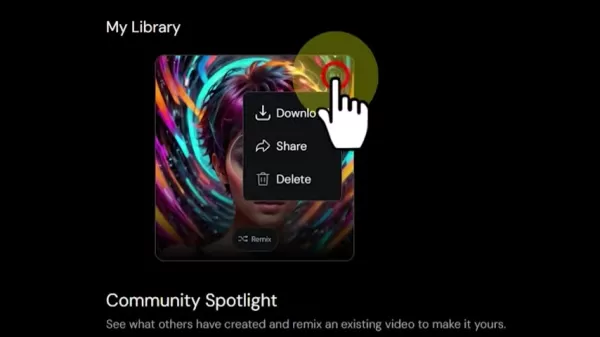
- 下載完成的視訊檔案
Hedra AI 功能細分
核心功能
- 先進的文字轉圖像角色生成
- 畫面精準的唇部同步技術
- 具備情緒調變功能的多語言文字轉語音
- 基於雲端處理的硬體獨立性
實際應用
行銷實作
- 虛擬產品示範
- 個人化視訊訊息
- 互動式數位代言人
教育用途
- 動畫演講
- 語言學習助手
- 歷史人物重現
娛樂概念
- 虛擬音樂表演者
- 動畫播客主持人
- 互動故事敘述員
常見問題
音訊長度指引
為了達到最佳的處理效率和同步精確度,請將連續的音訊片段限制在 3 分鐘以下。可考慮將較長的內容分割成章節,並分別渲染。
圖片規格
上傳高解析度圖片 (最小寬度 1024px),且臉部特徵清晰可見。避免使用受版權保護的素材或未經適當授權的肖像。
相關文章
 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo
相關專題推薦
視頻創作
 適用於 Reels、Shorts 及產品上市活動的 AI 短影片吸睛開場生成器
2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
 11 個工具
 xix.ai
寫作
適用於長篇寫作的 AI 文章大綱工具
2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
聊天機器人
用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

 評論 (3)
0/500
![BenGarcía]()
This guide is super helpful for beginners! I've been wanting to create a virtual singer for my music covers, and Hedra AI seems like the perfect starting point. The idea of AI making performances more 'lifelike' is both exciting and a bit scary for future human artists, though. 😅 Can't wait to try it this weekend!
![GeorgeJones]()
이 가이드 진짜 도움 많이 되네요 👍 헤드라 AI 같은 플랫폼 덕분에 초보자도 AI 가상 가수를 만들 수 있다니… 기술 발전 속도가 놀라워요. 혹시 창작한 아바타로 콘서트나 라이브 스트리밍도 가능할까요? 앞으로 가상 아이돌 시장이 어떻게 변할지 궁금해요 🎤
![WalterWalker]()
AIで歌うアバターを作るなんて、SFの世界みたい!でも技術の進歩は本当にすごいね。個人的には、VTuberやバーチャルアイドルに使えそうで楽しみだけど、著作権や声の権利問題は大丈夫かな?ちょっと心配…😅
人工智慧正在徹底改變數位內容的創作,特別是透過人工智慧驅動的歌唱虛擬人偶,提供非常逼真的表演。透過 Hedra AI 等直覺式平台,任何人現在都可以製作客製化的數位表演者,並提供精準的口型同步 - 不需要專業技術。這套全面的教學將引導您完成製作引人入勝的 AI 聲音虛擬人偶的每個步驟,適用於行銷、教育、娛樂等領域。
重點
無障礙的虛擬人偶製作:現代平台透過友善的工作流程將數位表演者的開發民主化。
迅速的製作要點:詳細的文字描述可顯著影響虛擬人像的品質與逼真度。
音訊最佳化:高品質的聲音音軌可確保自然的嘴部動作與表情。
創意自訂:從動畫到逼真的角色,您可以嘗試各種不同的視覺風格。
多產業應用:這些工具可為行銷、教育、客戶服務和娛樂領域的內容創作者提供服務。
AI 歌唱虛擬人偶簡介
了解數位聲樂表演者
AI 歌唱虛擬人偶是合成媒體的一項突破,結合了電腦產生的影像與先進的語音同步技術。這些數位表演者一開始是以文字為基礎的角色描述,然後由 AI 轉換成可視化的表現。當搭配音軌 (無論是錄音或 AI 產生的) 時,精密的演算法會將虛擬人偶的臉部特徵製成動畫,以令人信服的精確度來搭配聲樂表演。
這項技術的多樣性為眾多應用打開了大門。行銷人員可以開發品牌虛擬代言人、教育工作者可以創造動畫導師、藝人可以製作虛擬樂團或數位影響力。Hedra AI 等平台可透過直覺式介面簡化製作過程,從概念到最終產品都能引導使用者,無須動畫專業知識。
超越傳統動畫的優勢
與傳統動畫技術相比,AI 驅動的虛擬人像創作提供了明顯的優勢:
- 時間效率:將製作時間從數週縮短至數小時
- 預算輕鬆:省去昂貴的動畫工作室成本
- 創意自由:快速迭代角色設計
- 無障礙:使用者友善的平台,無需專業訓練
- 一致性:在多個虛擬人偶中維持一致的品質
製作高品質的 AI 頭像
掌握文字提示
出色的虛擬人偶生成始於詳細的描述性提示。考慮這些最佳做法:
- 指定視覺細節(髮型、衣服、臉部特徵)
- 包含藝術風格偏好(動畫、3D、逼真)
- 透過身體屬性描述個性特徵
- 參考光線條件和背景元素
- 使用比較性語言 (「像年輕的 David Bowie」)
改善範例:
基本:「創造一個女孩
增強型:「產生一個生氣勃勃的動漫角色,她扎著彩虹般的辮子,穿著皮夾克和霓虹吊飾,投擲岩石角,手上散發著電一般的能量」
優化音訊輸入
自然的唇語同步需要仔細的音訊準備:
- 在經過聲學處理的空間中使用專業麥克風錄音
- 在整個錄音過程中保持一致的音量和音調
- 在短語之間加入自然的停頓,以提供呼吸空間
- 考慮與化身外觀相符的聲音特徵
- 使用降噪工具消除背景雜訊
使用 Hedra AI 分步創作
平台導覽
- 透過 Hedra AI 官方網站存取
- 使用您偏好的憑證註冊
- 探索測試版儀表板介面
三個核心工作流程面板
- 音訊模組:上傳錄音或產生合成人聲
- 角色生成器:透過文字提示或圖片上傳設計頭像
- 視訊產生器:結合元素並呈現最終輸出
音訊整合流程
- 選擇音訊來源 (檔案上傳/錄音/TTS 轉換)
- 針對 TTS:輸入文字(300 字元限制)並選擇語音設定檔
- 用於上傳:使用以 44.1kHz 或更高頻率錄製的 MP3/WAV 檔案
- 調整時序標記以獲得精確的同步點
視覺設計階段
- 選擇圖片上傳或 AI 產生
- 針對 AI 創作:輸入詳細的角色描述
- 利用種子隨機化進行變體探索
- 調整生成參數以完善風格
最終渲染
- 預覽同步精確度
- 必要時調整時間偏移
- 以最佳解析度渲染專案
- 下載完成的視訊檔案
Hedra AI 功能細分
核心功能
- 先進的文字轉圖像角色生成
- 畫面精準的唇部同步技術
- 具備情緒調變功能的多語言文字轉語音
- 基於雲端處理的硬體獨立性
實際應用
行銷實作
- 虛擬產品示範
- 個人化視訊訊息
- 互動式數位代言人
教育用途
- 動畫演講
- 語言學習助手
- 歷史人物重現
娛樂概念
- 虛擬音樂表演者
- 動畫播客主持人
- 互動故事敘述員
常見問題
音訊長度指引
為了達到最佳的處理效率和同步精確度,請將連續的音訊片段限制在 3 分鐘以下。可考慮將較長的內容分割成章節,並分別渲染。
圖片規格
上傳高解析度圖片 (最小寬度 1024px),且臉部特徵清晰可見。避免使用受版權保護的素材或未經適當授權的肖像。








 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
 儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo

2026 年最新最佳 AI 短影片開場白生成器,適用於 Reels、Shorts 及產品上市活動!XIX.AI 嚴選備受好評、功能強大且能顛覆遊戲規則的工具,這些工具皆經過實際測試,能帶來絕對值得一試的成果。本頁面每週更新,提供免費與付費版本的比較排行榜,助您找到提升內容創意與生產力的完美解決方案。 立即探索,釋放您的 AI 競爭優勢!
11 個工具
xix.ai

2026 年最新、最受好評的長文寫作 AI 大綱工具!這份精選清單收錄了強大且具顛覆性的工具,能透過實際測試生成精準、結構化的大綱,大幅提升寫作效率。XIX.AI 正是這份菁英名單中的一員。 獲取免費版與付費版的比較指南,助您挑選最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

This guide is super helpful for beginners! I've been wanting to create a virtual singer for my music covers, and Hedra AI seems like the perfect starting point. The idea of AI making performances more 'lifelike' is both exciting and a bit scary for future human artists, though. 😅 Can't wait to try it this weekend!
이 가이드 진짜 도움 많이 되네요 👍 헤드라 AI 같은 플랫폼 덕분에 초보자도 AI 가상 가수를 만들 수 있다니… 기술 발전 속도가 놀라워요. 혹시 창작한 아바타로 콘서트나 라이브 스트리밍도 가능할까요? 앞으로 가상 아이돌 시장이 어떻게 변할지 궁금해요 🎤
AIで歌うアバターを作るなんて、SFの世界みたい!でも技術の進歩は本当にすごいね。個人的には、VTuberやバーチャルアイドルに使えそうで楽しみだけど、著作権や声の権利問題は大丈夫かな?ちょっと心配…😅












