


 家
歌うAIアバターの簡単な作り方:完全初心者ガイド
人工知能は、デジタルコンテンツ制作に革命をもたらしている。特に、AIを搭載した歌唱アバターは、驚くほどリアルなパフォーマンスを実現する。Hedra AIのような直感的なプラットフォームを使えば、専門知識は必要なく、誰でも正確なリップシンクを備えたカスタムデジタルパフォーマーを作ることができます。この包括的なチュートリアルでは、マーケティング、教育、エンターテイメントなど、魅力的なAIボーカルアバターを作成するためのすべてのステップを説明します。
キーポイント
アクセスしやすいアバター作成:最新のプラットフォームは、ユーザーフレンドリーなワークフローでデジタル・パフォーマー開発を民主化します。
プロンプト作成の要点:詳細なテキスト説明は、アバターの品質とリアリズムに大きな影響を与えます。
音声の最適化:高品質なボーカルトラックが、自然な口の動きと表情を実現します。
クリエイティブなカスタマイズ:アニメから写実的なキャラクターまで、多様なビジュアルスタイルを試すことができます。
マルチ・インダストリー・アプリケーション:これらのツールは、マーケティング、教育、カスタマーサービス、エンターテインメントの各分野のコンテンツ制作者に役立ちます。
AI歌唱アバターの紹介
デジタル・ヴォーカル・パフォーマーを理解する
AI歌唱アバターは、コンピュータ生成画像と高度な音声同期を組み合わせた合成メディアの画期的な進歩です。これらのデジタル・パフォーマーは、AIが視覚的表現に変換するテキストベースのキャラクター説明から始まります。音声トラック(録音されたものであれ、AIが生成したものであれ)と組み合わせると、洗練されたアルゴリズムがアバターの顔の特徴をアニメーション化し、説得力のある正確さでボーカル・パフォーマンスと一致させる。
この技術の多用途性は、多くのアプリケーションの扉を開く。マーケティング担当者はブランド化されたバーチャル・スポークスマンを開発し、教育者はアニメーション化されたインストラクターを作成し、エンターテイナーはバーチャル・バンドやデジタル・インフルエンサーを制作することができる。Hedra AIのようなプラットフォームは、アニメーションの専門知識を必要とせず、コンセプトから最終製品までユーザーを導く直感的なインターフェイスにより、このプロセスを簡素化します。
従来のアニメーションを超える利点
AIを活用したアバター制作は、従来のアニメーション技術と比較して明確な利点があります:
- 時間効率:制作期間を数週間から数時間に短縮
- 予算に優しい: 高額なアニメーション・スタジオのコストを削減できます。
- クリエイティブな自由:キャラクターデザインを迅速に反復
- アクセシビリティ:ユーザーフレンドリーなプラットフォームは専門的なトレーニングを必要としない
- 一貫性:複数のアバターで均一な品質を維持
高品質のAIアバターを作る
テキストプロンプトをマスターする
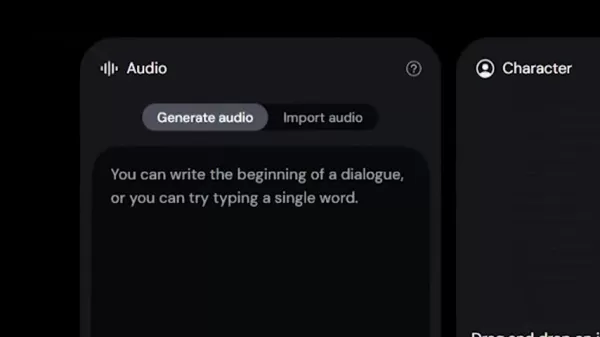
優れたアバターの生成は、詳細な説明プロンプトから始まります。以下のベストプラクティスを参考にしてください:
- 視覚的な詳細を指定する(髪型、服装、顔の特徴)
- アーティスティックなスタイルの好み(アニメ、3D、写実的)を含める。
- 身体的属性を通して性格の特徴を説明する
- 照明条件や背景要素に言及する
- 比較表現を使う(「若いデヴィッド・ボウイに似ている)
改善例
基本:"女の子を作る"
強化:「レザージャケットにネオンのチョーカーをつけ、手から電気エネルギーを放ちながらロックホーンを投げる。
オーディオ入力の最適化
自然なリップシンクには、入念なオーディオの準備が必要です:
- 音響処理された空間で、プロ仕様のマイクを使って録音する。
- 録音全体の音量とピッチを一定に保つ
- フレーズとフレーズの間に自然なポーズを入れ、余裕を持たせる
- アバターの外見に合ったボーカルの特徴を考慮する
- ノイズ除去ツールを使って背景のアーチファクトを除去する。
Hedra AIを使ったステップバイステップの作成
プラットフォームナビゲーション
- 公式ウェブサイトからHedra AIにアクセス
- お好みの認証情報を使って登録する
- ベータ版ダッシュボードのインターフェイスを見る
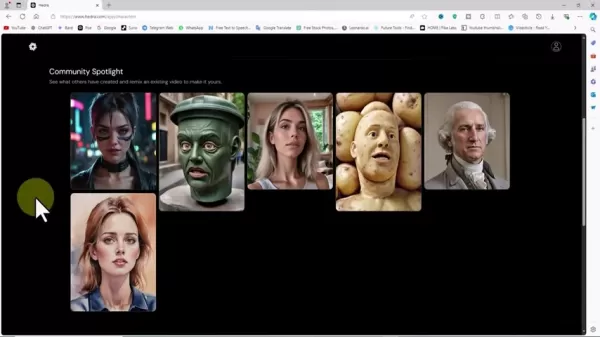
3つのコアワークフローパネル
- オーディオモジュール:レコーディングのアップロードまたは合成ボーカルの生成
- キャラクタービルダー:テキストプロンプトまたは画像のアップロードによるアバターのデザイン
- ビデオジェネレータ:要素を組み合わせて最終出力をレンダリング
音声統合プロセス
- オーディオソースの選択(ファイルアップロード/録音/TTS変換)
- TTSの場合: テキストを入力し(300文字制限)、音声プロファイルを選択します。
- アップロードの場合44.1kHz以上で録音されたMP3/WAVファイルを使用
- 正確な同期ポイントのためにタイミングマーカーを調整する
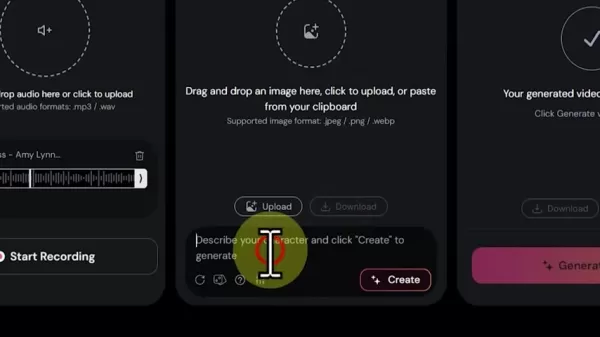
ビジュアルデザインフェーズ
- 画像アップロードかAI生成のどちらかを選択
- AI作成の場合キャラクターの詳細な説明を入力
- シードのランダム化を利用してバリアントを探索
- スタイル改良のための生成パラメータ調整
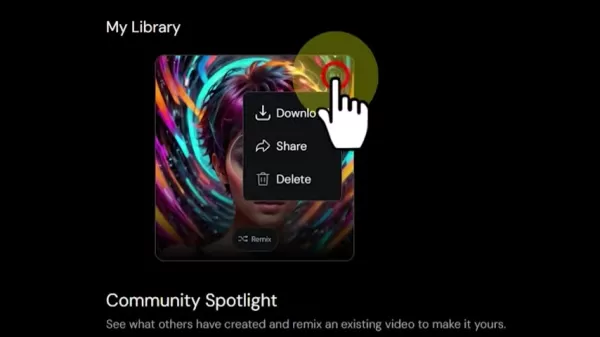
最終レンダリング
- 同期精度のプレビュー
- 必要に応じてタイミングオフセットを調整
- 最適な解像度でプロジェクトをレンダリング
- 完成した動画ファイルをダウンロード
ヘドラAIの機能内訳
コア機能
- 高度なテキストから画像への文字生成
- フレーム精度のリップシンクロ技術
- 感情変調による多言語音声合成
- ハードウェアに依存しないクラウドベース処理
実用的なアプリケーション
マーケティング実装
- バーチャル製品デモ
- パーソナライズされたビデオメッセージング
- インタラクティブなデジタル・スポークモデル
教育用途
- アニメーション講義プレゼンテーション
- 語学学習アシスタント
- 歴史上の人物の再現
エンターテイメント
- バーチャル音楽パフォーマー
- アニメーションポッドキャストホスト
- インタラクティブなストーリーナレーター
よくある質問
音声時間のガイドライン
処理効率と同期の精度を最適化するため、連続したオーディオセグメントは3分以内に制限してください。長いコンテンツは、チャプターに分割して別々にレンダリングすることを検討してください。
画像の仕様
顔の特徴がはっきりとわかる高解像度の画像(最小幅1024px)をアップロードしてください。著作権で保護された素材や、適切な許可のない肖像は避けてください。
関連記事
 DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン
カリフォルニア州の自動運転車規制:違反切符、ジオフェンス、そして100万マイルという新たな時代
Guident社は南フロリダでAuveTechのシャトルを運行しており、同社の遠隔監視技術を活用して、ウェストパームビーチでの4マイルのルートとボカラトンでの1マイルのルートを管理している。 | 提供:Guidentカリフォルニア州は、自動運転車の規制環境を再定義しつつあり、テクノロジー業界の「迅速に動き、失敗を恐れない」という考え方から、厳格な説明責任と厳しい走行距離要件へと移行している。Gui
関連特集おすすめ
動画作成
 Reels、Shorts、および製品ローンチキャンペーン向けのAIショート動画フック生成ツール
2026年最新!ReelsやShorts、製品ローンチキャンペーンに最適なAIショート動画フック生成ツール!XIX.AIは、実地テストを通じて「必ず試すべき」結果をもたらす、高評価で画期的なツールを厳選しています。毎週更新されるこのページでは、無料版と有料版の比較ランキングを掲載しており、コンテンツの創造性と生産性を高める最適なソリューションを見つけるお手伝いをします。 今すぐチェックして、AIの力を最大限に活用しましょう!
 11 ツール
 xix.ai
書き込み
長文執筆のためのAI記事構成ツール
2026年最新・最高評価のAIアウトラインツール:長文執筆に最適!この厳選コレクションには、執筆効率を大幅に向上させる、実証済みのテストを経て正確かつ構造化されたアウトラインを生成する、強力で画期的なツールが紹介されています。XIX.AIもこの厳選されたツールの一つです。 無料版と有料版の比較表を入手して、最適なツールの選択に役立ててください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
チャットボット
言語練習、面接対策、そして日常の流暢さのための最高のAIロールプレイチャットアプリ
2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai
作曲
リミックス制作、サンプリングの準備、カラオケマスター作成のためのAIステム分離ツール
2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
データ分析
収益ダッシュボード、ファネル分析、および製品指標向けのAI SQLコピロット
2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai
作曲
曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

 コメント (3)
0/500
![BenGarcía]()
This guide is super helpful for beginners! I've been wanting to create a virtual singer for my music covers, and Hedra AI seems like the perfect starting point. The idea of AI making performances more 'lifelike' is both exciting and a bit scary for future human artists, though. 😅 Can't wait to try it this weekend!
![GeorgeJones]()
이 가이드 진짜 도움 많이 되네요 👍 헤드라 AI 같은 플랫폼 덕분에 초보자도 AI 가상 가수를 만들 수 있다니… 기술 발전 속도가 놀라워요. 혹시 창작한 아바타로 콘서트나 라이브 스트리밍도 가능할까요? 앞으로 가상 아이돌 시장이 어떻게 변할지 궁금해요 🎤
![WalterWalker]()
AIで歌うアバターを作るなんて、SFの世界みたい!でも技術の進歩は本当にすごいね。個人的には、VTuberやバーチャルアイドルに使えそうで楽しみだけど、著作権や声の権利問題は大丈夫かな?ちょっと心配…😅
人工知能は、デジタルコンテンツ制作に革命をもたらしている。特に、AIを搭載した歌唱アバターは、驚くほどリアルなパフォーマンスを実現する。Hedra AIのような直感的なプラットフォームを使えば、専門知識は必要なく、誰でも正確なリップシンクを備えたカスタムデジタルパフォーマーを作ることができます。この包括的なチュートリアルでは、マーケティング、教育、エンターテイメントなど、魅力的なAIボーカルアバターを作成するためのすべてのステップを説明します。
キーポイント
アクセスしやすいアバター作成:最新のプラットフォームは、ユーザーフレンドリーなワークフローでデジタル・パフォーマー開発を民主化します。
プロンプト作成の要点:詳細なテキスト説明は、アバターの品質とリアリズムに大きな影響を与えます。
音声の最適化:高品質なボーカルトラックが、自然な口の動きと表情を実現します。
クリエイティブなカスタマイズ:アニメから写実的なキャラクターまで、多様なビジュアルスタイルを試すことができます。
マルチ・インダストリー・アプリケーション:これらのツールは、マーケティング、教育、カスタマーサービス、エンターテインメントの各分野のコンテンツ制作者に役立ちます。
AI歌唱アバターの紹介
デジタル・ヴォーカル・パフォーマーを理解する
AI歌唱アバターは、コンピュータ生成画像と高度な音声同期を組み合わせた合成メディアの画期的な進歩です。これらのデジタル・パフォーマーは、AIが視覚的表現に変換するテキストベースのキャラクター説明から始まります。音声トラック(録音されたものであれ、AIが生成したものであれ)と組み合わせると、洗練されたアルゴリズムがアバターの顔の特徴をアニメーション化し、説得力のある正確さでボーカル・パフォーマンスと一致させる。
この技術の多用途性は、多くのアプリケーションの扉を開く。マーケティング担当者はブランド化されたバーチャル・スポークスマンを開発し、教育者はアニメーション化されたインストラクターを作成し、エンターテイナーはバーチャル・バンドやデジタル・インフルエンサーを制作することができる。Hedra AIのようなプラットフォームは、アニメーションの専門知識を必要とせず、コンセプトから最終製品までユーザーを導く直感的なインターフェイスにより、このプロセスを簡素化します。
従来のアニメーションを超える利点
AIを活用したアバター制作は、従来のアニメーション技術と比較して明確な利点があります:
- 時間効率:制作期間を数週間から数時間に短縮
- 予算に優しい: 高額なアニメーション・スタジオのコストを削減できます。
- クリエイティブな自由:キャラクターデザインを迅速に反復
- アクセシビリティ:ユーザーフレンドリーなプラットフォームは専門的なトレーニングを必要としない
- 一貫性:複数のアバターで均一な品質を維持
高品質のAIアバターを作る
テキストプロンプトをマスターする
優れたアバターの生成は、詳細な説明プロンプトから始まります。以下のベストプラクティスを参考にしてください:
- 視覚的な詳細を指定する(髪型、服装、顔の特徴)
- アーティスティックなスタイルの好み(アニメ、3D、写実的)を含める。
- 身体的属性を通して性格の特徴を説明する
- 照明条件や背景要素に言及する
- 比較表現を使う(「若いデヴィッド・ボウイに似ている)
改善例
基本:"女の子を作る"
強化:「レザージャケットにネオンのチョーカーをつけ、手から電気エネルギーを放ちながらロックホーンを投げる。
オーディオ入力の最適化
自然なリップシンクには、入念なオーディオの準備が必要です:
- 音響処理された空間で、プロ仕様のマイクを使って録音する。
- 録音全体の音量とピッチを一定に保つ
- フレーズとフレーズの間に自然なポーズを入れ、余裕を持たせる
- アバターの外見に合ったボーカルの特徴を考慮する
- ノイズ除去ツールを使って背景のアーチファクトを除去する。
Hedra AIを使ったステップバイステップの作成
プラットフォームナビゲーション
- 公式ウェブサイトからHedra AIにアクセス
- お好みの認証情報を使って登録する
- ベータ版ダッシュボードのインターフェイスを見る
3つのコアワークフローパネル
- オーディオモジュール:レコーディングのアップロードまたは合成ボーカルの生成
- キャラクタービルダー:テキストプロンプトまたは画像のアップロードによるアバターのデザイン
- ビデオジェネレータ:要素を組み合わせて最終出力をレンダリング
音声統合プロセス
- オーディオソースの選択(ファイルアップロード/録音/TTS変換)
- TTSの場合: テキストを入力し(300文字制限)、音声プロファイルを選択します。
- アップロードの場合44.1kHz以上で録音されたMP3/WAVファイルを使用
- 正確な同期ポイントのためにタイミングマーカーを調整する
ビジュアルデザインフェーズ
- 画像アップロードかAI生成のどちらかを選択
- AI作成の場合キャラクターの詳細な説明を入力
- シードのランダム化を利用してバリアントを探索
- スタイル改良のための生成パラメータ調整
最終レンダリング
- 同期精度のプレビュー
- 必要に応じてタイミングオフセットを調整
- 最適な解像度でプロジェクトをレンダリング
- 完成した動画ファイルをダウンロード
ヘドラAIの機能内訳
コア機能
- 高度なテキストから画像への文字生成
- フレーム精度のリップシンクロ技術
- 感情変調による多言語音声合成
- ハードウェアに依存しないクラウドベース処理
実用的なアプリケーション
マーケティング実装
- バーチャル製品デモ
- パーソナライズされたビデオメッセージング
- インタラクティブなデジタル・スポークモデル
教育用途
- アニメーション講義プレゼンテーション
- 語学学習アシスタント
- 歴史上の人物の再現
エンターテイメント
- バーチャル音楽パフォーマー
- アニメーションポッドキャストホスト
- インタラクティブなストーリーナレーター
よくある質問
音声時間のガイドライン
処理効率と同期の精度を最適化するため、連続したオーディオセグメントは3分以内に制限してください。長いコンテンツは、チャプターに分割して別々にレンダリングすることを検討してください。
画像の仕様
顔の特徴がはっきりとわかる高解像度の画像(最小幅1024px)をアップロードしてください。著作権で保護された素材や、適切な許可のない肖像は避けてください。








 DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
 OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン
カリフォルニア州の自動運転車規制:違反切符、ジオフェンス、そして100万マイルという新たな時代
Guident社は南フロリダでAuveTechのシャトルを運行しており、同社の遠隔監視技術を活用して、ウェストパームビーチでの4マイルのルートとボカラトンでの1マイルのルートを管理している。 | 提供:Guidentカリフォルニア州は、自動運転車の規制環境を再定義しつつあり、テクノロジー業界の「迅速に動き、失敗を恐れない」という考え方から、厳格な説明責任と厳しい走行距離要件へと移行している。Gui

2026年最新!ReelsやShorts、製品ローンチキャンペーンに最適なAIショート動画フック生成ツール!XIX.AIは、実地テストを通じて「必ず試すべき」結果をもたらす、高評価で画期的なツールを厳選しています。毎週更新されるこのページでは、無料版と有料版の比較ランキングを掲載しており、コンテンツの創造性と生産性を高める最適なソリューションを見つけるお手伝いをします。 今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

2026年最新・最高評価のAIアウトラインツール:長文執筆に最適!この厳選コレクションには、執筆効率を大幅に向上させる、実証済みのテストを経て正確かつ構造化されたアウトラインを生成する、強力で画期的なツールが紹介されています。XIX.AIもこの厳選されたツールの一つです。 無料版と有料版の比較表を入手して、最適なツールの選択に役立ててください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai

2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

This guide is super helpful for beginners! I've been wanting to create a virtual singer for my music covers, and Hedra AI seems like the perfect starting point. The idea of AI making performances more 'lifelike' is both exciting and a bit scary for future human artists, though. 😅 Can't wait to try it this weekend!
이 가이드 진짜 도움 많이 되네요 👍 헤드라 AI 같은 플랫폼 덕분에 초보자도 AI 가상 가수를 만들 수 있다니… 기술 발전 속도가 놀라워요. 혹시 창작한 아바타로 콘서트나 라이브 스트리밍도 가능할까요? 앞으로 가상 아이돌 시장이 어떻게 변할지 궁금해요 🎤
AIで歌うアバターを作るなんて、SFの世界みたい!でも技術の進歩は本当にすごいね。個人的には、VTuberやバーチャルアイドルに使えそうで楽しみだけど、著作権や声の権利問題は大丈夫かな?ちょっと心配…😅












