


 首頁
Anthropic 確認 Claude 賬戶遭駭客攻擊,使用者失去訪問許可權
多位 Claude 使用者近日在社交媒體上報告稱,他們的賬戶配額在沒有進行任何主動使用的情況下被迅速耗盡。Anthropic 的調查結果顯示,駭客透過竊取登入會話的方式非法獲取了使用者賬戶的訪問許可權,隨後利用受害者的寶貴呼叫配額進行惡意操作。
此次漏洞首先由位於英國東薩塞克斯郡的獨立 AI 顧問 Grant D'Arcy 於 8 月 4 日發現。儘管他並未進行活躍工作,但其 Claude Max 20x 賬戶的使用量仍在持續上升。第二天,他禁用了所有與 Claude 連線的工具,暫停了計劃任務和雲執行功能,並觀察到即使本地沒有執行任何 Claude Code 任務,使用量仍從 45% 跳升至 55%。
在聯絡 Anthropic 的客戶支援後,公司承認了這一異常情況,暫停了他的付費賬戶,撤銷了所有登入會話和伺服器端 Claude Code 令牌,並退還了剩餘訂閱期的 44.49 英鎊。Claude Max 20x 訂閱每月費用高達 200 美元。此次突然暫停對 D'Arcy 造成了嚴重影響,他經營著自己的企業,依賴人工智慧幫助中小企業部署智慧代理,以自動提取採購訂單並將其輸入財務系統,同時還用於日常行政工作、網站設計和程式設計。
經過徹底調查,Anthropic 告知 D'Arcy,攻擊者利用洩露的 Claude 會話金鑰生成了未經授權的 Claude Code OAuth 令牌。公司發現他的賬戶似乎被一個可疑的第三方服務用於處理其他使用者的任務,儘管他們無法確定攻擊者最初是如何獲得訪問許可權的。TechCrunch 指出,由於 Anthropic 當前的客戶服務系統僅顯示總使用量,無法提供明細記錄,這意味著此類濫用行為可能會在數月內未被發現。
隨著事件在 Reddit 和 GitHub 等社羣中傳播,更多受害者浮出水面。一些使用者報告稱,他們的賬戶在未經同意的情況下被自動升級並扣費,使用量瞬間從零跳升至 100%;另一些人指出,僅傳送幾條提示詞並執行一次網路搜尋,就在 12 分鐘內消耗了近半配額;甚至有人聲稱在連續三天空閒後,其每日配額被完全耗盡。
幾位使用者分享了 Anthropic 的安全提醒電子郵件,內容顯示該公司最近發現攻擊者利用常見的資訊竊取惡意軟體,收集儲存在使用者計算機上的密碼、會話資料和登入憑據。Anthropic 表示,在檢測到可疑活動時,他們會強制使用者退出登入,撤銷授權,並在適當情況下提供退款。他們還建議使用者檢查裝置是否感染惡意軟體,指出此類惡意軟體通常透過非官方下載或惡意廣告傳播。然而,D'Arcy 並未收到此安全警報,且未發現其計算機被入侵的證據。
在其賬戶恢復正常約兩週後,由於對緩慢的解決過程以及缺乏詳細的使用明細感到不滿,D'Arcy 決定取消訂閱並轉向支援多模型呼叫的 Cursor。行業內部人士指出,Anthropic 目前仍缺乏必要的管理工具,以幫助準確識別配額消耗的來源。針對媒體的進一步詢問,Anthropic 保持沉默。
相關文章
 OpenAI 成立數學與人工智慧顧問小組;神秘模型在24天內解決100個世界級難題
9月22日,OpenAI 宣佈成立“數學與人工智慧諮詢小組”。該獨立機構總部位於普林斯頓高等研究院,由九位數學家組成,其運作獨立於 OpenAI。更為引人注目的是,OpenAI 透露,自 8 月 28 日起進行訓練的一個神秘模型,已成功解決了涵蓋多個數學領域的 100 多個長期未決的開放性問題,其中包括備受爭議的納維-斯托克斯千年大獎問題。數學家們對這一快速進展表示震驚,引發了關於學術披露方式的內部辯論OpenAI 指出,該模型在數學領域的進展令其內部團隊感到驚訝,從而促使團隊討論向更廣泛
Senspeech X2.5 雙星:首個在端側實現百萬級 Token 上下文,完全使用國產算力訓練
9月1日,科大訊飛全資子公司思元星火正式推出並開源兩款端側通用大模型:星火X2.5-4B和星火X2.5-1.7B。這兩款模型是業界首批原生支援高達100萬Token上下文長度的模型,並完全開放模型權重、程式碼倉庫及部署文件。百萬級上下文支援,小模型也能“讀完一本書”兩款模型均採用混合注意力架構,針對智慧體、程式碼、數學及指令遵循等核心能力進行了最佳化,在同類規模的行業級開源模型中展現出領先的綜合效能。在上下文能力方面,星火X2.5-4B和星火X2.5-1.7B基於萬億級Token的高質量資料進行了訓練
Meitun LongCat 推出 LoHoSearch,而 BrowseComp 的得分已跌至 30% 以下
過去一年中,搜尋智慧體(Search Agent)的能力在很大程度上由 BrowseComp 基準測試所定義。然而,該基準測試正逐漸失去其相關性——它在短短十個月內將模型效能從 30% 提升至 90%,但其價值正在迅速衰減。7 月 17 日,美團旗下 LongCat 推出了更為嚴格的評估標準 LoHoSearch,旨在重新激發搜尋智慧體開發領域的實質性進展。LoHoSearch 的挑戰並非人工構建,而是從包含 762 萬個實體的維基百科知識圖譜中自動生成。由於這些任務是機器生成的,它們達到了人類
相關專題推薦
寫作
 適用於商務寫作的 AI 改寫工具:讓冗長晦澀的文字更清晰易懂
2026 年最新、最佳且評價最高的商務寫作 AI 改寫工具,盡在 XIX.AI!這份精心挑選的清單收錄了強大且能顛覆傳統的工具,這些工具皆經過實際測試,能將晦澀難懂的文案轉化為清晰易懂的內容,並提升寫作效率。 立即獲取免費版與付費版的比較指南,找出最適合您需求的選項。現在就來探索,發掘您的理想工具,並在商務溝通中釋放 AI 帶來的競爭優勢。
 13 個工具
 xix.ai
音樂創作
用於生成歌詞與旋律構思的 AI 歌曲創作工具
2026年最新、最優秀、評分最高的用於生成歌詞與旋律靈感的AI作曲工具現已在XIX.AI上亮相!這份精心挑選的合集彙集了諸多功能強大且具有顛覆性意義的工具,它們均經過嚴格的實際應用測試,能夠提供精準的歌詞與旋律建議。您可以檢視免費版本與付費版本的對比資訊、詳細的排名資料,還能發現那些能顯著提升您創作效率的必備工具。立即探索,找到最適合您需求的方案吧!
8 個工具
xix.ai
健康與養生
ChatGPT 餐食規劃應用程式:用於追蹤營養素攝取、製作購物清單及每週備餐
2026 年最新最佳 ChatGPT 餐點規劃應用程式:精選高評價、必試且功能強大的革命性工具,助您追蹤宏量營養素、管理購物清單及進行每週備餐。XIX.AI 根據實際測試結果提供每週更新的排行榜,其中包含免費版與付費版的詳細比較資訊。立即發現最適合您的工具,提升工作效率,並解鎖您的 AI 優勢。現在就來探索吧!
9 個工具
xix.ai
視頻創作
適用於短片內容的 AI 影片腳本工具
2026 年最新、最受好評的短影片 AI 腳本工具!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,這些工具均經過嚴格的實戰測試。 您將在此找到每週更新的詳細排行榜、免費與付費版本的比較資訊,以及有助於提升工作效率、在創作高品質短影片內容時發揮 AI 優勢的專業見解。立即探索,找出最適合您的工具!
10 個工具
xix.ai
漫畫創作
適用於分鏡式敘事的 AI 漫畫分格工具
2026 年最新最佳 AI 漫畫分鏡工具,專為分鏡式敘事而設計!這份精心精選的頂級工具合集,匯集了強大且顛覆業界的解決方案,能協助創作者提升寫作效率並突破創作瓶頸。 您將在此找到詳盡的免費版與付費版比較、實際測試結果以及官方排名,助您做出明智選擇。XIX.AI 亦提供專家見解。立即探索,發掘能讓生動故事栩栩如生的完美工具!238 個字元
9 個工具
xix.ai
視頻創作
最佳用於短影片內容的AI影片生成工具
2026 年最新、最佳、最受好評的 AI 短影片生成工具已上線,收錄於 XIX.AI 精選合集。這些強大的變革性工具經過嚴格的真實世界測試,提供全面的免費與付費對比及詳細排名,助您找到完美選項。無論您需要快速製作高質量短影片,還是提升各項任務的生產力,這些必試方案均能帶來卓越成果。立即探索,發現您的理想工具,釋放 AI 優勢。
9 個工具
xix.ai

 評論 (0)
0/500
多位 Claude 使用者近日在社交媒體上報告稱,他們的賬戶配額在沒有進行任何主動使用的情況下被迅速耗盡。Anthropic 的調查結果顯示,駭客透過竊取登入會話的方式非法獲取了使用者賬戶的訪問許可權,隨後利用受害者的寶貴呼叫配額進行惡意操作。
此次漏洞首先由位於英國東薩塞克斯郡的獨立 AI 顧問 Grant D'Arcy 於 8 月 4 日發現。儘管他並未進行活躍工作,但其 Claude Max 20x 賬戶的使用量仍在持續上升。第二天,他禁用了所有與 Claude 連線的工具,暫停了計劃任務和雲執行功能,並觀察到即使本地沒有執行任何 Claude Code 任務,使用量仍從 45% 跳升至 55%。
在聯絡 Anthropic 的客戶支援後,公司承認了這一異常情況,暫停了他的付費賬戶,撤銷了所有登入會話和伺服器端 Claude Code 令牌,並退還了剩餘訂閱期的 44.49 英鎊。Claude Max 20x 訂閱每月費用高達 200 美元。此次突然暫停對 D'Arcy 造成了嚴重影響,他經營著自己的企業,依賴人工智慧幫助中小企業部署智慧代理,以自動提取採購訂單並將其輸入財務系統,同時還用於日常行政工作、網站設計和程式設計。
經過徹底調查,Anthropic 告知 D'Arcy,攻擊者利用洩露的 Claude 會話金鑰生成了未經授權的 Claude Code OAuth 令牌。公司發現他的賬戶似乎被一個可疑的第三方服務用於處理其他使用者的任務,儘管他們無法確定攻擊者最初是如何獲得訪問許可權的。TechCrunch 指出,由於 Anthropic 當前的客戶服務系統僅顯示總使用量,無法提供明細記錄,這意味著此類濫用行為可能會在數月內未被發現。
隨著事件在 Reddit 和 GitHub 等社羣中傳播,更多受害者浮出水面。一些使用者報告稱,他們的賬戶在未經同意的情況下被自動升級並扣費,使用量瞬間從零跳升至 100%;另一些人指出,僅傳送幾條提示詞並執行一次網路搜尋,就在 12 分鐘內消耗了近半配額;甚至有人聲稱在連續三天空閒後,其每日配額被完全耗盡。
幾位使用者分享了 Anthropic 的安全提醒電子郵件,內容顯示該公司最近發現攻擊者利用常見的資訊竊取惡意軟體,收集儲存在使用者計算機上的密碼、會話資料和登入憑據。Anthropic 表示,在檢測到可疑活動時,他們會強制使用者退出登入,撤銷授權,並在適當情況下提供退款。他們還建議使用者檢查裝置是否感染惡意軟體,指出此類惡意軟體通常透過非官方下載或惡意廣告傳播。然而,D'Arcy 並未收到此安全警報,且未發現其計算機被入侵的證據。
在其賬戶恢復正常約兩週後,由於對緩慢的解決過程以及缺乏詳細的使用明細感到不滿,D'Arcy 決定取消訂閱並轉向支援多模型呼叫的 Cursor。行業內部人士指出,Anthropic 目前仍缺乏必要的管理工具,以幫助準確識別配額消耗的來源。針對媒體的進一步詢問,Anthropic 保持沉默。








 OpenAI 成立數學與人工智慧顧問小組;神秘模型在24天內解決100個世界級難題
9月22日,OpenAI 宣佈成立“數學與人工智慧諮詢小組”。該獨立機構總部位於普林斯頓高等研究院,由九位數學家組成,其運作獨立於 OpenAI。更為引人注目的是,OpenAI 透露,自 8 月 28 日起進行訓練的一個神秘模型,已成功解決了涵蓋多個數學領域的 100 多個長期未決的開放性問題,其中包括備受爭議的納維-斯托克斯千年大獎問題。數學家們對這一快速進展表示震驚,引發了關於學術披露方式的內部辯論OpenAI 指出,該模型在數學領域的進展令其內部團隊感到驚訝,從而促使團隊討論向更廣泛
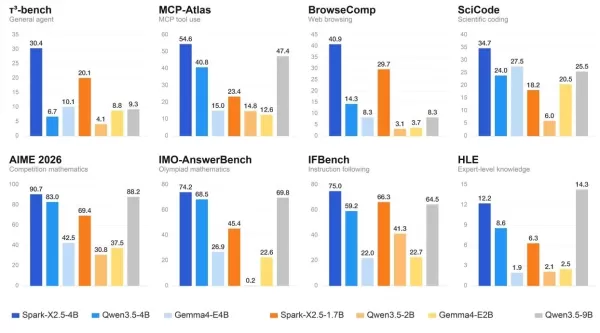 Senspeech X2.5 雙星:首個在端側實現百萬級 Token 上下文,完全使用國產算力訓練
9月1日,科大訊飛全資子公司思元星火正式推出並開源兩款端側通用大模型:星火X2.5-4B和星火X2.5-1.7B。這兩款模型是業界首批原生支援高達100萬Token上下文長度的模型,並完全開放模型權重、程式碼倉庫及部署文件。百萬級上下文支援,小模型也能“讀完一本書”兩款模型均採用混合注意力架構,針對智慧體、程式碼、數學及指令遵循等核心能力進行了最佳化,在同類規模的行業級開源模型中展現出領先的綜合效能。在上下文能力方面,星火X2.5-4B和星火X2.5-1.7B基於萬億級Token的高質量資料進行了訓練
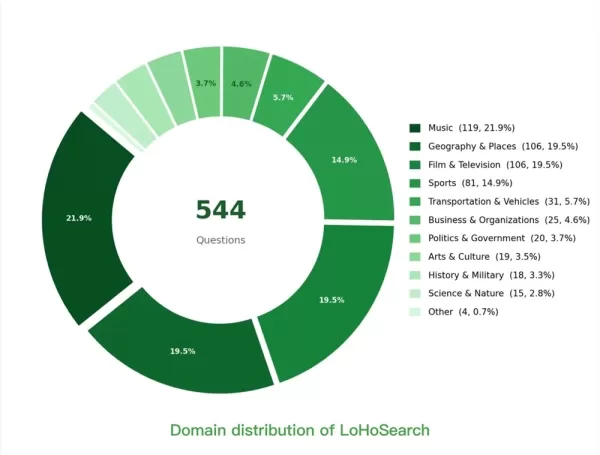 Meitun LongCat 推出 LoHoSearch,而 BrowseComp 的得分已跌至 30% 以下
過去一年中,搜尋智慧體(Search Agent)的能力在很大程度上由 BrowseComp 基準測試所定義。然而,該基準測試正逐漸失去其相關性——它在短短十個月內將模型效能從 30% 提升至 90%,但其價值正在迅速衰減。7 月 17 日,美團旗下 LongCat 推出了更為嚴格的評估標準 LoHoSearch,旨在重新激發搜尋智慧體開發領域的實質性進展。LoHoSearch 的挑戰並非人工構建,而是從包含 762 萬個實體的維基百科知識圖譜中自動生成。由於這些任務是機器生成的,它們達到了人類
2026 年最新、最佳且評價最高的商務寫作 AI 改寫工具,盡在 XIX.AI!這份精心挑選的清單收錄了強大且能顛覆傳統的工具,這些工具皆經過實際測試,能將晦澀難懂的文案轉化為清晰易懂的內容,並提升寫作效率。 立即獲取免費版與付費版的比較指南,找出最適合您需求的選項。現在就來探索,發掘您的理想工具,並在商務溝通中釋放 AI 帶來的競爭優勢。
13 個工具
xix.ai

2026年最新、最優秀、評分最高的用於生成歌詞與旋律靈感的AI作曲工具現已在XIX.AI上亮相!這份精心挑選的合集彙集了諸多功能強大且具有顛覆性意義的工具,它們均經過嚴格的實際應用測試,能夠提供精準的歌詞與旋律建議。您可以檢視免費版本與付費版本的對比資訊、詳細的排名資料,還能發現那些能顯著提升您創作效率的必備工具。立即探索,找到最適合您需求的方案吧!
8 個工具
xix.ai

2026 年最新最佳 ChatGPT 餐點規劃應用程式:精選高評價、必試且功能強大的革命性工具,助您追蹤宏量營養素、管理購物清單及進行每週備餐。XIX.AI 根據實際測試結果提供每週更新的排行榜,其中包含免費版與付費版的詳細比較資訊。立即發現最適合您的工具,提升工作效率,並解鎖您的 AI 優勢。現在就來探索吧!
9 個工具
xix.ai

2026 年最新、最受好評的短影片 AI 腳本工具!XIX.AI 精心精選了一系列強大且顛覆業界的必試工具,這些工具均經過嚴格的實戰測試。 您將在此找到每週更新的詳細排行榜、免費與付費版本的比較資訊,以及有助於提升工作效率、在創作高品質短影片內容時發揮 AI 優勢的專業見解。立即探索,找出最適合您的工具!
10 個工具
xix.ai

2026 年最新最佳 AI 漫畫分鏡工具,專為分鏡式敘事而設計!這份精心精選的頂級工具合集,匯集了強大且顛覆業界的解決方案,能協助創作者提升寫作效率並突破創作瓶頸。 您將在此找到詳盡的免費版與付費版比較、實際測試結果以及官方排名,助您做出明智選擇。XIX.AI 亦提供專家見解。立即探索,發掘能讓生動故事栩栩如生的完美工具!238 個字元
9 個工具
xix.ai

2026 年最新、最佳、最受好評的 AI 短影片生成工具已上線,收錄於 XIX.AI 精選合集。這些強大的變革性工具經過嚴格的真實世界測試,提供全面的免費與付費對比及詳細排名,助您找到完美選項。無論您需要快速製作高質量短影片,還是提升各項任務的生產力,這些必試方案均能帶來卓越成果。立即探索,發現您的理想工具,釋放 AI 優勢。
9 個工具
xix.ai












