


 首頁
人工智慧實驗室向 XDOF 支付費用,以收集雜亂無章的機器人訓練數據
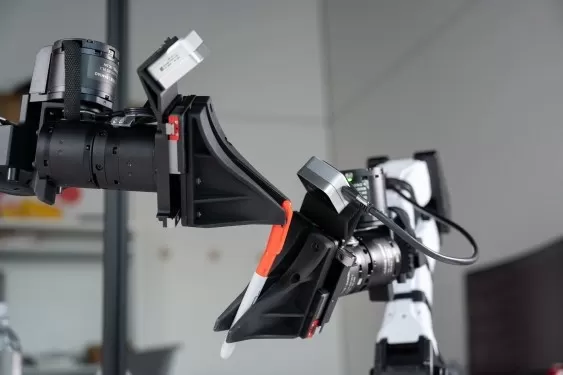
兩週前,OpenAI 宣布將重啟其於 2021 年關閉的機器人計畫——這是主要人工智慧實驗室正競相教導機器如何在實體世界中運作的最新跡象。然而,要打造具備實用能力的機器人,需要人工智慧產業目前仍欠缺的一項要素:與語言模型所使用的訓練數據相當的資料。
這項缺口正催生出一種新型基礎設施業務。與基於海量公開文本進行訓練的語言模型(LLMs)不同,機器人需要能捕捉實體互動的數據——而這類數據幾乎不存在。YouTube 影片和自由工作者拍攝的影像畫質較低,且難以與實體世界對齊。
今日正式出籠的 XDOF(發音為「ecks-doff」)認為,人工智慧的下一個主要瓶頸不會是模型或晶片,而是教導機器人如何與實體世界互動所需的數據回饋迴路。
這家新創公司旨在建構數據管道、蒐集工具及標註系統,這些正是前沿實驗室和機器人公司難以自行開發的——為此,該公司已從 Thrive Capital、Spark Capital、a16z、Lux 及 WndrCo 籌集了 7,000 萬美元資金。 共同創辦人兼執行長菲利普·吳(Philippe Wu)表示,XDOF 目前僱用約 60 名員工,已與 20 家客戶展開合作,其中包括數家前沿 AI 實驗室,但他無法透露具體名稱。
「所有頂尖實驗室都在致力於機器人技術,」吳表示。「我們已經看到在語言模型競賽中稍稍落後所帶來的某些弊端……你肯定不希望最終陷入這種境地:當你過晚投入這項技術時,所有人都已同舟共濟,而實體人工智慧正是下一個前沿領域。」
吳在加州大學柏克萊分校攻讀博士期間,親身經歷了這個問題。他的研究重點在於讓機器人能從大規模資料集中學習技能。但有個問題。
「我們沒有大規模數據可供使用,」他告訴 TechCrunch。「這是一個『雞生蛋還是蛋生雞』的問題——我們首先必須實際收集數據,才能開始探討如何為機器人學訓練基礎模型。」
吳與他日後在 XDOF 的共同創辦人兼技術長 Fred Shentu 共同投入了一個名為 GELLO 的專案,這是一個低成本的遙控操作系統,讓人類操作員能透過控制機械手臂來產生訓練資料。 「這篇論文最終在機器人領域產生了深遠影響,因為許多人面臨類似的需求與瓶頸,且許多人開始利用這類裝置進行資料蒐集,」吳表示。
察覺到這項商機後,吳、申圖以及第三位共同創辦人兼營運長金尼莫(Nemo Jin)於2024年10月共同創立了XDOF,旨在為致力於機器人模型研發的企業提供數據生態系統。 鑑於單純提供數據可能是一條死胡同,該公司同時專注於數據清理、工具開發及標註——為機器人訓練師建立一個自我強化的正向回饋循環。
作為起步,該公司正與加州大學柏克萊分校的人工智慧研究實驗室合作,發布其自認為有史以來規模最大的高品質機器人訓練資料集,名為 ABC。該資料集包含 130,000 組機器人操作軌跡資料、300 小時的模擬資料,以及 100 小時的評估資料。 此類大規模的預訓練數據,在學術界此前從未出現過。
「我們在語言、影像生成及其他領域中觀察到,當模型和數據公開後,研究社群往往能達成超乎預期的成果,」協助籌備此次發布的柏克萊大學博士生大衛·麥卡利斯特(David McAllister)向 TechCrunch 表示。
該團隊已利用這些數據,訓練機器人執行諸如摺疊 T 恤、壓平紙箱,或是將 AirPods 放入充電盒等基準任務。
無限的自由度
該公司計畫在「數據金字塔」的三個層級上展開工作。最具價值的層級是從實際部署的機器人上收集的遙控操作數據;其次是透過遙控機器人收集更通用數據的層級,例如 GELLO;最後則是人類執行日常任務時收集的「自我中心」數據,針對此類數據,XDOF 計畫開發專屬的可穿戴感測器。
「你選擇的相機將影響數據品質——這進而會影響手部追蹤演算法的表現,」吳表示。「如果一開始沒有妥善設計硬體,所收集的數據可能會出現你未曾預料到的特定問題。」
該公司計畫在全球範圍內招募並培訓大批遙控操作員和以自我為中心數據操作員——這種勞動密集型模式引發了一個顯而易見的問題:為什麼主要的研究實驗室不親自進行這項數據生產工作呢?
「你需要一個擁有數十萬平方英尺空間、配備數百台機器人的倉庫,」吳表示。「你必須維護這些機器人、校準其物理參數,並妥善培訓操作員。」
這項建置需要專注力、資本以及營運規模,而大多數人工智慧實驗室寧願將其外包——這正是 XDOF 押注的市場。
XDOF 這個名稱源自機器人學術語「自由度」(degrees of freedom),用以描述機器人能夠執行的獨立動作數量。以人類的手臂為例,從肩膀到手腕共有七個自由度。 人形機器人公司 Figure.AI 的最新機器人則擁有 30 個自由度。公司名稱中的「X」體現了其雄心壯志:「任意的自由度,無限的自由度,」吳表示。
相關文章
 華為千問釋出融合鴻蒙系統與大模型的AI教育解決方案
在首屆華為鴻蒙教育AI峰會上,華為及其生態合作伙伴釋出了一項全面的教育AI戰略以及全場景校園解決方案。該舉措標誌著教育數字化轉型進入關鍵階段,由分散式技術和大語言模型驅動。核心技術:融合鴻蒙分散式能力與AI模型更新後的解決方案利用鴻蒙作業系統的分散式架構,打破裝置間的硬體壁壘。這使得各類教學終端能夠實現無縫協作,構建起強大且互聯的數字基礎設施。此外,透過整合AI大模型,系統獲得了智慧核心,從而提升了應對複雜教育需求的理解與響應能力。全面覆蓋:全校園場景的智慧升級該全場景校園解決方案超越了
英偉達執行長黃仁勳駁斥人工智慧末日論,稱2030年發生災難的機率為零
在CBS新聞最近的一次採訪中,英偉達聯合創始人兼執行長黃仁勳駁斥了某些研究人員的警告,即人工智慧可能在幾年內導致人類滅絕,他將這種末日敘事稱為誇大其詞。“2030年不會是世界的終結,”黃仁勳表示。“機率為零。製造恐懼是不負責任且不必要的。”回應考克森的言論:缺乏科學依據黃仁勳的評論是對前Anthropic研究人員雅各布·考克森的直接回應,後者認為Anthropic和OpenAI等公司正在魯莽地競相構建自我改進的超級智慧系統,從而危及人類。這一觀點引發了更廣泛的辯論,促使達里奧·阿莫迪和
OpenAI 推出 GPT-Live-1 API,支援中斷處理、工具呼叫和電話代理
OpenAI 已正式推出 GPT-Live-1,這是一款旨在賦能構建全雙工實時語音應用的開發者 API 模型。此次釋出標誌著 AI 語音互動的重大轉變,從傳統的分段處理邁向流暢、自然的對話模式。在技術層面,GPT-Live-1 將語音理解和生成統一於單一模型中。透過消除串聯獨立的語音轉文字、推理和文字轉語音階段所帶來的延遲,它實現了近乎即時的響應時間。該模型原生支援全雙工互動,能夠同時監聽和說話,並準確管理中斷、停頓和背景噪音。除了無縫互動外,GPT-Live-1 還提供了廣泛的自定義選項。開發
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (0)
0/500
兩週前,OpenAI 宣布將重啟其於 2021 年關閉的機器人計畫——這是主要人工智慧實驗室正競相教導機器如何在實體世界中運作的最新跡象。然而,要打造具備實用能力的機器人,需要人工智慧產業目前仍欠缺的一項要素:與語言模型所使用的訓練數據相當的資料。
這項缺口正催生出一種新型基礎設施業務。與基於海量公開文本進行訓練的語言模型(LLMs)不同,機器人需要能捕捉實體互動的數據——而這類數據幾乎不存在。YouTube 影片和自由工作者拍攝的影像畫質較低,且難以與實體世界對齊。
今日正式出籠的 XDOF(發音為「ecks-doff」)認為,人工智慧的下一個主要瓶頸不會是模型或晶片,而是教導機器人如何與實體世界互動所需的數據回饋迴路。
這家新創公司旨在建構數據管道、蒐集工具及標註系統,這些正是前沿實驗室和機器人公司難以自行開發的——為此,該公司已從 Thrive Capital、Spark Capital、a16z、Lux 及 WndrCo 籌集了 7,000 萬美元資金。 共同創辦人兼執行長菲利普·吳(Philippe Wu)表示,XDOF 目前僱用約 60 名員工,已與 20 家客戶展開合作,其中包括數家前沿 AI 實驗室,但他無法透露具體名稱。
「所有頂尖實驗室都在致力於機器人技術,」吳表示。「我們已經看到在語言模型競賽中稍稍落後所帶來的某些弊端……你肯定不希望最終陷入這種境地:當你過晚投入這項技術時,所有人都已同舟共濟,而實體人工智慧正是下一個前沿領域。」
吳在加州大學柏克萊分校攻讀博士期間,親身經歷了這個問題。他的研究重點在於讓機器人能從大規模資料集中學習技能。但有個問題。
「我們沒有大規模數據可供使用,」他告訴 TechCrunch。「這是一個『雞生蛋還是蛋生雞』的問題——我們首先必須實際收集數據,才能開始探討如何為機器人學訓練基礎模型。」
吳與他日後在 XDOF 的共同創辦人兼技術長 Fred Shentu 共同投入了一個名為 GELLO 的專案,這是一個低成本的遙控操作系統,讓人類操作員能透過控制機械手臂來產生訓練資料。 「這篇論文最終在機器人領域產生了深遠影響,因為許多人面臨類似的需求與瓶頸,且許多人開始利用這類裝置進行資料蒐集,」吳表示。
察覺到這項商機後,吳、申圖以及第三位共同創辦人兼營運長金尼莫(Nemo Jin)於2024年10月共同創立了XDOF,旨在為致力於機器人模型研發的企業提供數據生態系統。 鑑於單純提供數據可能是一條死胡同,該公司同時專注於數據清理、工具開發及標註——為機器人訓練師建立一個自我強化的正向回饋循環。
作為起步,該公司正與加州大學柏克萊分校的人工智慧研究實驗室合作,發布其自認為有史以來規模最大的高品質機器人訓練資料集,名為 ABC。該資料集包含 130,000 組機器人操作軌跡資料、300 小時的模擬資料,以及 100 小時的評估資料。 此類大規模的預訓練數據,在學術界此前從未出現過。
「我們在語言、影像生成及其他領域中觀察到,當模型和數據公開後,研究社群往往能達成超乎預期的成果,」協助籌備此次發布的柏克萊大學博士生大衛·麥卡利斯特(David McAllister)向 TechCrunch 表示。
該團隊已利用這些數據,訓練機器人執行諸如摺疊 T 恤、壓平紙箱,或是將 AirPods 放入充電盒等基準任務。
無限的自由度
該公司計畫在「數據金字塔」的三個層級上展開工作。最具價值的層級是從實際部署的機器人上收集的遙控操作數據;其次是透過遙控機器人收集更通用數據的層級,例如 GELLO;最後則是人類執行日常任務時收集的「自我中心」數據,針對此類數據,XDOF 計畫開發專屬的可穿戴感測器。
「你選擇的相機將影響數據品質——這進而會影響手部追蹤演算法的表現,」吳表示。「如果一開始沒有妥善設計硬體,所收集的數據可能會出現你未曾預料到的特定問題。」
該公司計畫在全球範圍內招募並培訓大批遙控操作員和以自我為中心數據操作員——這種勞動密集型模式引發了一個顯而易見的問題:為什麼主要的研究實驗室不親自進行這項數據生產工作呢?
「你需要一個擁有數十萬平方英尺空間、配備數百台機器人的倉庫,」吳表示。「你必須維護這些機器人、校準其物理參數,並妥善培訓操作員。」
這項建置需要專注力、資本以及營運規模,而大多數人工智慧實驗室寧願將其外包——這正是 XDOF 押注的市場。
XDOF 這個名稱源自機器人學術語「自由度」(degrees of freedom),用以描述機器人能夠執行的獨立動作數量。以人類的手臂為例,從肩膀到手腕共有七個自由度。 人形機器人公司 Figure.AI 的最新機器人則擁有 30 個自由度。公司名稱中的「X」體現了其雄心壯志:「任意的自由度,無限的自由度,」吳表示。








 華為千問釋出融合鴻蒙系統與大模型的AI教育解決方案
在首屆華為鴻蒙教育AI峰會上,華為及其生態合作伙伴釋出了一項全面的教育AI戰略以及全場景校園解決方案。該舉措標誌著教育數字化轉型進入關鍵階段,由分散式技術和大語言模型驅動。核心技術:融合鴻蒙分散式能力與AI模型更新後的解決方案利用鴻蒙作業系統的分散式架構,打破裝置間的硬體壁壘。這使得各類教學終端能夠實現無縫協作,構建起強大且互聯的數字基礎設施。此外,透過整合AI大模型,系統獲得了智慧核心,從而提升了應對複雜教育需求的理解與響應能力。全面覆蓋:全校園場景的智慧升級該全場景校園解決方案超越了
 英偉達執行長黃仁勳駁斥人工智慧末日論,稱2030年發生災難的機率為零
在CBS新聞最近的一次採訪中,英偉達聯合創始人兼執行長黃仁勳駁斥了某些研究人員的警告,即人工智慧可能在幾年內導致人類滅絕,他將這種末日敘事稱為誇大其詞。“2030年不會是世界的終結,”黃仁勳表示。“機率為零。製造恐懼是不負責任且不必要的。”回應考克森的言論:缺乏科學依據黃仁勳的評論是對前Anthropic研究人員雅各布·考克森的直接回應,後者認為Anthropic和OpenAI等公司正在魯莽地競相構建自我改進的超級智慧系統,從而危及人類。這一觀點引發了更廣泛的辯論,促使達里奧·阿莫迪和
 OpenAI 推出 GPT-Live-1 API,支援中斷處理、工具呼叫和電話代理
OpenAI 已正式推出 GPT-Live-1,這是一款旨在賦能構建全雙工實時語音應用的開發者 API 模型。此次釋出標誌著 AI 語音互動的重大轉變,從傳統的分段處理邁向流暢、自然的對話模式。在技術層面,GPT-Live-1 將語音理解和生成統一於單一模型中。透過消除串聯獨立的語音轉文字、推理和文字轉語音階段所帶來的延遲,它實現了近乎即時的響應時間。該模型原生支援全雙工互動,能夠同時監聽和說話,並準確管理中斷、停頓和背景噪音。除了無縫互動外,GPT-Live-1 還提供了廣泛的自定義選項。開發

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai












