


 Lar
Laboratórios de IA pagam à XDOF pela coleta de dados desorganizados para treinamento de robôs
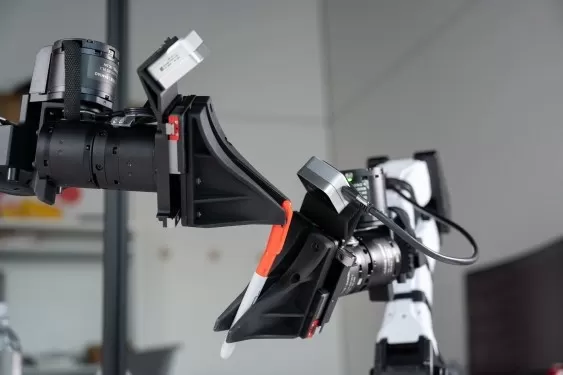
Há duas semanas, a OpenAI anunciou que iria retomar o programa de robótica que havia encerrado em 2021 — o mais recente sinal de que os principais laboratórios de IA estão competindo para ensinar as máquinas a operar no mundo físico. Mas a construção de robôs capazes requer algo que ainda falta ao setor de IA: dados de treinamento equivalentes aos utilizados pelos modelos de linguagem.
Essa lacuna está impulsionando um novo tipo de negócio de infraestrutura. Ao contrário dos LLMs, que foram treinados com enormes quantidades de texto disponível publicamente, os robôs precisam de dados que capturem interações físicas — e esse tipo de dado praticamente não existe. Vídeos do YouTube e filmagens feitas por trabalhadores autônomos têm baixa qualidade e são difíceis de alinhar com o mundo físico.
A XDOF (pronuncia-se “ecks-doff”), que saiu do sigilo hoje, acredita que o próximo grande gargalo na IA não serão os modelos ou os chips, mas o ciclo de feedback de dados necessário para ensinar os robôs a interagir com o mundo físico.
A startup tem como objetivo construir os fluxos de dados, as ferramentas de coleta e os sistemas de anotação que laboratórios de ponta e empresas de robótica não conseguem desenvolver facilmente por conta própria — e levantou US$ 70 milhões da Thrive Capital, Spark Capital, a16z, Lux e WndrCo para isso. O cofundador e CEO Philippe Wu afirma que a XDOF, que emprega cerca de 60 pessoas, já está trabalhando com 20 clientes, incluindo vários laboratórios de ponta em IA, embora ele não possa revelar seus nomes.
“Todos os principais laboratórios estão tentando avançar na robótica”, disse Wu. “Já vimos algumas das desvantagens de ficar um pouco para trás na corrida dos modelos de linguagem… você não quer acabar em uma situação em que busque essa tecnologia tarde demais, e todos estejam no mesmo barco, em que a IA física é a próxima fronteira.”
Wu enfrentou esse problema em primeira mão quando era aluno de doutorado na UC Berkeley. Seu foco era permitir que robôs aprendessem habilidades a partir de conjuntos de dados em grande escala. Havia apenas um problema.
“Não tínhamos dados em grande escala com os quais trabalhar”, disse ele ao TechCrunch. “Havia esse problema do ovo e da galinha — primeiro precisávamos coletar dados antes mesmo de podermos perguntar como treinar um modelo básico para a robótica.”
Wu e seu futuro cofundador e diretor de tecnologia (CTO) da XDOF, Fred Shentu, trabalharam em um projeto chamado GELLO, um sistema de teleoperação de baixo custo que permite que um operador humano controle um braço robótico para gerar dados de treinamento. “Acabou se tornando um artigo muito influente na área de robótica, porque muitas pessoas tinham necessidades e gargalos semelhantes, e muitas começaram a utilizar esse tipo de dispositivo para coleta de dados”, disse Wu.
Percebendo a oportunidade, Wu, Shentu e o terceiro cofundador e diretor de operações, Nemo Jin, lançaram a XDOF em outubro de 2024 para oferecer um ecossistema de dados para empresas que buscam desenvolver modelos de robótica. Ciente de que apenas o fornecimento de dados pode ser um negócio sem futuro, a empresa também está focada na limpeza, no desenvolvimento de ferramentas e na anotação de dados — criando um ciclo de feedback que se autoalimenta para os treinadores de robôs.
Como ponto de partida, a empresa está fazendo parceria com o Laboratório de Pesquisa em IA da UC Berkeley para lançar o que acredita ser a maior coleção de dados de treinamento de robôs de alta qualidade já reunida, chamada de ABC. Ela inclui 130 mil trajetórias de dados de manipulação robótica, 300 horas de simulação e 100 horas de avaliações. Esse tipo de dado de pré-treinamento em grande escala nunca esteve disponível para a academia antes.
“Vimos nas áreas de linguagem, geração de imagens e outros campos que, quando modelos e dados são divulgados, a comunidade alcança resultados que você não necessariamente esperaria”, disse David McAllister, aluno de doutorado de Berkeley que ajudou a organizar o lançamento, ao TechCrunch.
A equipe já utilizou os dados para treinar robôs em tarefas de referência, como dobrar camisetas e achatar caixas, ou colocar AirPods em seus estojos.
Graus de liberdade ilimitados
A empresa planeja trabalhar em três níveis de uma pirâmide de dados. O nível mais valioso é o de dados de teleoperação coletados no próprio robô que está sendo utilizado; em seguida, vêm os robôs teleoperados que coletam dados mais gerais, como no caso do GELLO; e, finalmente, os dados “egocêntricos” coletados por humanos realizando tarefas cotidianas, para os quais a XDOF planeja desenvolver seus próprios sensores vestíveis.
“A escolha da câmera afetará a qualidade dos dados — o que, por sua vez, afetará o desempenho do algoritmo de rastreamento de mãos”, disse Wu. “Se o hardware não for bem projetado desde o início, os dados coletados podem apresentar problemas muito específicos que você não previu.”
A empresa planeja contratar e treinar um grande número de teleoperadores e operadores de dados egocêntricos em todo o mundo — um modelo que exige muita mão de obra e levanta uma questão óbvia: por que os principais laboratórios não estão fazendo esse trabalho de produção de dados por conta própria?
“É preciso um armazém de centenas de milhares de pés quadrados com centenas de robôs”, disse Wu. “É preciso fazer a manutenção desses robôs, calibrar seus parâmetros físicos e treinar adequadamente os operadores.”
É uma estrutura que exige foco, capital e escala operacional que a maioria dos laboratórios de IA prefere terceirizar — e é exatamente nesse mercado que a XDOF está apostando.
O nome XDOF é um trocadilho com o termo da robótica “graus de liberdade”, que descreve o número de movimentos independentes que um robô pode realizar. Seu braço, do ombro ao pulso, tem sete graus de liberdade. O robô mais recente da empresa de robótica humanóide Figure.AI tem 30. O “X” no nome da empresa reflete sua ambição: “Graus de liberdade arbitrários, graus de liberdade ilimitados”, diz Wu.
Artigo relacionado
 A Huawei Qinyun apresenta uma solução de IA para educação que integra o HarmonyOS e grandes modelos
Durante a Cimeira de IA para a Educação Harmony inaugural da Huawei, a Huawei e os seus parceiros do ecossistema revelaram uma estratégia abrangente de IA para a educação, juntamente com uma solução para campus em todos os cenários. Esta iniciativa s
O CEO da Nvidia, Jensen Huang, descarta as alegações de um apocalipse da IA e afirma que a probabilidade de um fim do mundo em 2030 é zero
Em uma recente entrevista à CBS News, o cofundador e CEO da NVIDIA, Jensen Huang, descartou os alertas de certos pesquisadores de que a inteligência artificial poderia levar à extinção da humanidade em poucos anos, classificando essas narrativas apoc
A OpenAI lança a API GPT-Live-1 com tratamento de interrupções, chamadas de ferramentas e agentes telefônicos
A OpenAI lançou oficialmente o GPT-Live-1, um novo modelo de API projetado para capacitar desenvolvedores a criar aplicações de voz em tempo real com interação full-duplex. Este lançamento sinaliza uma mudança significativa na interação por voz com I
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
Há duas semanas, a OpenAI anunciou que iria retomar o programa de robótica que havia encerrado em 2021 — o mais recente sinal de que os principais laboratórios de IA estão competindo para ensinar as máquinas a operar no mundo físico. Mas a construção de robôs capazes requer algo que ainda falta ao setor de IA: dados de treinamento equivalentes aos utilizados pelos modelos de linguagem.
Essa lacuna está impulsionando um novo tipo de negócio de infraestrutura. Ao contrário dos LLMs, que foram treinados com enormes quantidades de texto disponível publicamente, os robôs precisam de dados que capturem interações físicas — e esse tipo de dado praticamente não existe. Vídeos do YouTube e filmagens feitas por trabalhadores autônomos têm baixa qualidade e são difíceis de alinhar com o mundo físico.
A XDOF (pronuncia-se “ecks-doff”), que saiu do sigilo hoje, acredita que o próximo grande gargalo na IA não serão os modelos ou os chips, mas o ciclo de feedback de dados necessário para ensinar os robôs a interagir com o mundo físico.
A startup tem como objetivo construir os fluxos de dados, as ferramentas de coleta e os sistemas de anotação que laboratórios de ponta e empresas de robótica não conseguem desenvolver facilmente por conta própria — e levantou US$ 70 milhões da Thrive Capital, Spark Capital, a16z, Lux e WndrCo para isso. O cofundador e CEO Philippe Wu afirma que a XDOF, que emprega cerca de 60 pessoas, já está trabalhando com 20 clientes, incluindo vários laboratórios de ponta em IA, embora ele não possa revelar seus nomes.
“Todos os principais laboratórios estão tentando avançar na robótica”, disse Wu. “Já vimos algumas das desvantagens de ficar um pouco para trás na corrida dos modelos de linguagem… você não quer acabar em uma situação em que busque essa tecnologia tarde demais, e todos estejam no mesmo barco, em que a IA física é a próxima fronteira.”
Wu enfrentou esse problema em primeira mão quando era aluno de doutorado na UC Berkeley. Seu foco era permitir que robôs aprendessem habilidades a partir de conjuntos de dados em grande escala. Havia apenas um problema.
“Não tínhamos dados em grande escala com os quais trabalhar”, disse ele ao TechCrunch. “Havia esse problema do ovo e da galinha — primeiro precisávamos coletar dados antes mesmo de podermos perguntar como treinar um modelo básico para a robótica.”
Wu e seu futuro cofundador e diretor de tecnologia (CTO) da XDOF, Fred Shentu, trabalharam em um projeto chamado GELLO, um sistema de teleoperação de baixo custo que permite que um operador humano controle um braço robótico para gerar dados de treinamento. “Acabou se tornando um artigo muito influente na área de robótica, porque muitas pessoas tinham necessidades e gargalos semelhantes, e muitas começaram a utilizar esse tipo de dispositivo para coleta de dados”, disse Wu.
Percebendo a oportunidade, Wu, Shentu e o terceiro cofundador e diretor de operações, Nemo Jin, lançaram a XDOF em outubro de 2024 para oferecer um ecossistema de dados para empresas que buscam desenvolver modelos de robótica. Ciente de que apenas o fornecimento de dados pode ser um negócio sem futuro, a empresa também está focada na limpeza, no desenvolvimento de ferramentas e na anotação de dados — criando um ciclo de feedback que se autoalimenta para os treinadores de robôs.
Como ponto de partida, a empresa está fazendo parceria com o Laboratório de Pesquisa em IA da UC Berkeley para lançar o que acredita ser a maior coleção de dados de treinamento de robôs de alta qualidade já reunida, chamada de ABC. Ela inclui 130 mil trajetórias de dados de manipulação robótica, 300 horas de simulação e 100 horas de avaliações. Esse tipo de dado de pré-treinamento em grande escala nunca esteve disponível para a academia antes.
“Vimos nas áreas de linguagem, geração de imagens e outros campos que, quando modelos e dados são divulgados, a comunidade alcança resultados que você não necessariamente esperaria”, disse David McAllister, aluno de doutorado de Berkeley que ajudou a organizar o lançamento, ao TechCrunch.
A equipe já utilizou os dados para treinar robôs em tarefas de referência, como dobrar camisetas e achatar caixas, ou colocar AirPods em seus estojos.
Graus de liberdade ilimitados
A empresa planeja trabalhar em três níveis de uma pirâmide de dados. O nível mais valioso é o de dados de teleoperação coletados no próprio robô que está sendo utilizado; em seguida, vêm os robôs teleoperados que coletam dados mais gerais, como no caso do GELLO; e, finalmente, os dados “egocêntricos” coletados por humanos realizando tarefas cotidianas, para os quais a XDOF planeja desenvolver seus próprios sensores vestíveis.
“A escolha da câmera afetará a qualidade dos dados — o que, por sua vez, afetará o desempenho do algoritmo de rastreamento de mãos”, disse Wu. “Se o hardware não for bem projetado desde o início, os dados coletados podem apresentar problemas muito específicos que você não previu.”
A empresa planeja contratar e treinar um grande número de teleoperadores e operadores de dados egocêntricos em todo o mundo — um modelo que exige muita mão de obra e levanta uma questão óbvia: por que os principais laboratórios não estão fazendo esse trabalho de produção de dados por conta própria?
“É preciso um armazém de centenas de milhares de pés quadrados com centenas de robôs”, disse Wu. “É preciso fazer a manutenção desses robôs, calibrar seus parâmetros físicos e treinar adequadamente os operadores.”
É uma estrutura que exige foco, capital e escala operacional que a maioria dos laboratórios de IA prefere terceirizar — e é exatamente nesse mercado que a XDOF está apostando.
O nome XDOF é um trocadilho com o termo da robótica “graus de liberdade”, que descreve o número de movimentos independentes que um robô pode realizar. Seu braço, do ombro ao pulso, tem sete graus de liberdade. O robô mais recente da empresa de robótica humanóide Figure.AI tem 30. O “X” no nome da empresa reflete sua ambição: “Graus de liberdade arbitrários, graus de liberdade ilimitados”, diz Wu.








 A Huawei Qinyun apresenta uma solução de IA para educação que integra o HarmonyOS e grandes modelos
Durante a Cimeira de IA para a Educação Harmony inaugural da Huawei, a Huawei e os seus parceiros do ecossistema revelaram uma estratégia abrangente de IA para a educação, juntamente com uma solução para campus em todos os cenários. Esta iniciativa s
 O CEO da Nvidia, Jensen Huang, descarta as alegações de um apocalipse da IA e afirma que a probabilidade de um fim do mundo em 2030 é zero
Em uma recente entrevista à CBS News, o cofundador e CEO da NVIDIA, Jensen Huang, descartou os alertas de certos pesquisadores de que a inteligência artificial poderia levar à extinção da humanidade em poucos anos, classificando essas narrativas apoc
 A OpenAI lança a API GPT-Live-1 com tratamento de interrupções, chamadas de ferramentas e agentes telefônicos
A OpenAI lançou oficialmente o GPT-Live-1, um novo modelo de API projetado para capacitar desenvolvedores a criar aplicações de voz em tempo real com interação full-duplex. Este lançamento sinaliza uma mudança significativa na interação por voz com I

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












