


 首页
人工智能实验室向XDOF支付费用,用于收集杂乱无章的机器人训练数据
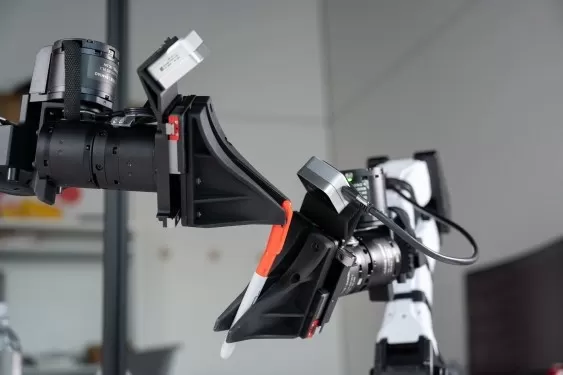
两周前,OpenAI宣布将重启其于2021年关闭的机器人项目——这是主要人工智能实验室竞相教机器如何在物理世界中运作的最新迹象。但要制造出功能强大的机器人,需要人工智能行业目前仍缺乏的一样东西:与语言模型所用数据相当的训练数据。
这一缺口正在催生一种新型基础设施业务。与基于海量公开文本进行训练的语言模型(LLMs)不同,机器人需要能够捕捉物理交互的数据——而此类数据几乎不存在。YouTube视频和零工经济从业者拍摄的素材保真度较低,且难以与物理世界进行对齐。
今日正式出道的XDOF(发音为“ecks-doff”)认为,人工智能领域的下一个主要瓶颈不会是模型或芯片,而是教机器人如何与物理世界互动所需的数据反馈循环。
这家初创公司致力于构建数据管道、采集工具和标注系统——这些正是前沿实验室和机器人公司难以独立开发的内容——为此,该公司已从 Thrive Capital、Spark Capital、a16z、Lux 和 WndrCo 处筹集了 7000 万美元资金。 联合创始人兼首席执行官菲利普·吴(Philippe Wu)表示,XDOF目前拥有约60名员工,已与20家客户展开合作,其中包括多家前沿AI实验室,但他无法透露具体名称。
“所有顶尖实验室都在尝试进军机器人领域,”吴表示,“我们已经看到在语言模型竞赛中稍稍落后所带来的某些弊端……你肯定不希望最终陷入这种境地:当大家都在物理人工智能这一下一个前沿领域齐头并进时,你却因追求这项技术太晚而落后。”
吴在加州大学伯克利分校攻读博士期间就亲身经历了这一问题。他的研究重点是让机器人能够从大规模数据集中学习技能。但有一个问题。
“我们没有大规模数据可供使用,”他告诉TechCrunch。“这就像一个‘鸡生蛋还是蛋生鸡’的问题——我们首先需要实际收集数据,才能开始探讨如何为机器人学训练基础模型。”
吴与他日后的XDOF联合创始人兼首席技术官弗雷德·申图(Fred Shentu)共同开展了一个名为GELLO的项目,这是一个低成本的遥操作系统,允许人类操作员控制机械臂来生成训练数据。 “这最终成为了一篇在机器人领域极具影响力的论文,因为许多人面临着类似的需求和瓶颈,许多人开始利用此类设备进行数据采集,”吴表示。
敏锐地捕捉到这一机遇,吴、申图以及第三位联合创始人兼首席运营官金尼莫于2024年10月共同创立了XDOF,旨在为致力于研发机器人模型的企业提供数据生态系统。 考虑到仅提供数据可能是一条死胡同,该公司还专注于数据清洗、工具开发和标注——为机器人训练者构建一个自我强化的反馈循环。
作为起点,该公司正与加州大学伯克利分校的人工智能研究实验室合作,发布其认为迄今为止规模最大的高质量机器人训练数据集,名为ABC。该数据集包含13万条机器人操作轨迹数据、300小时的模拟数据以及100小时的评估数据。 此前,学术界从未拥有过如此大规模的预训练数据。
“我们在语言、图像生成及其他领域看到,当模型和数据发布后,研究社区往往能取得超出预期的成果,”协助组织此次数据发布的伯克利大学博士生大卫·麦卡利斯特(David McAllister)告诉 TechCrunch。
该团队已利用这些数据对机器人进行了基准任务的训练,例如折叠T恤、压平纸箱,以及将AirPods装入充电盒等。
无限自由度
该公司计划在数据金字塔的三个层级上开展工作。最有价值的层级是针对实际部署中的机器人收集的遥操作数据;其次是像GELLO那样通过遥操作机器人收集的更通用数据;最后是人类执行日常任务时收集的“自我中心”数据,为此XDOF计划开发自己的可穿戴传感器。
“你选择的摄像头将影响数据质量——进而影响手部追踪算法的性能,”吴表示。“如果一开始就没有设计好硬件,你收集到的数据可能会出现一些你未曾预料到的特定问题。”
该公司计划在全球范围内招聘并培训大批远程操作员和以自我为中心的数据操作员——这种劳动密集型模式引发了一个显而易见的问题:为什么主要的研究实验室不自己来做这项数据生产工作呢?
“你需要一个拥有数十万平方英尺面积、配备数百台机器人的仓库,”吴说,“你还需要维护这些机器人,校准它们的物理参数,并妥善培训操作员。”
这种建设需要专注力、资本和运营规模,而大多数人工智能实验室更愿意将这些工作外包——这正是XDOF押注的市场。
XDOF 这个名字源自机器人术语“自由度”(degrees of freedom),该术语描述了机器人能够执行的独立运动数量。你的手臂,从肩膀到手腕,有七个自由度。 类人机器人公司Figure.AI的最新机器人拥有30个自由度。公司名称中的“X”体现了其雄心壮志:“任意自由度,无限自由度,”吴表示。
相关文章
 华为千问发布融合鸿蒙系统与大模型的AI教育解决方案
在首届华为鸿蒙教育AI峰会上,华为及其生态合作伙伴发布了一项全面的教育AI战略以及全场景校园解决方案。该举措标志着教育数字化转型进入关键阶段,由分布式技术和大语言模型驱动。核心技术:融合鸿蒙分布式能力与AI模型更新后的解决方案利用鸿蒙操作系统的分布式架构,打破设备间的硬件壁垒。这使得各类教学终端能够实现无缝协作,构建起强大且互联的数字基础设施。此外,通过集成AI大模型,系统获得了智能核心,从而提升了应对复杂教育需求的理解与响应能力。全面覆盖:全校园场景的智能升级该全场景校园解决方案超越了
英伟达首席执行官黄仁勋驳斥人工智能末日论,称2030年发生灾难的概率为零
在CBS新闻最近的一次采访中,英伟达联合创始人兼首席执行官黄仁勋驳斥了某些研究人员的警告,即人工智能可能在几年内导致人类灭绝,他将这种末日叙事称为夸大其词。“2030年不会是世界的终结,”黄仁勋表示。“概率为零。制造恐惧是不负责任且不必要的。”回应考克森的言论:缺乏科学依据黄仁勋的评论是对前Anthropic研究人员雅各布·考克森的直接回应,后者认为Anthropic和OpenAI等公司正在鲁莽地竞相构建自我改进的超级智能系统,从而危及人类。这一观点引发了更广泛的辩论,促使达里奥·阿莫迪和
OpenAI 推出 GPT-Live-1 API,支持中断处理、工具调用和电话代理
OpenAI 已正式推出 GPT-Live-1,这是一款旨在赋能构建全双工实时语音应用的开发者 API 模型。此次发布标志着 AI 语音交互的重大转变,从传统的分段处理迈向流畅、自然的对话模式。在技术层面,GPT-Live-1 将语音理解和生成统一于单一模型中。通过消除串联独立的语音转文本、推理和文本转语音阶段所带来的延迟,它实现了近乎即时的响应时间。该模型原生支持全双工交互,能够同时监听和说话,并准确管理中断、停顿和背景噪音。除了无缝交互外,GPT-Live-1 还提供了广泛的自定义选项。开发
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (0)
0/500
两周前,OpenAI宣布将重启其于2021年关闭的机器人项目——这是主要人工智能实验室竞相教机器如何在物理世界中运作的最新迹象。但要制造出功能强大的机器人,需要人工智能行业目前仍缺乏的一样东西:与语言模型所用数据相当的训练数据。
这一缺口正在催生一种新型基础设施业务。与基于海量公开文本进行训练的语言模型(LLMs)不同,机器人需要能够捕捉物理交互的数据——而此类数据几乎不存在。YouTube视频和零工经济从业者拍摄的素材保真度较低,且难以与物理世界进行对齐。
今日正式出道的XDOF(发音为“ecks-doff”)认为,人工智能领域的下一个主要瓶颈不会是模型或芯片,而是教机器人如何与物理世界互动所需的数据反馈循环。
这家初创公司致力于构建数据管道、采集工具和标注系统——这些正是前沿实验室和机器人公司难以独立开发的内容——为此,该公司已从 Thrive Capital、Spark Capital、a16z、Lux 和 WndrCo 处筹集了 7000 万美元资金。 联合创始人兼首席执行官菲利普·吴(Philippe Wu)表示,XDOF目前拥有约60名员工,已与20家客户展开合作,其中包括多家前沿AI实验室,但他无法透露具体名称。
“所有顶尖实验室都在尝试进军机器人领域,”吴表示,“我们已经看到在语言模型竞赛中稍稍落后所带来的某些弊端……你肯定不希望最终陷入这种境地:当大家都在物理人工智能这一下一个前沿领域齐头并进时,你却因追求这项技术太晚而落后。”
吴在加州大学伯克利分校攻读博士期间就亲身经历了这一问题。他的研究重点是让机器人能够从大规模数据集中学习技能。但有一个问题。
“我们没有大规模数据可供使用,”他告诉TechCrunch。“这就像一个‘鸡生蛋还是蛋生鸡’的问题——我们首先需要实际收集数据,才能开始探讨如何为机器人学训练基础模型。”
吴与他日后的XDOF联合创始人兼首席技术官弗雷德·申图(Fred Shentu)共同开展了一个名为GELLO的项目,这是一个低成本的遥操作系统,允许人类操作员控制机械臂来生成训练数据。 “这最终成为了一篇在机器人领域极具影响力的论文,因为许多人面临着类似的需求和瓶颈,许多人开始利用此类设备进行数据采集,”吴表示。
敏锐地捕捉到这一机遇,吴、申图以及第三位联合创始人兼首席运营官金尼莫于2024年10月共同创立了XDOF,旨在为致力于研发机器人模型的企业提供数据生态系统。 考虑到仅提供数据可能是一条死胡同,该公司还专注于数据清洗、工具开发和标注——为机器人训练者构建一个自我强化的反馈循环。
作为起点,该公司正与加州大学伯克利分校的人工智能研究实验室合作,发布其认为迄今为止规模最大的高质量机器人训练数据集,名为ABC。该数据集包含13万条机器人操作轨迹数据、300小时的模拟数据以及100小时的评估数据。 此前,学术界从未拥有过如此大规模的预训练数据。
“我们在语言、图像生成及其他领域看到,当模型和数据发布后,研究社区往往能取得超出预期的成果,”协助组织此次数据发布的伯克利大学博士生大卫·麦卡利斯特(David McAllister)告诉 TechCrunch。
该团队已利用这些数据对机器人进行了基准任务的训练,例如折叠T恤、压平纸箱,以及将AirPods装入充电盒等。
无限自由度
该公司计划在数据金字塔的三个层级上开展工作。最有价值的层级是针对实际部署中的机器人收集的遥操作数据;其次是像GELLO那样通过遥操作机器人收集的更通用数据;最后是人类执行日常任务时收集的“自我中心”数据,为此XDOF计划开发自己的可穿戴传感器。
“你选择的摄像头将影响数据质量——进而影响手部追踪算法的性能,”吴表示。“如果一开始就没有设计好硬件,你收集到的数据可能会出现一些你未曾预料到的特定问题。”
该公司计划在全球范围内招聘并培训大批远程操作员和以自我为中心的数据操作员——这种劳动密集型模式引发了一个显而易见的问题:为什么主要的研究实验室不自己来做这项数据生产工作呢?
“你需要一个拥有数十万平方英尺面积、配备数百台机器人的仓库,”吴说,“你还需要维护这些机器人,校准它们的物理参数,并妥善培训操作员。”
这种建设需要专注力、资本和运营规模,而大多数人工智能实验室更愿意将这些工作外包——这正是XDOF押注的市场。
XDOF 这个名字源自机器人术语“自由度”(degrees of freedom),该术语描述了机器人能够执行的独立运动数量。你的手臂,从肩膀到手腕,有七个自由度。 类人机器人公司Figure.AI的最新机器人拥有30个自由度。公司名称中的“X”体现了其雄心壮志:“任意自由度,无限自由度,”吴表示。








 华为千问发布融合鸿蒙系统与大模型的AI教育解决方案
在首届华为鸿蒙教育AI峰会上,华为及其生态合作伙伴发布了一项全面的教育AI战略以及全场景校园解决方案。该举措标志着教育数字化转型进入关键阶段,由分布式技术和大语言模型驱动。核心技术:融合鸿蒙分布式能力与AI模型更新后的解决方案利用鸿蒙操作系统的分布式架构,打破设备间的硬件壁垒。这使得各类教学终端能够实现无缝协作,构建起强大且互联的数字基础设施。此外,通过集成AI大模型,系统获得了智能核心,从而提升了应对复杂教育需求的理解与响应能力。全面覆盖:全校园场景的智能升级该全场景校园解决方案超越了
 英伟达首席执行官黄仁勋驳斥人工智能末日论,称2030年发生灾难的概率为零
在CBS新闻最近的一次采访中,英伟达联合创始人兼首席执行官黄仁勋驳斥了某些研究人员的警告,即人工智能可能在几年内导致人类灭绝,他将这种末日叙事称为夸大其词。“2030年不会是世界的终结,”黄仁勋表示。“概率为零。制造恐惧是不负责任且不必要的。”回应考克森的言论:缺乏科学依据黄仁勋的评论是对前Anthropic研究人员雅各布·考克森的直接回应,后者认为Anthropic和OpenAI等公司正在鲁莽地竞相构建自我改进的超级智能系统,从而危及人类。这一观点引发了更广泛的辩论,促使达里奥·阿莫迪和
 OpenAI 推出 GPT-Live-1 API,支持中断处理、工具调用和电话代理
OpenAI 已正式推出 GPT-Live-1,这是一款旨在赋能构建全双工实时语音应用的开发者 API 模型。此次发布标志着 AI 语音交互的重大转变,从传统的分段处理迈向流畅、自然的对话模式。在技术层面,GPT-Live-1 将语音理解和生成统一于单一模型中。通过消除串联独立的语音转文本、推理和文本转语音阶段所带来的延迟,它实现了近乎即时的响应时间。该模型原生支持全双工交互,能够同时监听和说话,并准确管理中断、停顿和背景噪音。除了无缝交互外,GPT-Live-1 还提供了广泛的自定义选项。开发
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai












