
вариант
Дом
Срочные новости
Содержание
AlbertKing
AlbertKing
21 июля 2026 г.

Группа XPeng представила TuringViT — высокоэффективный визуальный кодер, который перестраивает архитектуру, набор данных и процесс обучения для создания недорогих визуальных трансформеров, соответствующих современному уровню техники (SOTA). Он находит применение в системах интеллектуального вождения, приборных панелях и гуманоидных роботах. Используя всего 0,85 млрд пар «изображение-текст», он достигает точности 83,6 % в режиме zero-shot по шести тестам, превосходя по результатам модели, обученные на 10 млрд данных, при этом обеспечивая в 3 раза большую пропускную способность при вычислениях в режиме инференции при высоких разрешениях.
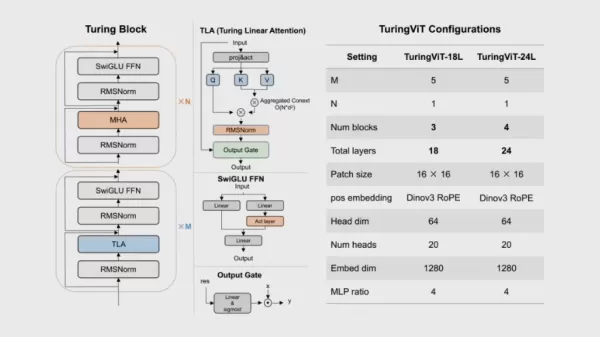
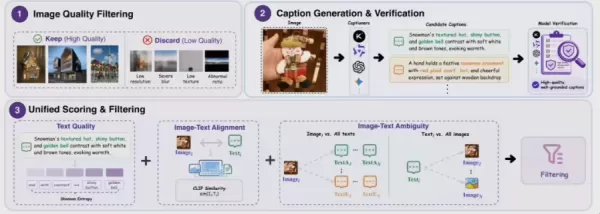
Группа XPeng представила TuringViT — высокоэффективный визуальный кодер, который перестраивает архитектуру, набор данных и процесс обучения для создания недорогих визуальных трансформеров, соответствующих современному уровню техники (SOTA). Он находит применение в системах интеллектуального вождения, приборных панелях и гуманоидных роботах. Используя всего 0,85 млрд пар «изображение-текст», он достигает точности 83,6 % в режиме zero-shot по шести тестам, превосходя по результатам модели, обученные на 10 млрд данных, при этом обеспечивая в 3 раза большую пропускную способность при вычислениях в режиме инференции при высоких разрешениях. Группа XPeng представила TuringViT — высокоэффективный визуальный кодер, который перестраивает архитектуру, набор данных и процесс обучения для создания недорогих визуальных трансформеров, соответствующих современному уровню техники (SOTA). Он находит применение в системах интеллектуального вождения, приборных панелях и гуманоидных роботах. Используя всего 0,85 млрд пар «изображение-текст», он достигает точности 83,6 % в режиме zero-shot по шести тестам, превосходя по результатам модели, обученные на 10 млрд данных, при этом обеспечивая в 3 раза большую пропускную способность при вычислениях в режиме инференции при высоких разрешениях. Группа XPeng представила TuringViT — высокоэффективный визуальный кодер, который перестраивает архитектуру, набор данных и процесс обучения для создания недорогих визуальных трансформеров, соответствующих современному уровню техники (SOTA). Он находит применение в системах интеллектуального вождения, приборных панелях и гуманоидных роботах. Используя всего 0,85 млрд пар «изображение-текст», он достигает точности 83,6 % в режиме zero-shot по шести тестам, превосходя по результатам модели, обученные на 10 млрд данных, при этом обеспечивая в 3 раза большую пропускную способность при вычислениях в режиме инференции при высоких разрешениях.
Автор JamesBaker JamesBaker 30 сентября 2026 г.
Компания LG Electronics в сотрудничестве с Microsoft представила на отраслевом саммите в Сеуле голосового помощника на базе искусственного интеллекта для своего хаба «умного дома» ThinQ ON. Благодаря использованию технологии «Speech to Speech» и сервиса Microsoft Voice Live система поддерживает естественные перерывы в разговоре, позволяя пользователям менять тему в середине беседы, не дожидаясь ответа. Это решает типичные проблемы, связанные с негибкими голосовыми помощниками. Эта функция будет запущена в этом году и станет доступна существующим пользователям посредством обновлений; она ориентирована как на жилой, так и на коммерческий сектор, включая отели и офисы. Компания LG стремится обеспечить себе конкурентное преимущество на рынке «умного дома», предлагая пользователям возможность вести диалог, по своему характеру не уступающий общению с человеком.
Автор NoahGreen NoahGreen 30 сентября 2026 г.
OR