
옵션
집
속보
콘텐츠
AlbertKing
AlbertKing
2026년 7월 21일

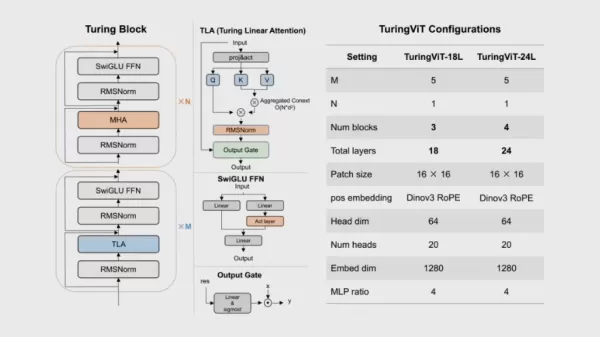
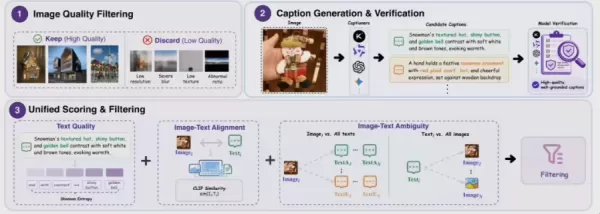
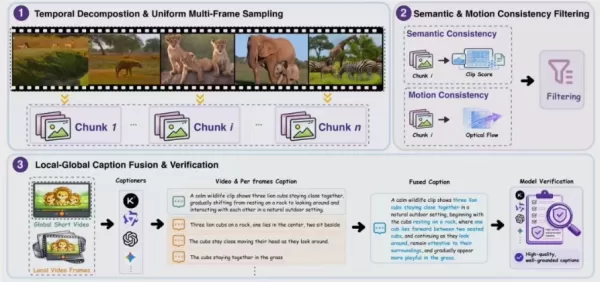
XPeng Group은 저비용 SOTA 시각 트랜스포머를 위해 아키텍처, 데이터 및 훈련 방식을 재구성한 효율적인 시각 인코더인 ‘TuringViT’를 출시했습니다. 이 모델은 자율주행, 차량 계기판, 휴머노이드 로봇을 지원합니다. 단 0.85B개의 이미지-텍스트 쌍만을 사용하여 6가지 벤치마크에서 83.6%의 제로샷 정확도를 달성했으며, 10B 데이터로 훈련된 모델보다 우수한 성능을 보였을 뿐만 아니라 고해상도 환경에서 3배 더 높은 추론 처리량을 기록했습니다.
XPeng Group은 저비용 SOTA 시각 트랜스포머를 위해 아키텍처, 데이터 및 훈련 방식을 재구성한 효율적인 시각 인코더인 ‘TuringViT’를 출시했습니다. 이 모델은 자율주행, 차량 계기판, 휴머노이드 로봇을 지원합니다. 단 0.85B개의 이미지-텍스트 쌍만을 사용하여 6가지 벤치마크에서 83.6%의 제로샷 정확도를 달성했으며, 10B 데이터로 훈련된 모델보다 우수한 성능을 보였을 뿐만 아니라 고해상도 환경에서 3배 더 높은 추론 처리량을 기록했습니다. XPeng Group은 저비용 SOTA 시각 트랜스포머를 위해 아키텍처, 데이터 및 훈련 방식을 재구성한 효율적인 시각 인코더인 ‘TuringViT’를 출시했습니다. 이 모델은 자율주행, 차량 계기판, 휴머노이드 로봇을 지원합니다. 단 0.85B개의 이미지-텍스트 쌍만을 사용하여 6가지 벤치마크에서 83.6%의 제로샷 정확도를 달성했으며, 10B 데이터로 훈련된 모델보다 우수한 성능을 보였을 뿐만 아니라 고해상도 환경에서 3배 더 높은 추론 처리량을 기록했습니다. XPeng Group은 저비용 SOTA 시각 트랜스포머를 위해 아키텍처, 데이터 및 훈련 방식을 재구성한 효율적인 시각 인코더인 ‘TuringViT’를 출시했습니다. 이 모델은 자율주행, 차량 계기판, 휴머노이드 로봇을 지원합니다. 단 0.85B개의 이미지-텍스트 쌍만을 사용하여 6가지 벤치마크에서 83.6%의 제로샷 정확도를 달성했으며, 10B 데이터로 훈련된 모델보다 우수한 성능을 보였을 뿐만 아니라 고해상도 환경에서 3배 더 높은 추론 처리량을 기록했습니다.
의견 (0)
0/300
OR