
opción
Hogar
Última hora
Contenido
AlbertKing
AlbertKing
21 de julio de 2026

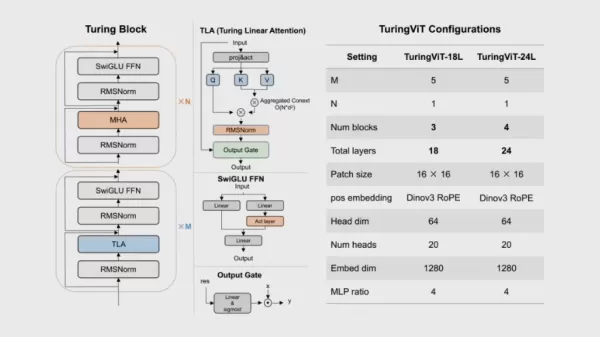
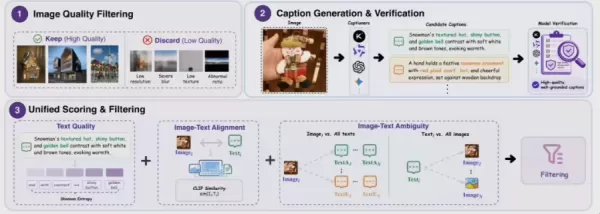
El Grupo XPeng ha lanzado TuringViT, un codificador visual eficiente que reestructura la arquitectura, los datos y el entrenamiento para obtener transformadores visuales de vanguardia (SOTA) a bajo coste. Es compatible con la conducción inteligente, las cabinas de pilotaje y los robots humanoides. Utilizando tan solo 0,85 mil millones de pares de imágenes y texto, alcanza una precisión del 83,6 % en modo «zero-shot» en seis pruebas de referencia, superando a modelos entrenados con 10 mil millones de datos, con un rendimiento de inferencia tres veces superior a alta resolución.
El Grupo XPeng ha lanzado TuringViT, un codificador visual eficiente que reestructura la arquitectura, los datos y el entrenamiento para obtener transformadores visuales de vanguardia (SOTA) a bajo coste. Es compatible con la conducción inteligente, las cabinas de pilotaje y los robots humanoides. Utilizando tan solo 0,85 mil millones de pares de imágenes y texto, alcanza una precisión del 83,6 % en modo «zero-shot» en seis pruebas de referencia, superando a modelos entrenados con 10 mil millones de datos, con un rendimiento de inferencia tres veces superior a alta resolución. El Grupo XPeng ha lanzado TuringViT, un codificador visual eficiente que reestructura la arquitectura, los datos y el entrenamiento para obtener transformadores visuales de vanguardia (SOTA) a bajo coste. Es compatible con la conducción inteligente, las cabinas de pilotaje y los robots humanoides. Utilizando tan solo 0,85 mil millones de pares de imágenes y texto, alcanza una precisión del 83,6 % en modo «zero-shot» en seis pruebas de referencia, superando a modelos entrenados con 10 mil millones de datos, con un rendimiento de inferencia tres veces superior a alta resolución. El Grupo XPeng ha lanzado TuringViT, un codificador visual eficiente que reestructura la arquitectura, los datos y el entrenamiento para obtener transformadores visuales de vanguardia (SOTA) a bajo coste. Es compatible con la conducción inteligente, las cabinas de pilotaje y los robots humanoides. Utilizando tan solo 0,85 mil millones de pares de imágenes y texto, alcanza una precisión del 83,6 % en modo «zero-shot» en seis pruebas de referencia, superando a modelos entrenados con 10 mil millones de datos, con un rendimiento de inferencia tres veces superior a alta resolución.
comentario (0)
0/300
OR