
オプション
家
速報
コンテンツ
AlbertKing
AlbertKing
2026年7月21日

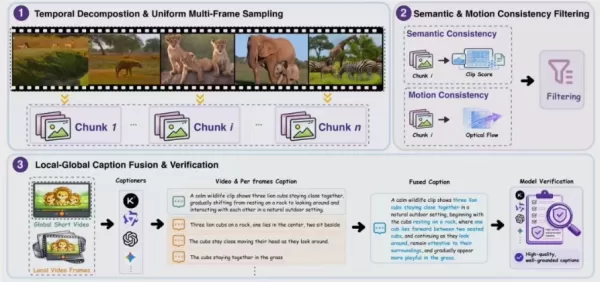
XPeng Groupは、低コストで最先端(SOTA)のビジュアルトランスフォーマーを実現するため、アーキテクチャ、データ、学習手法を再構築した高効率なビジュアルエンコーダー「TuringViT」を発表しました。本モデルは、自動運転、コックピット、ヒューマノイドロボットに対応しています。 わずか0.85Bの画像・テキストペアのみを使用し、6つのベンチマークで83.6%のゼロショット精度を達成。10Bのデータで学習されたモデルを上回る性能を発揮するとともに、高解像度環境において3倍の推論スループットを実現しています。
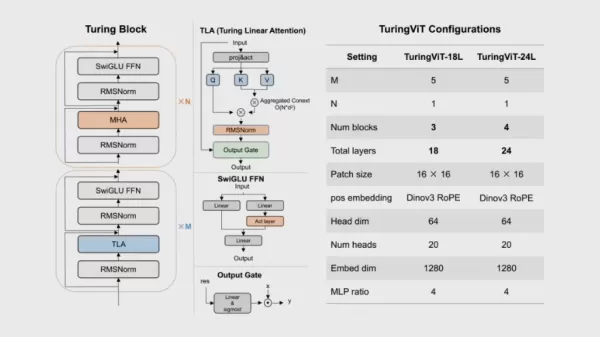
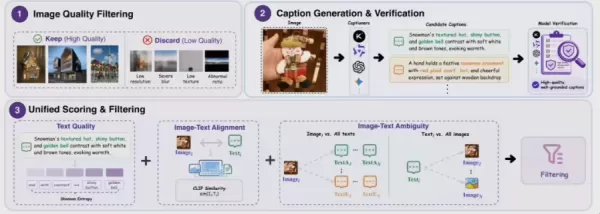
XPeng Groupは、低コストで最先端(SOTA)のビジュアルトランスフォーマーを実現するため、アーキテクチャ、データ、学習手法を再構築した高効率なビジュアルエンコーダー「TuringViT」を発表しました。本モデルは、自動運転、コックピット、ヒューマノイドロボットに対応しています。 わずか0.85Bの画像・テキストペアのみを使用し、6つのベンチマークで83.6%のゼロショット精度を達成。10Bのデータで学習されたモデルを上回る性能を発揮するとともに、高解像度環境において3倍の推論スループットを実現しています。 XPeng Groupは、低コストで最先端(SOTA)のビジュアルトランスフォーマーを実現するため、アーキテクチャ、データ、学習手法を再構築した高効率なビジュアルエンコーダー「TuringViT」を発表しました。本モデルは、自動運転、コックピット、ヒューマノイドロボットに対応しています。 わずか0.85Bの画像・テキストペアのみを使用し、6つのベンチマークで83.6%のゼロショット精度を達成。10Bのデータで学習されたモデルを上回る性能を発揮するとともに、高解像度環境において3倍の推論スループットを実現しています。 XPeng Groupは、低コストで最先端(SOTA)のビジュアルトランスフォーマーを実現するため、アーキテクチャ、データ、学習手法を再構築した高効率なビジュアルエンコーダー「TuringViT」を発表しました。本モデルは、自動運転、コックピット、ヒューマノイドロボットに対応しています。 わずか0.85Bの画像・テキストペアのみを使用し、6つのベンチマークで83.6%のゼロショット精度を達成。10Bのデータで学習されたモデルを上回る性能を発揮するとともに、高解像度環境において3倍の推論スループットを実現しています。
コメント (0)
0/300
OR