
opção
AlbertKing
AlbertKing
21 de Julho de 2026

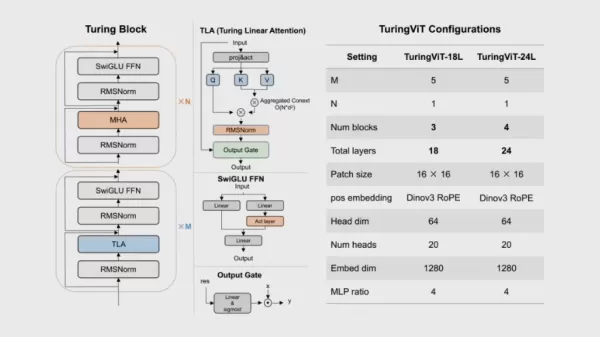
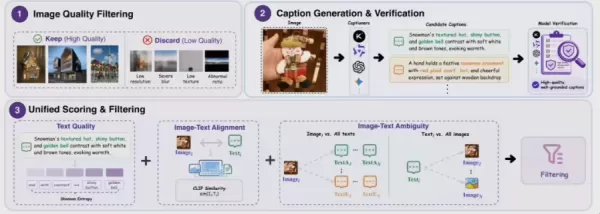
O Grupo XPeng lançou o TuringViT, um codificador visual eficiente que reestrutura a arquitetura, os dados e o treinamento para transformadores visuais de ponta (SOTA) de baixo custo. Ele oferece suporte à direção inteligente, cockpits e robôs humanóides. Utilizando apenas 0,85 bilhão de pares de imagem-texto, ele atinge 83,6% de precisão em modo “zero-shot” em seis benchmarks, superando modelos treinados com 10 bilhões de dados, com uma taxa de processamento de inferência três vezes maior em altas resoluções.
O Grupo XPeng lançou o TuringViT, um codificador visual eficiente que reestrutura a arquitetura, os dados e o treinamento para transformadores visuais de ponta (SOTA) de baixo custo. Ele oferece suporte à direção inteligente, cockpits e robôs humanóides. Utilizando apenas 0,85 bilhão de pares de imagem-texto, ele atinge 83,6% de precisão em modo “zero-shot” em seis benchmarks, superando modelos treinados com 10 bilhões de dados, com uma taxa de processamento de inferência três vezes maior em altas resoluções. O Grupo XPeng lançou o TuringViT, um codificador visual eficiente que reestrutura a arquitetura, os dados e o treinamento para transformadores visuais de ponta (SOTA) de baixo custo. Ele oferece suporte à direção inteligente, cockpits e robôs humanóides. Utilizando apenas 0,85 bilhão de pares de imagem-texto, ele atinge 83,6% de precisão em modo “zero-shot” em seis benchmarks, superando modelos treinados com 10 bilhões de dados, com uma taxa de processamento de inferência três vezes maior em altas resoluções. O Grupo XPeng lançou o TuringViT, um codificador visual eficiente que reestrutura a arquitetura, os dados e o treinamento para transformadores visuais de ponta (SOTA) de baixo custo. Ele oferece suporte à direção inteligente, cockpits e robôs humanóides. Utilizando apenas 0,85 bilhão de pares de imagem-texto, ele atinge 83,6% de precisão em modo “zero-shot” em seis benchmarks, superando modelos treinados com 10 bilhões de dados, com uma taxa de processamento de inferência três vezes maior em altas resoluções.
Comentários (0)
0/300
OR