


 Дом
По умолчанию Twitch использует контент стримеров для обучения модели искусственного интеллекта Amazon, что вызвало негативную реакцию со стороны сообщества
Twitch, ведущий сервис прямых трансляций, объявил о планах использовать контент трансляций авторов для обучения генеративных моделей искусственного интеллекта в интересах своей материнской компании Amazon. Это решение вызвало значительную негативную реакцию со стороны сообщества авторов, в частности из-за предусмотренного политикой механизма «подписки по умолчанию». В соответствии с этой схемой стримеры должны самостоятельно отказаться от участия, чтобы их аудио- и видеоматериалы не использовались для обучения ИИ — процесс, который многие считают нелогичным и который легко упустить из виду.
Во время недавней сессии вопросов и ответов (AMA) на официальном канале Twitch менеджер сообщества Мэри Киш и директор по продуктам Майк Минтон ответили на вопросы почти 3 000 зрителей. Столкнувшись с многочисленными вопросами о том, почему настройка не была «отказ по умолчанию», Минтон прямо заявил, что отказ по умолчанию привел бы к ничтожному уровню добровольного участия.
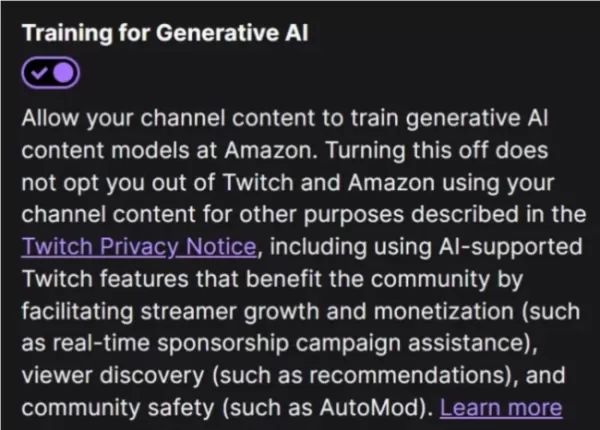
Руководство Twitch признало, что платформа осознает широкий скептицизм в отношении генеративного ИИ, отметив, что большинство систем ИИ в настоящее время обучаются на общедоступных интернет-данных без явного согласия авторов. Чтобы смягчить негативную реакцию, Twitch представил эту инициативу как опциональную функцию отказа в рамках более широких усилий Amazon по обучению ИИ. Однако такой подход вызвал у многих стримеров беспокойство и недоумение по поводу того, не собираются ли их материалы уже сейчас без их ведома.
Киш пояснил, что предложение возможности отказа соответствует твердой позиции сообщества, выступающего против участия в обучении ИИ. Несмотря на предоставление такого выбора, этот шаг подчеркивает сохраняющееся напряжение между технологическими платформами и авторами в отношении авторских прав и права собственности на данные — конфликт, который наблюдается и в других крупных технологических компаниях, использующих общедоступные данные для разработки ИИ.
Стримеры, желающие исключить свой контент из обучения ИИ, в настоящее время могут отключить настройку «Обучение генеративному ИИ». Эта опция находится на вкладке «Безопасность и конфиденциальность» в настройках канала, отдельно от панели управления автором. Пользователи должны вручную отключить эту функцию, чтобы их контент не использовался.
Связанная статья
 Новая компания в сфере образования AI JiShu привлекла миллионы и запускает стратегию, сочетающую программное и аппаратное обеспечение
По мере того как искусственный интеллект продолжает преобразовывать различные отрасли, в сфере образования наблюдается прорыв, связанный с появлением нового многообещающего игрока. 22 апреля компания
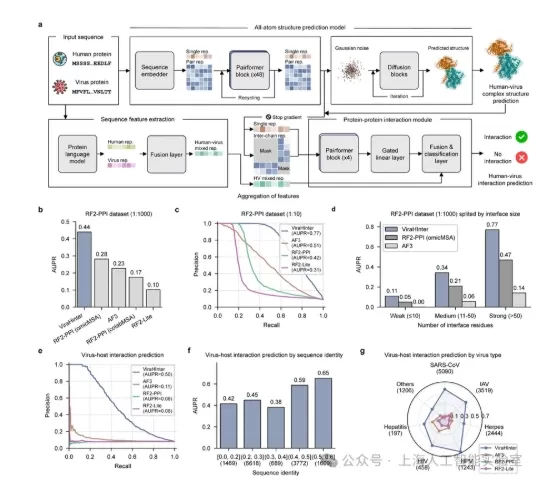
Шанхайская лаборатория искусственного интеллекта представила систему ViraHInter для ускорения разработки противовирусных препаратов
Шанхайская лаборатория искусственного интеллекта в партнерстве с Университетом Фудань, больницей Руйцзинь при Медицинском факультете Шанхайского университета Цзяотун и Шанхайским институтом вирусологи
На долю Пекина приходится почти 30 % заявок на крупные модели в Китае, из которых 225 были одобрены Управлением по киберпространству, что позволяет городу сохранять лидерство в области инноваций в сфере искусственного интеллекта
По мере того как крупные модели искусственного интеллекта переходят от этапа инноваций к этапу соблюдения нормативных требований, Пекин укрепляет свой статус центра инноваций в области ИИ в Китае. По
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (0)
Twitch, ведущий сервис прямых трансляций, объявил о планах использовать контент трансляций авторов для обучения генеративных моделей искусственного интеллекта в интересах своей материнской компании Amazon. Это решение вызвало значительную негативную реакцию со стороны сообщества авторов, в частности из-за предусмотренного политикой механизма «подписки по умолчанию». В соответствии с этой схемой стримеры должны самостоятельно отказаться от участия, чтобы их аудио- и видеоматериалы не использовались для обучения ИИ — процесс, который многие считают нелогичным и который легко упустить из виду.
Во время недавней сессии вопросов и ответов (AMA) на официальном канале Twitch менеджер сообщества Мэри Киш и директор по продуктам Майк Минтон ответили на вопросы почти 3 000 зрителей. Столкнувшись с многочисленными вопросами о том, почему настройка не была «отказ по умолчанию», Минтон прямо заявил, что отказ по умолчанию привел бы к ничтожному уровню добровольного участия.
Руководство Twitch признало, что платформа осознает широкий скептицизм в отношении генеративного ИИ, отметив, что большинство систем ИИ в настоящее время обучаются на общедоступных интернет-данных без явного согласия авторов. Чтобы смягчить негативную реакцию, Twitch представил эту инициативу как опциональную функцию отказа в рамках более широких усилий Amazon по обучению ИИ. Однако такой подход вызвал у многих стримеров беспокойство и недоумение по поводу того, не собираются ли их материалы уже сейчас без их ведома.
Киш пояснил, что предложение возможности отказа соответствует твердой позиции сообщества, выступающего против участия в обучении ИИ. Несмотря на предоставление такого выбора, этот шаг подчеркивает сохраняющееся напряжение между технологическими платформами и авторами в отношении авторских прав и права собственности на данные — конфликт, который наблюдается и в других крупных технологических компаниях, использующих общедоступные данные для разработки ИИ.
Стримеры, желающие исключить свой контент из обучения ИИ, в настоящее время могут отключить настройку «Обучение генеративному ИИ». Эта опция находится на вкладке «Безопасность и конфиденциальность» в настройках канала, отдельно от панели управления автором. Пользователи должны вручную отключить эту функцию, чтобы их контент не использовался.








 Новая компания в сфере образования AI JiShu привлекла миллионы и запускает стратегию, сочетающую программное и аппаратное обеспечение
По мере того как искусственный интеллект продолжает преобразовывать различные отрасли, в сфере образования наблюдается прорыв, связанный с появлением нового многообещающего игрока. 22 апреля компания
 Шанхайская лаборатория искусственного интеллекта представила систему ViraHInter для ускорения разработки противовирусных препаратов
Шанхайская лаборатория искусственного интеллекта в партнерстве с Университетом Фудань, больницей Руйцзинь при Медицинском факультете Шанхайского университета Цзяотун и Шанхайским институтом вирусологи
 На долю Пекина приходится почти 30 % заявок на крупные модели в Китае, из которых 225 были одобрены Управлением по киберпространству, что позволяет городу сохранять лидерство в области инноваций в сфере искусственного интеллекта
По мере того как крупные модели искусственного интеллекта переходят от этапа инноваций к этапу соблюдения нормативных требований, Пекин укрепляет свой статус центра инноваций в области ИИ в Китае. По

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai












