


 Hogar
Twitch utiliza por defecto el contenido de los streamers para entrenar el modelo de IA de Amazon, lo que ha provocado una reacción negativa por parte de la comunidad
Twitch, el servicio líder de retransmisiones en directo, ha anunciado sus planes de aprovechar el contenido de las retransmisiones de los creadores para entrenar modelos de IA generativa para su empresa matriz, Amazon. Esta decisión ha desencadenado una fuerte reacción negativa por parte de la comunidad de creadores, sobre todo debido al mecanismo predeterminado de «aceptación implícita» de la política. En este marco, los streamers deben optar activamente por no participar para evitar que su audio y vídeo se utilicen para el entrenamiento de la IA, un proceso que a muchos les parece poco intuitivo y que podría pasarse por alto.
Durante una reciente sesión de preguntas y respuestas (AMA) en el canal oficial de Twitch, la gestora de la comunidad, Mary Kish, y el director de producto, Mike Minton, respondieron a las preguntas de casi 3.000 espectadores. Ante las numerosas preguntas sobre por qué la configuración no era de «exclusión por defecto», Minton afirmó sin rodeos que una exclusión por defecto daría lugar a una participación voluntaria insignificante.
Los directivos de Twitch reconocieron que la plataforma es consciente del amplio escepticismo que rodea a la IA generativa, y señalaron que la mayoría de los sistemas de IA se entrenan actualmente con datos de Internet disponibles públicamente sin el consentimiento explícito de los creadores. Para mitigar las reacciones negativas, Twitch presentó la iniciativa como una función opcional de exclusión voluntaria dentro de los esfuerzos más amplios de Amazon en materia de entrenamiento de IA. Sin embargo, este enfoque ha dejado a muchos streamers preocupados y confundidos sobre si su contenido ya está siendo recopilado sin su conocimiento.
Kish explicó que ofrecer la posibilidad de excluirse se ajusta a la firme postura de la comunidad en contra de contribuir al entrenamiento de la IA. A pesar de ofrecer esta opción, la medida pone de relieve la tensión existente entre las plataformas tecnológicas y los creadores en lo que respecta a los derechos de autor y la propiedad de los datos —un conflicto que se refleja en otras grandes empresas tecnológicas que utilizan datos públicos para el desarrollo de la IA.
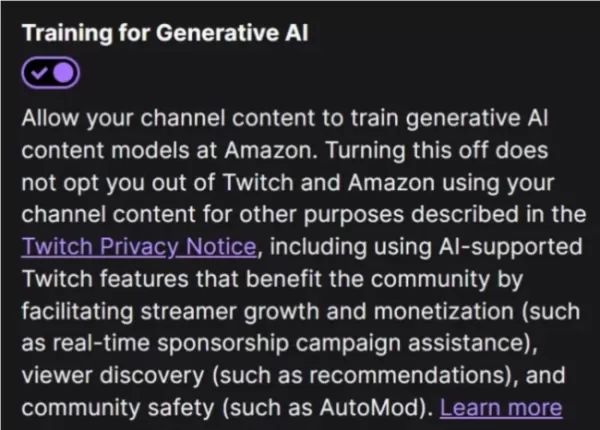
Los streamers que deseen excluir su contenido del entrenamiento de la IA pueden, actualmente, desactivar la opción «Entrenamiento de IA generativa». Esta opción se encuentra en la pestaña «Seguridad y privacidad» de la configuración del canal, que es distinta del Panel de control del creador. Los usuarios deben desactivar manualmente esta función para asegurarse de que su contenido no se utilice.
Artículo relacionado
 La empresa emergente de educación en IA, JiShu, recauda millones y lanza una estrategia de software y hardware
A medida que la inteligencia artificial sigue transformando los sectores, el ámbito educativo está experimentando un gran avance con la aparición de un nuevo y prometedor actor. El 22 de abril, Guangz
El Laboratorio de IA de Shanghái presenta ViraHInter para impulsar el descubrimiento de fármacos antivirales
El Laboratorio de Inteligencia Artificial de Shanghái, en colaboración con la Universidad de Fudan, el Hospital Ruijin, adscrito a la Facultad de Medicina de la Universidad Jiao Tong de Shanghái, y el
Pekín representa casi el 30 % de las solicitudes de modelos a gran escala presentadas en China, de las cuales 225 han sido aprobadas por la Administración del Ciberespacio, lo que le permite mantener su liderazgo en innovación en inteligencia artificial.
A medida que los grandes modelos de IA pasan de la innovación al cumplimiento normativo, Pekín está consolidando su estatus como centro de innovación en IA de China. La Oficina Municipal de Economía y
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
Twitch, el servicio líder de retransmisiones en directo, ha anunciado sus planes de aprovechar el contenido de las retransmisiones de los creadores para entrenar modelos de IA generativa para su empresa matriz, Amazon. Esta decisión ha desencadenado una fuerte reacción negativa por parte de la comunidad de creadores, sobre todo debido al mecanismo predeterminado de «aceptación implícita» de la política. En este marco, los streamers deben optar activamente por no participar para evitar que su audio y vídeo se utilicen para el entrenamiento de la IA, un proceso que a muchos les parece poco intuitivo y que podría pasarse por alto.
Durante una reciente sesión de preguntas y respuestas (AMA) en el canal oficial de Twitch, la gestora de la comunidad, Mary Kish, y el director de producto, Mike Minton, respondieron a las preguntas de casi 3.000 espectadores. Ante las numerosas preguntas sobre por qué la configuración no era de «exclusión por defecto», Minton afirmó sin rodeos que una exclusión por defecto daría lugar a una participación voluntaria insignificante.
Los directivos de Twitch reconocieron que la plataforma es consciente del amplio escepticismo que rodea a la IA generativa, y señalaron que la mayoría de los sistemas de IA se entrenan actualmente con datos de Internet disponibles públicamente sin el consentimiento explícito de los creadores. Para mitigar las reacciones negativas, Twitch presentó la iniciativa como una función opcional de exclusión voluntaria dentro de los esfuerzos más amplios de Amazon en materia de entrenamiento de IA. Sin embargo, este enfoque ha dejado a muchos streamers preocupados y confundidos sobre si su contenido ya está siendo recopilado sin su conocimiento.
Kish explicó que ofrecer la posibilidad de excluirse se ajusta a la firme postura de la comunidad en contra de contribuir al entrenamiento de la IA. A pesar de ofrecer esta opción, la medida pone de relieve la tensión existente entre las plataformas tecnológicas y los creadores en lo que respecta a los derechos de autor y la propiedad de los datos —un conflicto que se refleja en otras grandes empresas tecnológicas que utilizan datos públicos para el desarrollo de la IA.
Los streamers que deseen excluir su contenido del entrenamiento de la IA pueden, actualmente, desactivar la opción «Entrenamiento de IA generativa». Esta opción se encuentra en la pestaña «Seguridad y privacidad» de la configuración del canal, que es distinta del Panel de control del creador. Los usuarios deben desactivar manualmente esta función para asegurarse de que su contenido no se utilice.








 La empresa emergente de educación en IA, JiShu, recauda millones y lanza una estrategia de software y hardware
A medida que la inteligencia artificial sigue transformando los sectores, el ámbito educativo está experimentando un gran avance con la aparición de un nuevo y prometedor actor. El 22 de abril, Guangz
 El Laboratorio de IA de Shanghái presenta ViraHInter para impulsar el descubrimiento de fármacos antivirales
El Laboratorio de Inteligencia Artificial de Shanghái, en colaboración con la Universidad de Fudan, el Hospital Ruijin, adscrito a la Facultad de Medicina de la Universidad Jiao Tong de Shanghái, y el
 Pekín representa casi el 30 % de las solicitudes de modelos a gran escala presentadas en China, de las cuales 225 han sido aprobadas por la Administración del Ciberespacio, lo que le permite mantener su liderazgo en innovación en inteligencia artificial.
A medida que los grandes modelos de IA pasan de la innovación al cumplimiento normativo, Pekín está consolidando su estatus como centro de innovación en IA de China. La Oficina Municipal de Economía y

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












