


 Heim
Twitch nutzt standardmäßig Inhalte von Streamern, um das Amazon-KI-Modell zu trainieren, was in der Community für heftige Kritik sorgt
Twitch, der führende Live-Streaming-Dienst, hat Pläne angekündigt, die von Creators ausgestrahlten Inhalte zu nutzen, um generative KI-Modelle für seine Muttergesellschaft Amazon zu trainieren. Diese Entscheidung hat erhebliche Kritik seitens der Creator-Community ausgelöst, insbesondere aufgrund des standardmäßigen „Opt-in“-Mechanismus dieser Richtlinie. Im Rahmen dieses Systems müssen sich Streamer aktiv abmelden, um zu verhindern, dass ihre Audio- und Videoaufnahmen für das KI-Training verwendet werden – ein Vorgang, den viele als nicht intuitiv und potenziell leicht zu übersehen empfinden.
Während eines kürzlich abgehaltenen AMA auf dem offiziellen Twitch-Kanal beantworteten Community-Managerin Mary Kish und Chief Product Officer Mike Minton Fragen von fast 3.000 Zuschauern. Angesichts zahlreicher Anfragen, warum die Einstellung nicht standardmäßig auf „Opt-out“ gesetzt sei, erklärte Minton unverblümt, dass eine solche Standard-Opt-out-Einstellung zu einer vernachlässigbaren freiwilligen Teilnahme führen würde.
Führungskräfte von Twitch räumten ein, dass sich die Plattform der weit verbreiteten Skepsis gegenüber generativer KI bewusst sei, und wiesen darauf hin, dass die meisten KI-Systeme derzeit mit öffentlich zugänglichen Internetdaten trainiert werden, ohne dass die Urheber ausdrücklich ihre Zustimmung erteilt hätten. Um negative Reaktionen abzuschwächen, stellte Twitch die Initiative als optionale Opt-out-Funktion für Amazons umfassendere KI-Trainingsbemühungen dar. Dieser Ansatz hat jedoch bei vielen Streamern Ängste und Verwirrung darüber ausgelöst, ob ihre Inhalte bereits ohne ihr Wissen erfasst werden.
Kish erklärte, dass das Angebot einer Opt-out-Möglichkeit der entschiedenen Haltung der Community entspricht, nicht zum KI-Training beitragen zu wollen. Trotz dieser Wahlmöglichkeit unterstreicht der Schritt die anhaltenden Spannungen zwischen Technologieplattformen und Urhebern in Bezug auf Urheberrecht und Dateneigentum – ein Konflikt, der sich auch bei anderen großen Technologieunternehmen widerspiegelt, die öffentliche Daten für die KI-Entwicklung nutzen.
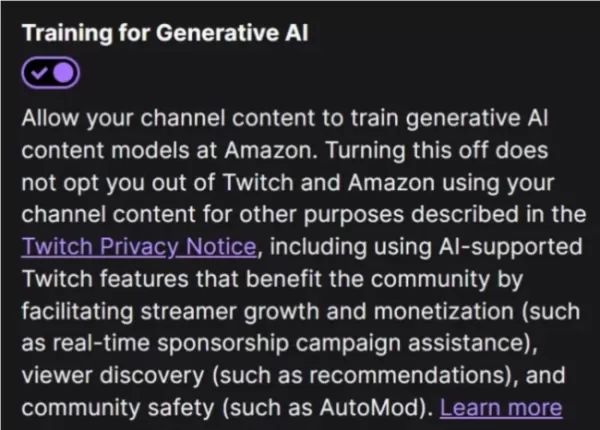
Streamer, die ihre Inhalte vom KI-Training ausschließen möchten, können derzeit die Einstellung „Generatives KI-Training“ deaktivieren. Diese Option befindet sich unter dem Reiter „Sicherheit & Datenschutz“ in den Kanaleinstellungen, getrennt vom Creator-Dashboard. Nutzer müssen diese Funktion manuell deaktivieren, um sicherzustellen, dass ihre Inhalte nicht verwendet werden.
Verwandter Artikel
 Das Start-up „Education AI JiShu“ sichert sich Millionen und startet eine Software-Hardware-Strategie
Während künstliche Intelligenz weiterhin ganze Branchen verändert, erlebt der Bildungssektor mit dem Aufkommen eines vielversprechenden neuen Akteurs einen Durchbruch. Am 22. April gab die Guangzhou J
Das Shanghai AI Lab stellt „ViraHInter“ vor, um die Entwicklung antiviraler Medikamente voranzutreiben
Das Shanghai Artificial Intelligence Lab hat in Zusammenarbeit mit der Fudan-Universität, dem Ruijin-Krankenhaus, das der Medizinischen Fakultät der Shanghai Jiao Tong-Universität angegliedert ist, un
Auf Peking entfallen fast 30 % der Anträge für große Modelle in China; 225 davon wurden von der Cyberspace-Behörde genehmigt, womit die Stadt ihre Führungsposition bei Innovationen im Bereich der künstlichen Intelligenz behauptet.
Während sich der Schwerpunkt bei großen KI-Modellen von der Innovation hin zur Einhaltung gesetzlicher Vorschriften verlagert, festigt Peking seinen Status als Chinas Zentrum für KI-Innovation. Das Pe
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Twitch, der führende Live-Streaming-Dienst, hat Pläne angekündigt, die von Creators ausgestrahlten Inhalte zu nutzen, um generative KI-Modelle für seine Muttergesellschaft Amazon zu trainieren. Diese Entscheidung hat erhebliche Kritik seitens der Creator-Community ausgelöst, insbesondere aufgrund des standardmäßigen „Opt-in“-Mechanismus dieser Richtlinie. Im Rahmen dieses Systems müssen sich Streamer aktiv abmelden, um zu verhindern, dass ihre Audio- und Videoaufnahmen für das KI-Training verwendet werden – ein Vorgang, den viele als nicht intuitiv und potenziell leicht zu übersehen empfinden.
Während eines kürzlich abgehaltenen AMA auf dem offiziellen Twitch-Kanal beantworteten Community-Managerin Mary Kish und Chief Product Officer Mike Minton Fragen von fast 3.000 Zuschauern. Angesichts zahlreicher Anfragen, warum die Einstellung nicht standardmäßig auf „Opt-out“ gesetzt sei, erklärte Minton unverblümt, dass eine solche Standard-Opt-out-Einstellung zu einer vernachlässigbaren freiwilligen Teilnahme führen würde.
Führungskräfte von Twitch räumten ein, dass sich die Plattform der weit verbreiteten Skepsis gegenüber generativer KI bewusst sei, und wiesen darauf hin, dass die meisten KI-Systeme derzeit mit öffentlich zugänglichen Internetdaten trainiert werden, ohne dass die Urheber ausdrücklich ihre Zustimmung erteilt hätten. Um negative Reaktionen abzuschwächen, stellte Twitch die Initiative als optionale Opt-out-Funktion für Amazons umfassendere KI-Trainingsbemühungen dar. Dieser Ansatz hat jedoch bei vielen Streamern Ängste und Verwirrung darüber ausgelöst, ob ihre Inhalte bereits ohne ihr Wissen erfasst werden.
Kish erklärte, dass das Angebot einer Opt-out-Möglichkeit der entschiedenen Haltung der Community entspricht, nicht zum KI-Training beitragen zu wollen. Trotz dieser Wahlmöglichkeit unterstreicht der Schritt die anhaltenden Spannungen zwischen Technologieplattformen und Urhebern in Bezug auf Urheberrecht und Dateneigentum – ein Konflikt, der sich auch bei anderen großen Technologieunternehmen widerspiegelt, die öffentliche Daten für die KI-Entwicklung nutzen.
Streamer, die ihre Inhalte vom KI-Training ausschließen möchten, können derzeit die Einstellung „Generatives KI-Training“ deaktivieren. Diese Option befindet sich unter dem Reiter „Sicherheit & Datenschutz“ in den Kanaleinstellungen, getrennt vom Creator-Dashboard. Nutzer müssen diese Funktion manuell deaktivieren, um sicherzustellen, dass ihre Inhalte nicht verwendet werden.








 Das Start-up „Education AI JiShu“ sichert sich Millionen und startet eine Software-Hardware-Strategie
Während künstliche Intelligenz weiterhin ganze Branchen verändert, erlebt der Bildungssektor mit dem Aufkommen eines vielversprechenden neuen Akteurs einen Durchbruch. Am 22. April gab die Guangzhou J
 Das Shanghai AI Lab stellt „ViraHInter“ vor, um die Entwicklung antiviraler Medikamente voranzutreiben
Das Shanghai Artificial Intelligence Lab hat in Zusammenarbeit mit der Fudan-Universität, dem Ruijin-Krankenhaus, das der Medizinischen Fakultät der Shanghai Jiao Tong-Universität angegliedert ist, un
 Auf Peking entfallen fast 30 % der Anträge für große Modelle in China; 225 davon wurden von der Cyberspace-Behörde genehmigt, womit die Stadt ihre Führungsposition bei Innovationen im Bereich der künstlichen Intelligenz behauptet.
Während sich der Schwerpunkt bei großen KI-Modellen von der Innovation hin zur Einhaltung gesetzlicher Vorschriften verlagert, festigt Peking seinen Status als Chinas Zentrum für KI-Innovation. Das Pe

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












