


 Maison
Twitch utilise par défaut le contenu des streamers pour entraîner le modèle d'IA d'Amazon, ce qui suscite une vive réaction de la communauté
Twitch, le leader des services de streaming en direct, a annoncé son intention d’utiliser le contenu diffusé par les créateurs pour entraîner des modèles d’IA générative au profit de sa société mère, Amazon. Cette décision a suscité une vive polémique au sein de la communauté des créateurs, notamment en raison du mécanisme par défaut de « consentement explicite » prévu par cette politique. Dans ce cadre, les streamers doivent expressément refuser que leurs fichiers audio et vidéo soient utilisés pour l’entraînement de l’IA — un processus que beaucoup jugent contre-intuitif et susceptible d’être négligé.
Lors d’une récente session « Ask Me Anything » (AMA) sur la chaîne officielle de Twitch, la responsable de la communauté, Mary Kish, et le directeur des produits, Mike Minton, ont répondu aux questions de près de 3 000 spectateurs. Face aux nombreuses questions demandant pourquoi le paramètre n’était pas « de désengagement par défaut », Minton a déclaré sans détour qu’un tel paramètre entraînerait une participation volontaire négligeable.
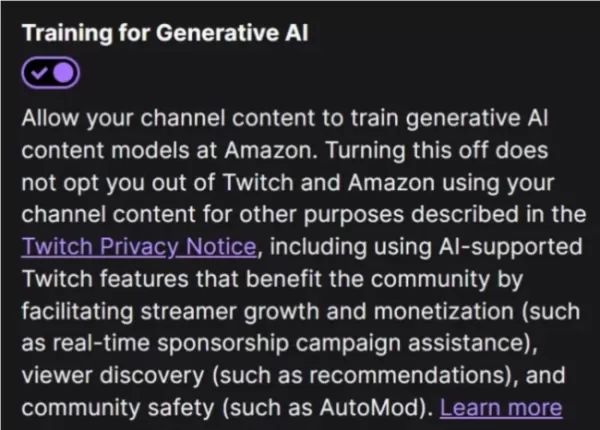
Les dirigeants de Twitch ont reconnu que la plateforme était consciente du scepticisme généralisé entourant l’IA générative, soulignant que la plupart des systèmes d’IA s’entraînent actuellement sur des données Internet accessibles au public sans le consentement explicite des créateurs. Pour atténuer les réactions négatives, Twitch a présenté cette initiative comme une fonctionnalité d’exclusion facultative s’inscrivant dans le cadre plus large des efforts d’entraînement de l’IA menés par Amazon. Cependant, cette approche a laissé de nombreux streamers inquiets et perplexes quant à savoir si leur contenu était déjà collecté à leur insu.
Kish a expliqué que le fait de proposer une option de désinscription s’inscrit dans la ligne de la position ferme de la communauté, qui s’oppose à contribuer à l’entraînement de l’IA. Bien qu’elle offre ce choix, cette décision souligne la tension persistante entre les plateformes technologiques et les créateurs concernant les droits d’auteur et la propriété des données — un conflit que l’on retrouve chez d’autres grandes entreprises technologiques qui utilisent des données publiques pour le développement de l’IA.
Les streamers qui souhaitent exclure leur contenu de l’entraînement de l’IA peuvent actuellement désactiver le paramètre « Entraînement de l’IA générative ». Cette option se trouve sous l’onglet « Sécurité et confidentialité » dans les paramètres de la chaîne, distinct du tableau de bord des créateurs. Les utilisateurs doivent désactiver manuellement cette fonctionnalité pour s’assurer que leur contenu n’est pas utilisé.
Article connexe
 AI JiShu, une start-up spécialisée dans la formation des nouveaux arrivants, lève plusieurs millions et lance une stratégie combinant logiciel et matériel
Alors que l’intelligence artificielle continue de transformer les secteurs d’activité, le secteur de l’éducation connaît une avancée majeure avec l’émergence d’un nouvel acteur prometteur. Le 22 avril
Le laboratoire d'IA de Shanghai dévoile ViraHInter pour stimuler la découverte de médicaments antiviraux
Le Laboratoire d'intelligence artificielle de Shanghai, en partenariat avec l'université de Fudan, l'hôpital Ruijin rattaché à la faculté de médecine de l'université Jiao Tong de S
Pékin représente près de 30 % des demandes d'enregistrement de grands modèles en Chine, dont 225 ont été approuvées par l'Administration du cyberespace, ce qui lui permet de conserver sa position de leader en matière d'innovation dans le domaine de l'IA
Alors que les grands modèles d’IA passent de la phase d’innovation à celle de la conformité réglementaire, Pékin consolide son statut de pôle d’innovation en matière d’IA en Chine. Le Bureau municipal
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Twitch, le leader des services de streaming en direct, a annoncé son intention d’utiliser le contenu diffusé par les créateurs pour entraîner des modèles d’IA générative au profit de sa société mère, Amazon. Cette décision a suscité une vive polémique au sein de la communauté des créateurs, notamment en raison du mécanisme par défaut de « consentement explicite » prévu par cette politique. Dans ce cadre, les streamers doivent expressément refuser que leurs fichiers audio et vidéo soient utilisés pour l’entraînement de l’IA — un processus que beaucoup jugent contre-intuitif et susceptible d’être négligé.
Lors d’une récente session « Ask Me Anything » (AMA) sur la chaîne officielle de Twitch, la responsable de la communauté, Mary Kish, et le directeur des produits, Mike Minton, ont répondu aux questions de près de 3 000 spectateurs. Face aux nombreuses questions demandant pourquoi le paramètre n’était pas « de désengagement par défaut », Minton a déclaré sans détour qu’un tel paramètre entraînerait une participation volontaire négligeable.
Les dirigeants de Twitch ont reconnu que la plateforme était consciente du scepticisme généralisé entourant l’IA générative, soulignant que la plupart des systèmes d’IA s’entraînent actuellement sur des données Internet accessibles au public sans le consentement explicite des créateurs. Pour atténuer les réactions négatives, Twitch a présenté cette initiative comme une fonctionnalité d’exclusion facultative s’inscrivant dans le cadre plus large des efforts d’entraînement de l’IA menés par Amazon. Cependant, cette approche a laissé de nombreux streamers inquiets et perplexes quant à savoir si leur contenu était déjà collecté à leur insu.
Kish a expliqué que le fait de proposer une option de désinscription s’inscrit dans la ligne de la position ferme de la communauté, qui s’oppose à contribuer à l’entraînement de l’IA. Bien qu’elle offre ce choix, cette décision souligne la tension persistante entre les plateformes technologiques et les créateurs concernant les droits d’auteur et la propriété des données — un conflit que l’on retrouve chez d’autres grandes entreprises technologiques qui utilisent des données publiques pour le développement de l’IA.
Les streamers qui souhaitent exclure leur contenu de l’entraînement de l’IA peuvent actuellement désactiver le paramètre « Entraînement de l’IA générative ». Cette option se trouve sous l’onglet « Sécurité et confidentialité » dans les paramètres de la chaîne, distinct du tableau de bord des créateurs. Les utilisateurs doivent désactiver manuellement cette fonctionnalité pour s’assurer que leur contenu n’est pas utilisé.








 AI JiShu, une start-up spécialisée dans la formation des nouveaux arrivants, lève plusieurs millions et lance une stratégie combinant logiciel et matériel
Alors que l’intelligence artificielle continue de transformer les secteurs d’activité, le secteur de l’éducation connaît une avancée majeure avec l’émergence d’un nouvel acteur prometteur. Le 22 avril
 Le laboratoire d'IA de Shanghai dévoile ViraHInter pour stimuler la découverte de médicaments antiviraux
Le Laboratoire d'intelligence artificielle de Shanghai, en partenariat avec l'université de Fudan, l'hôpital Ruijin rattaché à la faculté de médecine de l'université Jiao Tong de S
 Pékin représente près de 30 % des demandes d'enregistrement de grands modèles en Chine, dont 225 ont été approuvées par l'Administration du cyberespace, ce qui lui permet de conserver sa position de leader en matière d'innovation dans le domaine de l'IA
Alors que les grands modèles d’IA passent de la phase d’innovation à celle de la conformité réglementaire, Pékin consolide son statut de pôle d’innovation en matière d’IA en Chine. Le Bureau municipal

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












