


 Дом
Компания Moonshot AI и Университет Цинхуа представили архитектуру PrfaaS, призванную устранить «узкое место» в вычислительной мощности крупных моделей
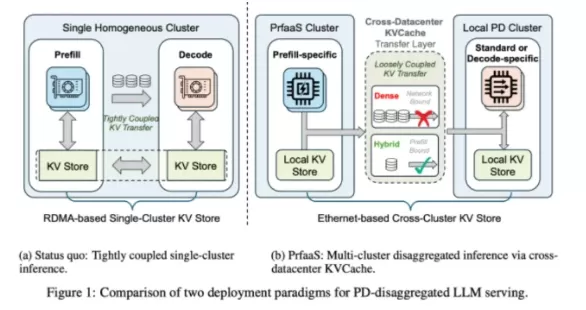
Новые технологии позволяют преодолеть ограничения производительности крупных языковых моделей (LLM). Недавно исследователи из Moonshot AI (Moonshot) и Университета Цинхуа представили новую архитектуру под названием Prefill-as-a-Service (PrfaaS). Это исследование решает проблему аппаратных ограничений при развертывании сервисов на основе крупных моделей в центрах обработки данных за счет оптимизации распределения вычислительных ресурсов, что позволяет значительно повысить эффективность инференса.
Технический прорыв: «хирургическое» разделение этапов предварительного заполнения и декодирования
В настоящее время процесс инференса для больших языковых моделей состоит из двух отдельных фаз:
Фаза предварительного заполнения: эта фаза требует интенсивных вычислений, она обрабатывает входные данные и генерирует кэш «ключ-значение» (KVCache).
Фаза декодирования: эта фаза требует большой пропускной способности памяти и генерирует выходные данные слово за словом.
В традиционных архитектурах обе фазы обычно обрабатываются в одном и том же центре обработки данных или даже на одном и том же сервере. Поскольку они имеют разные потребности в аппаратных ресурсах, такое «принудительное объединение» часто создает дисбаланс в распределении вычислительных ресурсов и пропускной способности, что приводит к перегрузке сервиса.
Основная инновация: эффективное межрегиональное взаимодействие
Основная особенностьPrfaaS — реализация развязанного сервиса. Он переносит вычислительно-емкие задачи предварительного заполнения на специализированные кластеры с высокой вычислительной мощностью. После завершения задачи система использует стандартный Ethernet для удаленной передачи сгенерированного KVCache в локальный кластер декодирования.
Такая конструкция устраняет ограничения физического пространства, позволяя выполнять предварительное заполнение и декодирование одновременно в разных дата-центрах. Для обеспечения эффективной передачи PrfaaS использует механизм планирования с двумя временными масштабами, который гибко распределяет ресурсы с учетом колебаний трафика в реальном времени, в сочетании с точной маршрутизацией, чтобы предотвратить задержки запросов с длинным текстом из-за неравномерного распределения ресурсов.
Результаты тестирования: оптимизация пропускной способности и задержки
Данные исследований показывают, что архитектура PrfaaS демонстрирует замечательную производительность в реальных приложениях:
Пропускная способность сервиса увеличилась на 54%, что значительно повысило количество запросов, обрабатываемых за единицу времени.
Задержка ответа значительно уменьшилась, что ускорило генерацию первого токена с точки зрения пользователя.
Максимальное использование ресурсов за счет разделения вычислительных, сетевых и хранилищных подсистем, что позволяет избежать проблем с перегрузкой, характерных для традиционных архитектур.
Сотрудничество между Moonshot AI и Университетом Цинхуа не только предлагает новые инженерные подходы к крупномасштабному вычислению ИИ, но и закладывает основу для будущих межрегиональных вычислительных сетей. Эта модель Prefill-as-a-Service может стать ключевой вехой на пути к промышленному внедрению крупных моделей.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Создание видео
 Генераторы привлекательных заглавий для коротких видеороликов с использованием ИИ: для Reels, Shorts и кампаний по запуску продуктов
2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
 11 инструментов
 xix.ai
письмо
Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

 Комментарии (1)
![HarryRoberts]()
Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔
Новые технологии позволяют преодолеть ограничения производительности крупных языковых моделей (LLM). Недавно исследователи из Moonshot AI (Moonshot) и Университета Цинхуа представили новую архитектуру под названием Prefill-as-a-Service (PrfaaS). Это исследование решает проблему аппаратных ограничений при развертывании сервисов на основе крупных моделей в центрах обработки данных за счет оптимизации распределения вычислительных ресурсов, что позволяет значительно повысить эффективность инференса.
Технический прорыв: «хирургическое» разделение этапов предварительного заполнения и декодирования
В настоящее время процесс инференса для больших языковых моделей состоит из двух отдельных фаз:
Фаза предварительного заполнения: эта фаза требует интенсивных вычислений, она обрабатывает входные данные и генерирует кэш «ключ-значение» (KVCache).
Фаза декодирования: эта фаза требует большой пропускной способности памяти и генерирует выходные данные слово за словом.
В традиционных архитектурах обе фазы обычно обрабатываются в одном и том же центре обработки данных или даже на одном и том же сервере. Поскольку они имеют разные потребности в аппаратных ресурсах, такое «принудительное объединение» часто создает дисбаланс в распределении вычислительных ресурсов и пропускной способности, что приводит к перегрузке сервиса.
Основная инновация: эффективное межрегиональное взаимодействие
Основная особенность
Такая конструкция устраняет ограничения физического пространства, позволяя выполнять предварительное заполнение и декодирование одновременно в разных дата-центрах. Для обеспечения эффективной передачи PrfaaS использует механизм планирования с двумя временными масштабами, который гибко распределяет ресурсы с учетом колебаний трафика в реальном времени, в сочетании с точной маршрутизацией, чтобы предотвратить задержки запросов с длинным текстом из-за неравномерного распределения ресурсов.
Результаты тестирования: оптимизация пропускной способности и задержки
Данные исследований показывают, что архитектура PrfaaS демонстрирует замечательную производительность в реальных приложениях:
Пропускная способность сервиса увеличилась на 54%, что значительно повысило количество запросов, обрабатываемых за единицу времени.
Задержка ответа значительно уменьшилась, что ускорило генерацию первого токена с точки зрения пользователя.
Максимальное использование ресурсов за счет разделения вычислительных, сетевых и хранилищных подсистем, что позволяет избежать проблем с перегрузкой, характерных для традиционных архитектур.
Сотрудничество между Moonshot AI и Университетом Цинхуа не только предлагает новые инженерные подходы к крупномасштабному вычислению ИИ, но и закладывает основу для будущих межрегиональных вычислительных сетей. Эта модель Prefill-as-a-Service может стать ключевой вехой на пути к промышленному внедрению крупных моделей.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026: лучшие современные генераторы захватывающих заставок для короткометражных видео на базе ИИ для Reels, Shorts и кампаний по запуску продуктов! XIX.AI подбирает самые высокооцененные и мощные инструменты, способные кардинально изменить ситуацию, которые в ходе реальных тестов демонстрируют результаты, которые обязательно стоит попробовать. Эта страница, обновляемая еженедельно, предлагает сравнительные рейтинги бесплатных и платных инструментов, чтобы помочь вам найти идеальное решение для повышения креативности и продуктивности при создании контента. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть свой потенциал с помощью ИИ!
11 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔












