


 Lar
A Moonshot AI e a Universidade de Tsinghua apresentam a arquitetura PrfaaS para superar o gargalo de poder de computação dos modelos de grande porte
Novas tecnologias estão superando o gargalo de desempenho dos grandes modelos de linguagem (LLMs). Recentemente, pesquisadores da Moonshot AI (Moonshot) e da Universidade de Tsinghua apresentaram uma nova arquitetura chamada Prefill-as-a-Service (PrfaaS). Este estudo aborda as restrições de hardware nas implantações de serviços de modelos de grande porte em data centers, otimizando a alocação de recursos computacionais e, assim, aumentando significativamente a eficiência da inferência.
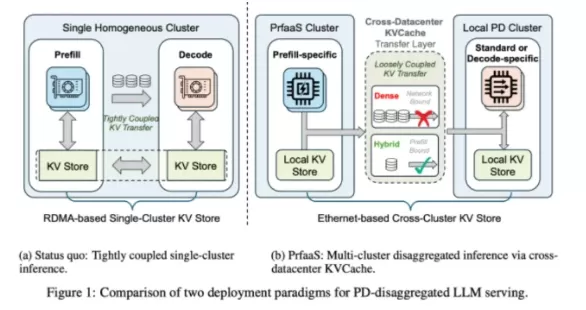
Avanço técnico: uma separação “cirúrgica” entre pré-preenchimento e decodificação
Atualmente, o processo de inferência para grandes modelos de linguagem compreende duas fases distintas:
Fase de pré-preenchimento: essa fase é intensiva em computação, lidando com o processamento de entrada e gerando cache de chave-valor (KVCache).
Fase de decodificação: essa fase consome muita largura de banda de memória, gerando a saída palavra por palavra.
Em arquiteturas tradicionais, ambas as fases são normalmente tratadas dentro do mesmo data center ou até mesmo do mesmo servidor. Como elas têm necessidades diferentes de recursos de hardware, esse “agrupamento forçado” frequentemente cria um desequilíbrio na alocação de computação e largura de banda, levando ao congestionamento do serviço.
Inovação central: colaboração eficiente entre regiões
O principal destaquedo PrfaaS é a obtenção de um serviço desacoplado. Ele transfere as tarefas de pré-preenchimento, que exigem grande capacidade de computação, para clusters especializados de alta computação. Após a conclusão da tarefa, o sistema usa Ethernet padrão para transferir o KVCache gerado remotamente para um cluster de decodificação local.
Esse design elimina as restrições de espaço físico, permitindo que o pré-preenchimento e a decodificação sejam executados simultaneamente em diferentes data centers. Para garantir uma transferência eficiente, o PrfaaS incorpora um mecanismo de agendamento em duas escalas de tempo que aloca recursos de forma flexível com base nas flutuações de tráfego em tempo real, combinado com um roteamento preciso para evitar que solicitações de texto longo sejam atrasadas por uma distribuição desigual de recursos.
Resultados dos testes: otimização de throughput e latência
Dados de pesquisa demonstram que a arquitetura do PrfaaS oferece desempenho notável em aplicações do mundo real:
A taxa de transferência do serviço aumentou em 54%, melhorando significativamente o número de solicitações processadas por unidade de tempo.
A latência de resposta diminuiu significativamente, tornando a geração do primeiro token mais rápida do ponto de vista do usuário.
A utilização de recursos foi maximizada pela separação dos subsistemas de computação, rede e armazenamento, evitando problemas de congestionamento observados em arquiteturas tradicionais.
A colaboração entre a Moonshot AI e a Universidade de Tsinghua não apenas oferece novas abordagens de engenharia para inferência de IA em grande escala, mas também estabelece as bases para futuras redes de computação inter-regionais. Esse modelo de Prefill-as-a-Service pode se tornar um marco importante na transição de grandes modelos para a implantação industrial.
Artigo relacionado
 Stripe vai adquirir a OpenRouter à medida que o roteamento baseado em modelos de IA ganha força
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que oferece aos desenvolvedores acesso a centenas de modelos por meio de uma única interface. O acordo amplia
O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (1)
![HarryRoberts]()
Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔
Novas tecnologias estão superando o gargalo de desempenho dos grandes modelos de linguagem (LLMs). Recentemente, pesquisadores da Moonshot AI (Moonshot) e da Universidade de Tsinghua apresentaram uma nova arquitetura chamada Prefill-as-a-Service (PrfaaS). Este estudo aborda as restrições de hardware nas implantações de serviços de modelos de grande porte em data centers, otimizando a alocação de recursos computacionais e, assim, aumentando significativamente a eficiência da inferência.
Avanço técnico: uma separação “cirúrgica” entre pré-preenchimento e decodificação
Atualmente, o processo de inferência para grandes modelos de linguagem compreende duas fases distintas:
Fase de pré-preenchimento: essa fase é intensiva em computação, lidando com o processamento de entrada e gerando cache de chave-valor (KVCache).
Fase de decodificação: essa fase consome muita largura de banda de memória, gerando a saída palavra por palavra.
Em arquiteturas tradicionais, ambas as fases são normalmente tratadas dentro do mesmo data center ou até mesmo do mesmo servidor. Como elas têm necessidades diferentes de recursos de hardware, esse “agrupamento forçado” frequentemente cria um desequilíbrio na alocação de computação e largura de banda, levando ao congestionamento do serviço.
Inovação central: colaboração eficiente entre regiões
O principal destaque
Esse design elimina as restrições de espaço físico, permitindo que o pré-preenchimento e a decodificação sejam executados simultaneamente em diferentes data centers. Para garantir uma transferência eficiente, o PrfaaS incorpora um mecanismo de agendamento em duas escalas de tempo que aloca recursos de forma flexível com base nas flutuações de tráfego em tempo real, combinado com um roteamento preciso para evitar que solicitações de texto longo sejam atrasadas por uma distribuição desigual de recursos.
Resultados dos testes: otimização de throughput e latência
Dados de pesquisa demonstram que a arquitetura do PrfaaS oferece desempenho notável em aplicações do mundo real:
A taxa de transferência do serviço aumentou em 54%, melhorando significativamente o número de solicitações processadas por unidade de tempo.
A latência de resposta diminuiu significativamente, tornando a geração do primeiro token mais rápida do ponto de vista do usuário.
A utilização de recursos foi maximizada pela separação dos subsistemas de computação, rede e armazenamento, evitando problemas de congestionamento observados em arquiteturas tradicionais.
A colaboração entre a Moonshot AI e a Universidade de Tsinghua não apenas oferece novas abordagens de engenharia para inferência de IA em grande escala, mas também estabelece as bases para futuras redes de computação inter-regionais. Esse modelo de Prefill-as-a-Service pode se tornar um marco importante na transição de grandes modelos para a implantação industrial.








 Stripe vai adquirir a OpenRouter à medida que o roteamento baseado em modelos de IA ganha força
A Stripe concordou em adquirir a OpenRouter, uma plataforma de roteamento de modelos de IA que oferece aos desenvolvedores acesso a centenas de modelos por meio de uma única interface. O acordo amplia
 O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
 Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

Wait, so PrfaaS separates prefill from decode? That sounds like a smart way to reduce latency, but how does it handle memory overhead? 🤔












