


 Дом
В Microsoft назвали сбор данных для ИИ «крупнейшим воровством труда в истории», показывают неотредактированные документы
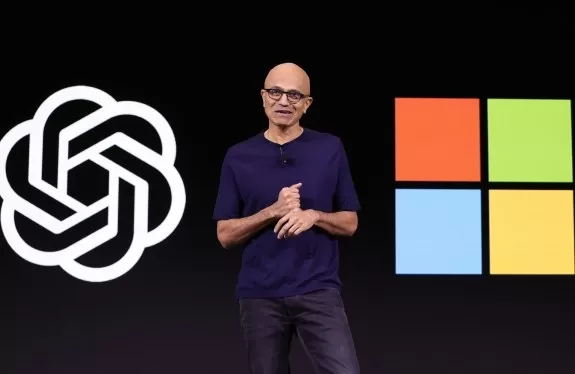
Разблокированные документы по трёхлетнему иску о нарушении авторских прав, поданному газетой The New York Times против компаний OpenAI и Microsoft, содержат признание в том, что скрейпинг данных для обучения искусственного интеллекта является кражей и создаёт серьёзную угрозу для средств массовой информации.
Согласно материалам иска, высокопоставленный исполнительный директор Microsoft в частном порядке назвал методы обучения ИИ этих компаний «кражей», в то время как руководство OpenAI признало, что его модели создают «экзистенциальную угрозу» для издателей и журналистов, чей контент использовался для их обучения.
Новые разблокированные записи также подробно описывают то, как компании, по утверждению истцов, получали доступ к этому контенту и использовали его, обходя платные стены без обнаружения, формируя обучающие наборы данных посредством массового скрейпинга и намеренно удаляя уведомления об авторских правах из данных.
Важно отметить, что большая часть этой новой информации происходит из собственных юридических меморандумов газеты The Times, а не из основных доказательств, которые остаются засекреченными. Приведённые ниже цитаты представлены без их исходного контекста.
Этот необфусцированный документ знаменует собой новое обострение трёхлетнего судебного разбирательства, в котором The New York Times изначально утверждала, что компании нарушили закон об авторском праве, обучая модели генеративного искусственного интеллекта на основе своего контента.
Не существует чёткого юридического ответа на вопрос о том, могут ли компании, занимающиеся искусственным интеллектом, законно использовать материалы, защищённые авторским правом, для обучения, хотя судьи в целом поддерживали аргумент компаний об ИИ о том, что такое обучение подпадает под понятие «добросовестного использования». Эта правовая доктрина разрешает использование материалов, защищённых авторским правом, без разрешения в определённых случаях, таких как пародия, новостная отчётность или критика. Ранее в этом месяце администрация Трампа подала меморандум, поддерживающий нелицензированное использование OpenAI материалов, защищённых авторским правом, для обучения своих больших языковых моделей.
Однако несколько из этих новых признаний противоречат защите OpenAI, основанной на доктрине добросовестного использования, в частности требованию о том, что такое использование не заменяет оригинальное произведение и не вредит рынку оригинального произведения.
Например, собственные данные Microsoft показывают, что её «поисковая система ответов» Copilot привела к падению показателей кликабельности для домена The New York Times на величину до 93% по сравнению с традиционными поисковыми запросами в Bing. Внутренняя презентация Microsoft, подготовленная Брентом Хектом, директором прикладных наук Microsoft, в январе 2024 года, описывает это падение как «петлю гибели», которая одновременно «навредит производительности наших моделей и всему веб-пространству».
«Высоковероятно, что конечный продукт угрожает экономическим основам своих ключевых поставщиков, но именно ту ситуацию мы создали для нашего бизнеса по созданию больших языковых моделей в отношении их «цепочки поставок контента»», — говорится в документе Microsoft, как цитируется в иске.
Генеральный директор Microsoft Сатья Наделла также показал показания под присягой в рамках допроса в начале этого года, заявив, что «любой контент, закрытый платной стеной, должен лицензироваться любым, кто хочет его использовать… для обоснования или обучения», и уточнил, что если бы он «был уведомлён о том, что OpenAI скрейпил и обучался на информации, находящейся за платной стеной», он бы «воспользовался [правом Microsoft] потребовать от OpenAI переобучить свои модели».
Другие признания подрывают различные аспекты теста на добросовестное использование: глава ChatGPT в OpenAI Ник Турли написал во внутренних коммуникациях, что издатели сталкиваются с «экзистенциальной угрозой» от таких продуктов, как чат-бот, которые являются «в значительной степени заменяемыми» и «станут ещё более заменяемыми по мере их улучшения».
Президент OpenAI Грег Брокман описал модели как «отлично справляющиеся с новостями». Наделла подтвердил под присягой в начале этого года, что взаимодействие с чат-ботами «заменило … предоставление вам информации прямо на веб-сайте на платформе ИИ вместо необходимости обращаться к первоисточнику».
Подобная терминология подчёркивает, что технология может напрямую конкурировать с оригинальным произведением, а не трансформировать его.
В документе Microsoft говорится о «реальном риске» того, что генеративный ИИ может «существенно нарушить занятость тех самых людей, которые создали данные, на которых была обучена базовая модель».
Масштаб копирования поражает. Документы впервые показывают, что только обучающие наборы данных OpenAI на среднем этапе обучения содержат более 91 692 копий произведений, опубликованных NYT, Daily News и Центром расследовательской журналистики. Набор данных, полученный из Common Crawl, включал более 2 миллионов документов только с nytimes.com.
Во внутреннем меморандуме от января 2023 года Хект назвал это «поразительной кражей беспрецедентных масштабов» и «крупнейшей кражей труда в истории человечества».
В иске приводятся новые подробности о том, как OpenAI и Microsoft получили контент истцов, включая скрейпинг его из индекса Bing.
«OpenAI передала Microsoft весь обучающий набор данных GPT-3, который Microsoft использовала для оценки того, как внедрить модели OpenAI в свои коммерческие продукты», — говорится в иске. «Microsoft аналогичным образом предоставила обучающие данные OpenAI через инициативы под названиями Project Taxi и Project Mango».
По утверждению истцов, компании собрали данные Project Mango в обучающий набор данных, содержащий копии как минимум 160 903 уникальных произведений от новостных издателей.
Чтобы максимизировать эффективность своего скрейпинга, сотрудники OpenAI, по утверждению истцов, разработали план обхода платных стен без обнаружения. Документы показывают, что когда исследователь OpenAI Ник Райдер сообщил Брокману о «взломе для обхода платной стены nytimes», Брокман ответил: «ах, здорово».
Сотрудники OpenAI, по утверждению истцов, также создали обучающие наборы данных, такие как WebText и WebText2, которые непропорционально сильно полагались на скрейпленный новостной контент. Они также, по утверждению истцов, извлекли миллионы статей из Common Crawl, бесплатного открытого репозитория данных веб-краулинга. Результаты также описывают преднамеренные усилия по удалению уведомлений об авторских правах из обучающих данных до того, как они достигли модели, поскольку исследователи «не хотели бы, чтобы модель выводила» «уведомления об авторских правах» пользователям.
OpenAI и Microsoft не ответили на запросы о комментарии.
Связанная статья
 OpenAI GPT-6 вдвое снижает стоимость токенов по всем тестам, а Sol и Luna присоединяются к проекту
По данным Artificial Analysis, модель GPT-6 Sol (max) занимает первое место по уровню интеллекта, а её стоимость составляет 48 долларов. Источник изображения: Getty ImagesПосле того как OpenAI выпусти
«Кладбище ИИ»: постоянно пополняемый список проектов и стартапов, которые не выжили
Relay — платформа для автоматизации рабочих процессов на базе искусственного интеллекта, позиционировавшаяся как альтернатива Zapier, — прекратила свою деятельность в понедельник. Сервис позволял поль
OpenAI делает ставку на семьи, поскольку ChatGPT всё глубже проникает в домашние хозяйства
Прошло более трех лет с тех пор, как ChatGPT вывел генеративный искусственный интеллект в центр внимания, а компания OpenAI расширяет свой охват от отдельных пользователей до целых домохозяйств.OpenAI ищет менеджера по продукту в Сан-Франциско для ра
Рекомендации по связанным специальным темам
Быстрый
 Инструменты управления промптами для команд
В 2026 году лучшие, самые популярные инструменты управления AI-промптами для команд, отобранные XIX.AI, представлены здесь. Этот еженедельно обновляемый гайд включает мощные решения, меняющие правила игры, которые значительно повышают продуктивность команд благодаря реальным тестам и подробным рейтингам. Получите бесплатное сравнение платных и бесплатных вариантов, чтобы выбрать идеальный инструмент. Исследуйте сейчас, чтобы раскрыть ваше преимущество в AI.
 9 инструментов
 xix.ai
Музыкальная композиция
Инструменты на базе ИИ для генерации текстов песен при сочинении музыки
2026 лучших и самых популярных инструментов на базе ИИ для создания текстов песен в 2026 году — уже здесь, на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные решения, прошедшие реальные испытания и позволяющие быстро генерировать высококачественные концепции текстов, что помогает пользователям раскрыть свой творческий потенциал и оптимизировать процесс создания музыки. Также ознакомьтесь с обзором, сравнивающим бесплатные и платные версии. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
16 инструментов
xix.ai
Создание комиксов
Инструменты для создания листов персонажей ИИ для построения мира комиксов
2026 г. Лучшие новейшие высокооцененные инструменты для создания листов персонажей на основе ИИ для комиксов и построения мира доступны на XIX.AI! Этот тщательно подобранный список включает мощные, революционные решения, прошедшие строгие реальные испытания. Вы найдёте сравнение бесплатных и платных вариантов, а также еженедельно обновляемые рейтинги, которые помогут вам обнаружить инструменты, которые обязательно стоит попробовать, чтобы повысить креативность и оптимизировать задачи по построению мира. Исследуйте сейчас, чтобы раскрыть своё преимущество с ИИ!
13 инструментов
xix.ai
автоматизация
Инструменты n8n для автоматизации на базе ИИ: управление внутренними операциями, синхронизация данных и многоэтапные рабочие процессы агентов
2026 год: представлены новейшие и лучшие инструменты n8n для автоматизации с помощью ИИ, предназначенные для внутренних операций, синхронизации данных и многоэтапных рабочих процессов агентов! XIX.AI составила рейтинг самых популярных и мощных инструментов, способных кардинально изменить подход к работе и повысить продуктивность при выполнении любых рабочих задач. Каждая позиция в списке проходит тщательные тесты в реальных условиях для обеспечения надёжности, сопровождается подробным сравнением бесплатных и платных версий, а также еженедельно обновляемым рейтингом. Варианты, которые обязательно стоит попробовать, помогут вам раскрыть потенциал ИИ и без лишних усилий оптимизировать рабочие процессы. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
11 инструментов
xix.ai
Быстрый
Лучшие инструменты для управления промтами в командах, работающих с несколькими моделями
2026: новейшие и лучшие инструменты для управления промптами, получившие высокие оценки, для команд, работающих с несколькими моделями! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать. В ней представлено сравнение бесплатных и платных версий, результаты реальных тестов и подробные рейтинги. Эти лучшие решения помогают значительно повысить продуктивность за счет оптимизации рабочих процессов, устранения повторяющихся действий и раскрытия творческого потенциала во всех проектах команды. Ознакомьтесь с подборкой прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Помощник по встречам
Инструменты для составления отчетов о совещаниях с использованием ИИ для удаленных команд
2026: лучшие и самые популярные инструменты для составления отчетов о встречах с помощью ИИ для удаленных команд! XIX.AI подготовила подборку мощных и революционных инструментов, которые обязательно стоит попробовать. Все они прошли реальные испытания и обеспечивают точные стенограммы и полезные аналитические выводы. Здесь вы найдете сравнительные данные по бесплатным и платным версиям, а также подробные рейтинги, которые помогут вам выбрать идеальный вариант для повышения продуктивности и оптимизации коммуникации в команде. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
13 инструментов
xix.ai

 Комментарии (0)
Разблокированные документы по трёхлетнему иску о нарушении авторских прав, поданному газетой The New York Times против компаний OpenAI и Microsoft, содержат признание в том, что скрейпинг данных для обучения искусственного интеллекта является кражей и создаёт серьёзную угрозу для средств массовой информации.
Согласно материалам иска, высокопоставленный исполнительный директор Microsoft в частном порядке назвал методы обучения ИИ этих компаний «кражей», в то время как руководство OpenAI признало, что его модели создают «экзистенциальную угрозу» для издателей и журналистов, чей контент использовался для их обучения.
Новые разблокированные записи также подробно описывают то, как компании, по утверждению истцов, получали доступ к этому контенту и использовали его, обходя платные стены без обнаружения, формируя обучающие наборы данных посредством массового скрейпинга и намеренно удаляя уведомления об авторских правах из данных.
Важно отметить, что большая часть этой новой информации происходит из собственных юридических меморандумов газеты The Times, а не из основных доказательств, которые остаются засекреченными. Приведённые ниже цитаты представлены без их исходного контекста.
Этот необфусцированный документ знаменует собой новое обострение трёхлетнего судебного разбирательства, в котором The New York Times изначально утверждала, что компании нарушили закон об авторском праве, обучая модели генеративного искусственного интеллекта на основе своего контента.
Не существует чёткого юридического ответа на вопрос о том, могут ли компании, занимающиеся искусственным интеллектом, законно использовать материалы, защищённые авторским правом, для обучения, хотя судьи в целом поддерживали аргумент компаний об ИИ о том, что такое обучение подпадает под понятие «добросовестного использования». Эта правовая доктрина разрешает использование материалов, защищённых авторским правом, без разрешения в определённых случаях, таких как пародия, новостная отчётность или критика. Ранее в этом месяце администрация Трампа подала меморандум, поддерживающий нелицензированное использование OpenAI материалов, защищённых авторским правом, для обучения своих больших языковых моделей.
Однако несколько из этих новых признаний противоречат защите OpenAI, основанной на доктрине добросовестного использования, в частности требованию о том, что такое использование не заменяет оригинальное произведение и не вредит рынку оригинального произведения.
Например, собственные данные Microsoft показывают, что её «поисковая система ответов» Copilot привела к падению показателей кликабельности для домена The New York Times на величину до 93% по сравнению с традиционными поисковыми запросами в Bing. Внутренняя презентация Microsoft, подготовленная Брентом Хектом, директором прикладных наук Microsoft, в январе 2024 года, описывает это падение как «петлю гибели», которая одновременно «навредит производительности наших моделей и всему веб-пространству».
«Высоковероятно, что конечный продукт угрожает экономическим основам своих ключевых поставщиков, но именно ту ситуацию мы создали для нашего бизнеса по созданию больших языковых моделей в отношении их «цепочки поставок контента»», — говорится в документе Microsoft, как цитируется в иске.
Генеральный директор Microsoft Сатья Наделла также показал показания под присягой в рамках допроса в начале этого года, заявив, что «любой контент, закрытый платной стеной, должен лицензироваться любым, кто хочет его использовать… для обоснования или обучения», и уточнил, что если бы он «был уведомлён о том, что OpenAI скрейпил и обучался на информации, находящейся за платной стеной», он бы «воспользовался [правом Microsoft] потребовать от OpenAI переобучить свои модели».
Другие признания подрывают различные аспекты теста на добросовестное использование: глава ChatGPT в OpenAI Ник Турли написал во внутренних коммуникациях, что издатели сталкиваются с «экзистенциальной угрозой» от таких продуктов, как чат-бот, которые являются «в значительной степени заменяемыми» и «станут ещё более заменяемыми по мере их улучшения».
Президент OpenAI Грег Брокман описал модели как «отлично справляющиеся с новостями». Наделла подтвердил под присягой в начале этого года, что взаимодействие с чат-ботами «заменило … предоставление вам информации прямо на веб-сайте на платформе ИИ вместо необходимости обращаться к первоисточнику».
Подобная терминология подчёркивает, что технология может напрямую конкурировать с оригинальным произведением, а не трансформировать его.
В документе Microsoft говорится о «реальном риске» того, что генеративный ИИ может «существенно нарушить занятость тех самых людей, которые создали данные, на которых была обучена базовая модель».
Масштаб копирования поражает. Документы впервые показывают, что только обучающие наборы данных OpenAI на среднем этапе обучения содержат более 91 692 копий произведений, опубликованных NYT, Daily News и Центром расследовательской журналистики. Набор данных, полученный из Common Crawl, включал более 2 миллионов документов только с nytimes.com.
Во внутреннем меморандуме от января 2023 года Хект назвал это «поразительной кражей беспрецедентных масштабов» и «крупнейшей кражей труда в истории человечества».
В иске приводятся новые подробности о том, как OpenAI и Microsoft получили контент истцов, включая скрейпинг его из индекса Bing.
«OpenAI передала Microsoft весь обучающий набор данных GPT-3, который Microsoft использовала для оценки того, как внедрить модели OpenAI в свои коммерческие продукты», — говорится в иске. «Microsoft аналогичным образом предоставила обучающие данные OpenAI через инициативы под названиями Project Taxi и Project Mango».
По утверждению истцов, компании собрали данные Project Mango в обучающий набор данных, содержащий копии как минимум 160 903 уникальных произведений от новостных издателей.
Чтобы максимизировать эффективность своего скрейпинга, сотрудники OpenAI, по утверждению истцов, разработали план обхода платных стен без обнаружения. Документы показывают, что когда исследователь OpenAI Ник Райдер сообщил Брокману о «взломе для обхода платной стены nytimes», Брокман ответил: «ах, здорово».
Сотрудники OpenAI, по утверждению истцов, также создали обучающие наборы данных, такие как WebText и WebText2, которые непропорционально сильно полагались на скрейпленный новостной контент. Они также, по утверждению истцов, извлекли миллионы статей из Common Crawl, бесплатного открытого репозитория данных веб-краулинга. Результаты также описывают преднамеренные усилия по удалению уведомлений об авторских правах из обучающих данных до того, как они достигли модели, поскольку исследователи «не хотели бы, чтобы модель выводила» «уведомления об авторских правах» пользователям.
OpenAI и Microsoft не ответили на запросы о комментарии.








 OpenAI GPT-6 вдвое снижает стоимость токенов по всем тестам, а Sol и Luna присоединяются к проекту
По данным Artificial Analysis, модель GPT-6 Sol (max) занимает первое место по уровню интеллекта, а её стоимость составляет 48 долларов. Источник изображения: Getty ImagesПосле того как OpenAI выпусти
 «Кладбище ИИ»: постоянно пополняемый список проектов и стартапов, которые не выжили
Relay — платформа для автоматизации рабочих процессов на базе искусственного интеллекта, позиционировавшаяся как альтернатива Zapier, — прекратила свою деятельность в понедельник. Сервис позволял поль
 OpenAI делает ставку на семьи, поскольку ChatGPT всё глубже проникает в домашние хозяйства
Прошло более трех лет с тех пор, как ChatGPT вывел генеративный искусственный интеллект в центр внимания, а компания OpenAI расширяет свой охват от отдельных пользователей до целых домохозяйств.OpenAI ищет менеджера по продукту в Сан-Франциско для ра

В 2026 году лучшие, самые популярные инструменты управления AI-промптами для команд, отобранные XIX.AI, представлены здесь. Этот еженедельно обновляемый гайд включает мощные решения, меняющие правила игры, которые значительно повышают продуктивность команд благодаря реальным тестам и подробным рейтингам. Получите бесплатное сравнение платных и бесплатных вариантов, чтобы выбрать идеальный инструмент. Исследуйте сейчас, чтобы раскрыть ваше преимущество в AI.
9 инструментов
xix.ai

2026 лучших и самых популярных инструментов на базе ИИ для создания текстов песен в 2026 году — уже здесь, на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные решения, прошедшие реальные испытания и позволяющие быстро генерировать высококачественные концепции текстов, что помогает пользователям раскрыть свой творческий потенциал и оптимизировать процесс создания музыки. Также ознакомьтесь с обзором, сравнивающим бесплатные и платные версии. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
16 инструментов
xix.ai
2026 г. Лучшие новейшие высокооцененные инструменты для создания листов персонажей на основе ИИ для комиксов и построения мира доступны на XIX.AI! Этот тщательно подобранный список включает мощные, революционные решения, прошедшие строгие реальные испытания. Вы найдёте сравнение бесплатных и платных вариантов, а также еженедельно обновляемые рейтинги, которые помогут вам обнаружить инструменты, которые обязательно стоит попробовать, чтобы повысить креативность и оптимизировать задачи по построению мира. Исследуйте сейчас, чтобы раскрыть своё преимущество с ИИ!
13 инструментов
xix.ai
2026 год: представлены новейшие и лучшие инструменты n8n для автоматизации с помощью ИИ, предназначенные для внутренних операций, синхронизации данных и многоэтапных рабочих процессов агентов! XIX.AI составила рейтинг самых популярных и мощных инструментов, способных кардинально изменить подход к работе и повысить продуктивность при выполнении любых рабочих задач. Каждая позиция в списке проходит тщательные тесты в реальных условиях для обеспечения надёжности, сопровождается подробным сравнением бесплатных и платных версий, а также еженедельно обновляемым рейтингом. Варианты, которые обязательно стоит попробовать, помогут вам раскрыть потенциал ИИ и без лишних усилий оптимизировать рабочие процессы. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для себя!
11 инструментов
xix.ai
2026: новейшие и лучшие инструменты для управления промптами, получившие высокие оценки, для команд, работающих с несколькими моделями! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать. В ней представлено сравнение бесплатных и платных версий, результаты реальных тестов и подробные рейтинги. Эти лучшие решения помогают значительно повысить продуктивность за счет оптимизации рабочих процессов, устранения повторяющихся действий и раскрытия творческого потенциала во всех проектах команды. Ознакомьтесь с подборкой прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
2026: лучшие и самые популярные инструменты для составления отчетов о встречах с помощью ИИ для удаленных команд! XIX.AI подготовила подборку мощных и революционных инструментов, которые обязательно стоит попробовать. Все они прошли реальные испытания и обеспечивают точные стенограммы и полезные аналитические выводы. Здесь вы найдете сравнительные данные по бесплатным и платным версиям, а также подробные рейтинги, которые помогут вам выбрать идеальный вариант для повышения продуктивности и оптимизации коммуникации в команде. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть весь потенциал искусственного интеллекта!
13 инструментов
xix.ai












