


 Maison
Les documents Microsoft, non censurés, révèlent que les dirigeants de l’entreprise qualifient l’extraction des données par l’IA de « plus grand vol de travail de l’histoire »
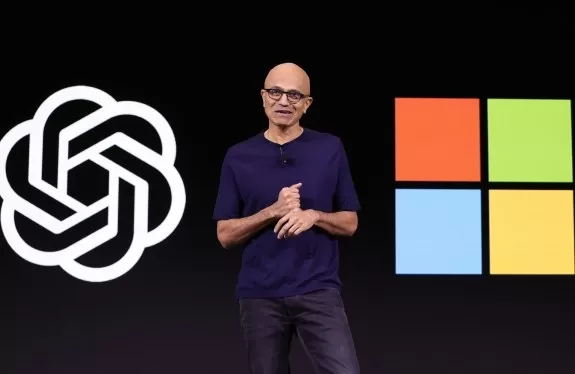
Les documents déclassifiés du procès en contrefaçon de trois ans intenté par The New York Times contre OpenAI et Microsoft révèlent une admission selon laquelle le grattage d’informations par l’intelligence artificielle constitue un vol et pose une menace grave pour les médias.
Selon le procès, un dirigeant de haut niveau de Microsoft a qualifié en privé les méthodes d’entraînement des entreprises d’« vol », tandis que la direction d’OpenAI a reconnu que ses modèles créaient une « menace existentielle » pour les éditeurs et journalistes dont le contenu les avait entraînés.
Les nouveaux documents déclassifiés détaillent également comment les entreprises auraient accès et utilisé ce contenu en contournant les paywalls sans être détectées, en construisant des ensembles de données d’entraînement par un grattage massif et en retirant intentionnellement les mentions de droits d’auteur des données.
Il est important de noter que la plupart de ces nouvelles informations proviennent des propres conclusions juridiques du Times plutôt que des pièces sous scellé, qui restent confidentielles. Les citations ci-dessous sont présentées sans leur contexte original.
Ce dépôt non censuré marque la dernière escalade dans le procès de trois ans, où The New York Times a initialement affirmé que les entreprises avaient violé la loi sur le droit d’auteur en entraînant des modèles d’IA générative sur son contenu.
Il n’existe pas de réponse juridique claire quant à la légalité pour les entreprises d’IA d’utiliser du matériel protégé par le droit d’auteur à des fins d’entraînement, bien que les juges aient généralement favorisé l’argument des entreprises d’IA selon lequel un tel entraînement relève de l’« usage loyal ». Cette doctrine juridique permet l’utilisation d’œuvres protégées sans autorisation dans des cas spécifiques, tels que la parodie, le reportage d’actualités ou la critique. Plus tôt ce mois-ci, l’administration Trump a déposé des conclusions soutenant l’utilisation non licenciée par OpenAI de matériel protégé par le droit d’auteur pour entraîner ses grands modèles de langage.
Cependant, plusieurs de ces nouvelles admissions contredisent la défense de l’usage loyal d’OpenAI, en particulier l’exigence selon laquelle une telle utilisation ne se substitue pas à l’œuvre originale et ne nuit pas à son marché.
Par exemple, les propres données de Microsoft indiquent que son « moteur de réponses » Copilot a fait chuter les taux de clic vers le domaine du New York Times jusqu’à 93 % par rapport aux recherches traditionnelles sur Bing. Une présentation interne de Microsoft rédigée par Brent Hecht, directeur de la science appliquée de Microsoft, en janvier 2024, décrit cette baisse comme une « boucle infernale » qui nuirait simultanément « aux performances de nos modèles et à l’ensemble du web ».
« Il est très inhabituel qu’un produit final menace les fondements économiques de ses fournisseurs essentiels, mais c’est la situation que nous avons créée pour notre entreprise de grands modèles de langage par rapport à sa « chaîne d’approvisionnement en contenu », déclare le document Microsoft, tel que cité dans le dépôt.
Le PDG de Microsoft, Satya Nadella, a également témoigné lors d’une déposition plus tôt cette année que « tout ce qui est soumis à un paywall devrait être licencié par quiconque souhaite l’utiliser… pour l’ancrage ou l’entraînement », et a précisé qu’il aurait « invoqué [le droit de Microsoft d’exiger] qu’OpenAI réentraîne ses modèles » s’il avait « été informé qu’OpenAI avait gratté et entraîné des informations derrière un paywall ».
D’autres admissions sapent différents aspects du test de l’usage loyal : le responsable de ChatGPT d’OpenAI, Nick Turley, a écrit dans des communications internes que les éditeurs font face à une « menace existentielle » de la part de produits comme le chatbot, qui sont « largement substituables » et « deviendront de plus en plus substituables à mesure qu’ils s’amélioreront ».
Le président d’OpenAI, Greg Brockman, a décrit les modèles comme « excellents pour les actualités ». Nadella a convenu sous serment plus tôt cette année que l’interaction avec les chatbots « a substitué … vous donnant l’information directement sur le site web de la plateforme d’IA plutôt que d’avoir à aller à la source sous-jacente ».
Un tel langage met en évidence comment la technologie pourrait concurrencer directement, plutôt que de transformer, l’œuvre originale.
Un document Microsoft indique qu’il existe un « risque réel » que l’IA générative puisse « perturber de manière significative l’emploi des personnes mêmes qui ont généré les données sur lesquelles le modèle de base a été entraîné ».
L’ampleur purement numérique du copiage est frappante. Les documents révèlent pour la première fois que les ensembles de données d’entraînement intermédiaires d’OpenAI contiennent à eux seuls plus de 91 692 copies d’œuvres publiées par le NYT, le Daily News et le Center for Investigative Reporting. Un ensemble de données dérivé de Common Crawl comprenait plus de 2 millions de documents provenant uniquement de nytimes.com.
Dans une note interne de janvier 2023, Hecht l’a qualifié d’« un vol stupéfiant de proportions sans précédent » et « du plus grand vol de travail de l’histoire humaine ».
Le dépôt fournit de nouveaux détails sur la manière dont OpenAI et Microsoft ont acquis le contenu des plaignants, y compris en le grattant à partir de l’Index Bing.
« OpenAI a transmis l’intégralité de l’ensemble de données d’entraînement de GPT-3 à Microsoft, que Microsoft a utilisé pour évaluer comment implémenter les modèles d’OpenAI dans ses propres produits commerciaux », indique le dépôt. « Microsoft a également fourni des données d’entraînement à OpenAI par le biais d’initiatives appelées Project Taxi et Project Mango. »
Les entreprises auraient assemblé les données de Project Mango en un ensemble de données d’entraînement contenant des copies d’au moins 160 903 œuvres uniques provenant d’éditeurs de presse.
Pour maximiser l’efficacité de leur grattage, les employés d’OpenAI auraient conçu un plan pour contourner les paywalls sans être détectés. Les dépôts montrent que lorsque le chercheur d’OpenAI, Nick Ryder, a informé Brockman d’un « hack pour contourner le paywall du New York Times », Brockman a répondu : « ah nice ».
Les employés d’OpenAI auraient également construit des ensembles de données d’entraînement comme WebText et WebText2 qui s’appuyaient de manière disproportionnée sur du contenu journalistique gratté. Ils auraient également extrait des millions d’articles de Common Crawl, un dépôt gratuit et ouvert de données de crawl web. Les résultats décrivent également des efforts délibérés pour retirer les mentions de droits d’auteur des données d’entraînement avant qu’elles n’atteignent le modèle, car les chercheurs « ne voudraient pas que le modèle produise » des « mentions de droits d’auteur » aux utilisateurs.
OpenAI et Microsoft n’ont pas répondu aux demandes de commentaire.
Article connexe
 OpenAI GPT-6 réduit de moitié les coûts des jetons sur l'ensemble des benchmarks, tandis que Sol et Luna rejoignent le projet
Selon Artificial Analysis, le GPT-6 Sol (max) se classe en tête des modèles en termes d’intelligence, au prix de 48 dollars. Crédit photo : Getty ImagesAprès le lancement par OpenAI des modèles GPT-6
Le cimetière de l'IA : une liste actualisée des projets et start-ups qui n'ont pas survécu
Relay, une plateforme d’automatisation des flux de travail basée sur l’IA et présentée comme une alternative à Zapier, a cessé ses activités lundi. Le service permettait aux utilisateurs d’automatiser
OpenAI mise sur les familles alors que ChatGPT s’immisce davantage dans les foyers
Plus de trois ans après que ChatGPT a propulsé l’intelligence artificielle générative sous les feux des projecteurs, OpenAI élargit son champ d’action, passant des utilisateurs individuels à l’ensemble des foyers.OpenAI recrute un responsable de prod
Recommandations de sujets spéciaux liés
Finance
 Outils de prévision budgétaire Excel alimentés par l’IA pour la planification des flux de trésorerie et le contrôle des dépenses
Les meilleurs outils Excel alimentés par l’IA de 2026 pour la planification des flux de trésorerie et le contrôle des dépenses sont disponibles sur la liste soigneusement sélectionnée et hautement notée de XIX.AI. Ces solutions puissantes et transformatrices vous aident à augmenter considérablement votre productivité grâce à des tests concrets et à des classements rigoureux. Obtenez une comparaison gratuite entre les versions gratuites et payantes afin de trouver celle qui correspond parfaitement à vos besoins. Explorez dès maintenant pour débloquer votre avantage concurrentiel grâce à l’intelligence artificielle dans la gestion financière.
 9 outils
 xix.ai
Rapide
Outils de gestion des invites IA pour les équipes
2026 Derniers Meilleurs Outils de Gestion de Prompts IA les mieux notés pour les équipes sont sélectionnés par XIX.AI ici. Ce guide mis à jour chaque semaine présente des solutions puissantes qui changent la donne et augmentent considérablement la productivité des équipes grâce à des tests concrets et des classements détaillés. Obtenez une comparaison gratuite entre les versions gratuites et payantes pour vous aider à choisir l’outil parfait. Explorez dès maintenant pour débloquer votre avantage IA.
9 outils
xix.ai
Composition musicale
Outils d'IA pour la création de paroles destinés à la composition musicale
Les meilleurs outils d'IA pour la création de paroles en 2026, les mieux notés pour la composition musicale, sont disponibles ici sur XIX.AI ! Cette sélection soigneusement élaborée propose des options puissantes et révolutionnaires, testées en conditions réelles, qui permettent de générer rapidement des concepts de paroles de haute qualité, aidant ainsi les utilisateurs à stimuler leur créativité et à optimiser leur processus de création musicale. Découvrez également un comparatif entre les versions gratuites et payantes. Explorez dès maintenant notre sélection pour trouver l'outil qui vous convient le mieux !
16 outils
xix.ai
Création de bande dessinée
Outils de fiche de personnage IA pour la construction de l'univers des bandes dessinées
2026 Derniers Meilleurs Outils de Feuille de Personnage IA les Plus Évalués pour la Création de Mondes de Bande Dessinée sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des options puissantes et révolutionnaires qui ont subi des tests rigoureux en conditions réelles. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine pour vous aider à découvrir les outils incontournables qui stimulent votre créativité et rationalisent les tâches de création de monde. Explorez dès maintenant pour débloquer votre avantage IA !
13 outils
xix.ai
automation
Outils d'automatisation basés sur l'IA de n8n pour les opérations internes, la synchronisation des données et les flux d'agents en plusieurs étapes
Les meilleurs outils d'automatisation IA n8n de 2026 pour les opérations internes, la synchronisation des données et les flux d'agents en plusieurs étapes sont enfin disponibles ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui boostent la productivité dans toutes les tâches professionnelles. Chaque outil est soumis à des tests rigoureux en conditions réelles pour garantir sa fiabilité, avec une comparaison détaillée entre les versions gratuites et payantes ainsi qu'un classement mis à jour chaque semaine. Ces outils incontournables vous aideront à tirer pleinement parti de l'IA et à rationaliser vos flux de travail sans effort. Explorez-les dès maintenant pour découvrir celui qui vous convient le mieux !
11 outils
xix.ai
Rapide
Les meilleurs outils de gestion des prompts pour les équipes multimodèles
2026 : les meilleurs outils de gestion des prompts, les mieux notés, pour les équipes multimodèles ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires à ne pas manquer, accompagnés de comparaisons entre versions gratuites et payantes, de tests en conditions réelles et de classements détaillés. Ces solutions haut de gamme contribuent à augmenter considérablement la productivité en rationalisant les flux de travail, en éliminant les tâches répétitives et en libérant la créativité dans tous les projets de l'équipe. Explorez-les dès maintenant pour découvrir l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

 commentaires (0)
Les documents déclassifiés du procès en contrefaçon de trois ans intenté par The New York Times contre OpenAI et Microsoft révèlent une admission selon laquelle le grattage d’informations par l’intelligence artificielle constitue un vol et pose une menace grave pour les médias.
Selon le procès, un dirigeant de haut niveau de Microsoft a qualifié en privé les méthodes d’entraînement des entreprises d’« vol », tandis que la direction d’OpenAI a reconnu que ses modèles créaient une « menace existentielle » pour les éditeurs et journalistes dont le contenu les avait entraînés.
Les nouveaux documents déclassifiés détaillent également comment les entreprises auraient accès et utilisé ce contenu en contournant les paywalls sans être détectées, en construisant des ensembles de données d’entraînement par un grattage massif et en retirant intentionnellement les mentions de droits d’auteur des données.
Il est important de noter que la plupart de ces nouvelles informations proviennent des propres conclusions juridiques du Times plutôt que des pièces sous scellé, qui restent confidentielles. Les citations ci-dessous sont présentées sans leur contexte original.
Ce dépôt non censuré marque la dernière escalade dans le procès de trois ans, où The New York Times a initialement affirmé que les entreprises avaient violé la loi sur le droit d’auteur en entraînant des modèles d’IA générative sur son contenu.
Il n’existe pas de réponse juridique claire quant à la légalité pour les entreprises d’IA d’utiliser du matériel protégé par le droit d’auteur à des fins d’entraînement, bien que les juges aient généralement favorisé l’argument des entreprises d’IA selon lequel un tel entraînement relève de l’« usage loyal ». Cette doctrine juridique permet l’utilisation d’œuvres protégées sans autorisation dans des cas spécifiques, tels que la parodie, le reportage d’actualités ou la critique. Plus tôt ce mois-ci, l’administration Trump a déposé des conclusions soutenant l’utilisation non licenciée par OpenAI de matériel protégé par le droit d’auteur pour entraîner ses grands modèles de langage.
Cependant, plusieurs de ces nouvelles admissions contredisent la défense de l’usage loyal d’OpenAI, en particulier l’exigence selon laquelle une telle utilisation ne se substitue pas à l’œuvre originale et ne nuit pas à son marché.
Par exemple, les propres données de Microsoft indiquent que son « moteur de réponses » Copilot a fait chuter les taux de clic vers le domaine du New York Times jusqu’à 93 % par rapport aux recherches traditionnelles sur Bing. Une présentation interne de Microsoft rédigée par Brent Hecht, directeur de la science appliquée de Microsoft, en janvier 2024, décrit cette baisse comme une « boucle infernale » qui nuirait simultanément « aux performances de nos modèles et à l’ensemble du web ».
« Il est très inhabituel qu’un produit final menace les fondements économiques de ses fournisseurs essentiels, mais c’est la situation que nous avons créée pour notre entreprise de grands modèles de langage par rapport à sa « chaîne d’approvisionnement en contenu », déclare le document Microsoft, tel que cité dans le dépôt.
Le PDG de Microsoft, Satya Nadella, a également témoigné lors d’une déposition plus tôt cette année que « tout ce qui est soumis à un paywall devrait être licencié par quiconque souhaite l’utiliser… pour l’ancrage ou l’entraînement », et a précisé qu’il aurait « invoqué [le droit de Microsoft d’exiger] qu’OpenAI réentraîne ses modèles » s’il avait « été informé qu’OpenAI avait gratté et entraîné des informations derrière un paywall ».
D’autres admissions sapent différents aspects du test de l’usage loyal : le responsable de ChatGPT d’OpenAI, Nick Turley, a écrit dans des communications internes que les éditeurs font face à une « menace existentielle » de la part de produits comme le chatbot, qui sont « largement substituables » et « deviendront de plus en plus substituables à mesure qu’ils s’amélioreront ».
Le président d’OpenAI, Greg Brockman, a décrit les modèles comme « excellents pour les actualités ». Nadella a convenu sous serment plus tôt cette année que l’interaction avec les chatbots « a substitué … vous donnant l’information directement sur le site web de la plateforme d’IA plutôt que d’avoir à aller à la source sous-jacente ».
Un tel langage met en évidence comment la technologie pourrait concurrencer directement, plutôt que de transformer, l’œuvre originale.
Un document Microsoft indique qu’il existe un « risque réel » que l’IA générative puisse « perturber de manière significative l’emploi des personnes mêmes qui ont généré les données sur lesquelles le modèle de base a été entraîné ».
L’ampleur purement numérique du copiage est frappante. Les documents révèlent pour la première fois que les ensembles de données d’entraînement intermédiaires d’OpenAI contiennent à eux seuls plus de 91 692 copies d’œuvres publiées par le NYT, le Daily News et le Center for Investigative Reporting. Un ensemble de données dérivé de Common Crawl comprenait plus de 2 millions de documents provenant uniquement de nytimes.com.
Dans une note interne de janvier 2023, Hecht l’a qualifié d’« un vol stupéfiant de proportions sans précédent » et « du plus grand vol de travail de l’histoire humaine ».
Le dépôt fournit de nouveaux détails sur la manière dont OpenAI et Microsoft ont acquis le contenu des plaignants, y compris en le grattant à partir de l’Index Bing.
« OpenAI a transmis l’intégralité de l’ensemble de données d’entraînement de GPT-3 à Microsoft, que Microsoft a utilisé pour évaluer comment implémenter les modèles d’OpenAI dans ses propres produits commerciaux », indique le dépôt. « Microsoft a également fourni des données d’entraînement à OpenAI par le biais d’initiatives appelées Project Taxi et Project Mango. »
Les entreprises auraient assemblé les données de Project Mango en un ensemble de données d’entraînement contenant des copies d’au moins 160 903 œuvres uniques provenant d’éditeurs de presse.
Pour maximiser l’efficacité de leur grattage, les employés d’OpenAI auraient conçu un plan pour contourner les paywalls sans être détectés. Les dépôts montrent que lorsque le chercheur d’OpenAI, Nick Ryder, a informé Brockman d’un « hack pour contourner le paywall du New York Times », Brockman a répondu : « ah nice ».
Les employés d’OpenAI auraient également construit des ensembles de données d’entraînement comme WebText et WebText2 qui s’appuyaient de manière disproportionnée sur du contenu journalistique gratté. Ils auraient également extrait des millions d’articles de Common Crawl, un dépôt gratuit et ouvert de données de crawl web. Les résultats décrivent également des efforts délibérés pour retirer les mentions de droits d’auteur des données d’entraînement avant qu’elles n’atteignent le modèle, car les chercheurs « ne voudraient pas que le modèle produise » des « mentions de droits d’auteur » aux utilisateurs.
OpenAI et Microsoft n’ont pas répondu aux demandes de commentaire.








 OpenAI GPT-6 réduit de moitié les coûts des jetons sur l'ensemble des benchmarks, tandis que Sol et Luna rejoignent le projet
Selon Artificial Analysis, le GPT-6 Sol (max) se classe en tête des modèles en termes d’intelligence, au prix de 48 dollars. Crédit photo : Getty ImagesAprès le lancement par OpenAI des modèles GPT-6
 Le cimetière de l'IA : une liste actualisée des projets et start-ups qui n'ont pas survécu
Relay, une plateforme d’automatisation des flux de travail basée sur l’IA et présentée comme une alternative à Zapier, a cessé ses activités lundi. Le service permettait aux utilisateurs d’automatiser
 OpenAI mise sur les familles alors que ChatGPT s’immisce davantage dans les foyers
Plus de trois ans après que ChatGPT a propulsé l’intelligence artificielle générative sous les feux des projecteurs, OpenAI élargit son champ d’action, passant des utilisateurs individuels à l’ensemble des foyers.OpenAI recrute un responsable de prod

Les meilleurs outils Excel alimentés par l’IA de 2026 pour la planification des flux de trésorerie et le contrôle des dépenses sont disponibles sur la liste soigneusement sélectionnée et hautement notée de XIX.AI. Ces solutions puissantes et transformatrices vous aident à augmenter considérablement votre productivité grâce à des tests concrets et à des classements rigoureux. Obtenez une comparaison gratuite entre les versions gratuites et payantes afin de trouver celle qui correspond parfaitement à vos besoins. Explorez dès maintenant pour débloquer votre avantage concurrentiel grâce à l’intelligence artificielle dans la gestion financière.
9 outils
xix.ai

2026 Derniers Meilleurs Outils de Gestion de Prompts IA les mieux notés pour les équipes sont sélectionnés par XIX.AI ici. Ce guide mis à jour chaque semaine présente des solutions puissantes qui changent la donne et augmentent considérablement la productivité des équipes grâce à des tests concrets et des classements détaillés. Obtenez une comparaison gratuite entre les versions gratuites et payantes pour vous aider à choisir l’outil parfait. Explorez dès maintenant pour débloquer votre avantage IA.
9 outils
xix.ai

Les meilleurs outils d'IA pour la création de paroles en 2026, les mieux notés pour la composition musicale, sont disponibles ici sur XIX.AI ! Cette sélection soigneusement élaborée propose des options puissantes et révolutionnaires, testées en conditions réelles, qui permettent de générer rapidement des concepts de paroles de haute qualité, aidant ainsi les utilisateurs à stimuler leur créativité et à optimiser leur processus de création musicale. Découvrez également un comparatif entre les versions gratuites et payantes. Explorez dès maintenant notre sélection pour trouver l'outil qui vous convient le mieux !
16 outils
xix.ai
2026 Derniers Meilleurs Outils de Feuille de Personnage IA les Plus Évalués pour la Création de Mondes de Bande Dessinée sont ici sur XIX.AI ! Cette liste soigneusement sélectionnée propose des options puissantes et révolutionnaires qui ont subi des tests rigoureux en conditions réelles. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements mis à jour chaque semaine pour vous aider à découvrir les outils incontournables qui stimulent votre créativité et rationalisent les tâches de création de monde. Explorez dès maintenant pour débloquer votre avantage IA !
13 outils
xix.ai
Les meilleurs outils d'automatisation IA n8n de 2026 pour les opérations internes, la synchronisation des données et les flux d'agents en plusieurs étapes sont enfin disponibles ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui boostent la productivité dans toutes les tâches professionnelles. Chaque outil est soumis à des tests rigoureux en conditions réelles pour garantir sa fiabilité, avec une comparaison détaillée entre les versions gratuites et payantes ainsi qu'un classement mis à jour chaque semaine. Ces outils incontournables vous aideront à tirer pleinement parti de l'IA et à rationaliser vos flux de travail sans effort. Explorez-les dès maintenant pour découvrir celui qui vous convient le mieux !
11 outils
xix.ai
2026 : les meilleurs outils de gestion des prompts, les mieux notés, pour les équipes multimodèles ! XIX.AI a sélectionné une gamme d'outils puissants et révolutionnaires à ne pas manquer, accompagnés de comparaisons entre versions gratuites et payantes, de tests en conditions réelles et de classements détaillés. Ces solutions haut de gamme contribuent à augmenter considérablement la productivité en rationalisant les flux de travail, en éliminant les tâches répétitives et en libérant la créativité dans tous les projets de l'équipe. Explorez-les dès maintenant pour découvrir l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai












