


 Heim
Microsoft-Exekutive bezeichnen das Scrapen von KI-Daten als „den größten Diebstahl von Arbeit in der Geschichte“, wie unzensierte Akten zeigen
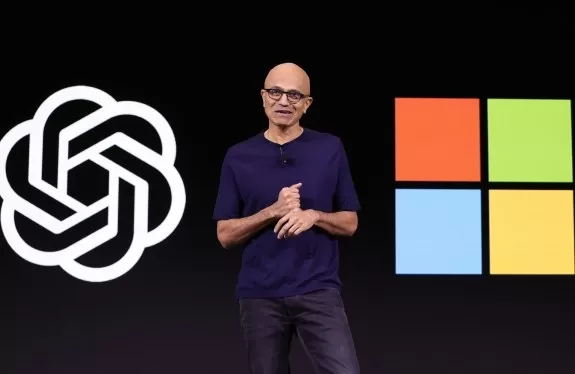
Ungeöffnete Dokumente aus dem dreijährigen Urheberrechtsklageverfahren, das die New York Times gegen OpenAI und Microsoft eingereicht hat, offenbaren ein Geständnis, dass das Scraping von KI-Daten Diebstahl darstellt und eine schwere Bedrohung für Medienunternehmen darstellt.
Laut der Klage hat ein leitender Microsoft-Funktionär die KI-Trainingsmethoden der Unternehmen intern als „Diebstahl“ bezeichnet, während die Führung von OpenAI anerkannte, dass ihre Modelle eine „existenzielle Bedrohung“ für die Verlage und Journalisten darstellten, deren Inhalte sie trainierten.
Die neu freigegebenen Aufzeichnungen erläutern auch, wie die Unternehmen angeblich auf diese Inhalte zugriffen und sie nutzten, indem sie Paywalls unbemerkt umgingen, Trainingsdatensätze durch massives Scraping erstellten und Urheberrechtshinweise vorsätzlich aus den Daten entfernten.
Es ist wichtig anzumerken, dass ein Großteil dieser neuen Informationen aus den eigenen rechtlichen Schriftsätzen der Times stammt und nicht aus den zugrunde liegenden Beweismitteln, die weiterhin unter Verschluss stehen. Die unten stehenden Zitate werden ohne ihren ursprünglichen Kontext dargestellt.
Dieser unzensierte Antrag markiert die neueste Eskalation in der dreijährigen Klage, bei der die New York Times ursprünglich behauptete, die Firmen hätten das Urheberrechtsgesetz verletzt, indem sie generative KI-Modelle mit ihren Inhalten trainierten.
Es gibt keine klare rechtliche Antwort darauf, ob KI-Unternehmen urheberrechtlich geschütztes Material legal für Trainingszwecke nutzen dürfen, obwohl Richter im Allgemeinen die Argumentation der KI-Unternehmen bevorzugt haben, dass solches Training als „fair use“ (angemessene Nutzung) qualifiziert. Diese Rechtsdoktrin erlaubt die Nutzung urheberrechtlich geschützter Werke ohne Erlaubnis in bestimmten Fällen, wie Parodie, Nachrichtenberichterstattung oder Kritik. Anfang dieses Monats reichte die Trump-Verwaltung ein Schriftsatz ein, der die lizenzierte Nutzung urheberrechtlich geschützten Materials durch OpenAI zum Training ihrer großen Sprachmodelle unterstützte.
Einige dieser neuen Geständnisse widersprechen jedoch der Fair-Use-Verteidigung von OpenAI, insbesondere der Anforderung, dass eine solche Nutzung das Originalwerk nicht ersetzt oder dessen Markt schädigt.
So zeigen die eigenen Daten von Microsoft, dass die „Answer Engine“ von Copilot die Click-Through-Raten für die Domain der New York Times im Vergleich zu herkömmlichen Bing-Suchen um bis zu 93 % sinken ließ. Eine interne Microsoft-Präsentation von Brent Hecht, Microsofts Direktor für Angewandte Wissenschaft, aus Januar 2024, beschreibt diesen Rückgang als „Doom-Loop“ (Abwärtsspirale), der gleichzeitig „die Leistung unserer Modelle und das gesamte Web schädigen“ würde.
„Es ist höchst ungewöhnlich, dass ein Endprodukt die wirtschaftlichen Grundlagen seiner wesentlichen Lieferanten bedroht, aber genau diese Situation haben wir für unser LLM-Geschäft bezüglich seiner ‚Inhaltslieferkette‘ geschaffen“, heißt es im Microsoft-Dokument, wie im Antrag zitiert.
Der Microsoft-Vorstandsvorsitzende Satya Nadella sagte auch in einer Vernehmung zu Beginn dieses Jahres aus, dass „alles, was hinter einer Paywall steht, von jedem lizenziert werden sollte, der es verwenden möchte … für Grounding oder Training“, und präzisierte, dass er, wenn er „gewusst hätte, dass OpenAI hinter einer Paywall liegende Informationen gescraped und damit trainiert hat“, „das Recht von [Microsoft] angewendet hätte, OpenAI zur Neustrainierung seiner Modelle zu verpflichten“.
Andere Geständnisse untergraben verschiedene Aspekte des Fair-Use-Tests: OpenAIs Leiter von ChatGPT, Nick Turley, schrieb in internen Kommunikationen, dass Verlage eine „existenzielle Bedrohung“ durch Produkte wie den Chatbot erleben, die „weitgehend substituierend“ sind und „immer substituierender werden, je besser sie werden“.
OpenAIs Präsident Greg Brockman beschrieb die Modelle als „hervorragend in den Nachrichten“. Nadella stimmte zu Beginn dieses Jahres unter Eid zu, dass die Interaktion mit Chatbots „ersetzt … Ihnen die Informationen direkt auf der Website auf der KI-Plattform zu geben, anstatt zur ursprünglichen Quelle gehen zu müssen“.
Solche Formulierungen verdeutlichen, wie die Technologie direkt mit dem Originalwerk konkurrieren könnte, anstatt es zu transformieren.
Ein Microsoft-Dokument besagt, dass ein „reales Risiko“ besteht, dass generative KI die Beschäftigung derjenigen Menschen erheblich stören könnte, die die Daten generiert haben, auf denen das Foundation-Modell trainiert wurde.
Der schiere Umfang der Kopie ist auffällig. Die Dokumente enthüllen erstmals, dass die Mid-Training-Datensätze von OpenAI allein mehr als 91.692 Kopien von Werken enthalten, die von der NYT, dem Daily News und dem Center for Investigative Reporting veröffentlicht wurden. Ein Datensatz, der von Common Crawl abgeleitet wurde, enthielt mehr als 2 Millionen Dokumente allein von nytimes.com.
In einem internen Memo vom Januar 2023 nannte Hecht es „einen erstaunlichen Diebstahl von beispiellosem Ausmaß“ und „den größten Diebstahl von Arbeitskraft in der Geschichte der Menschheit“.
Der Antrag liefert neue Details darüber, wie OpenAI und Microsoft die Inhalte der Kläger erwarben, einschließlich des Scrapings aus dem Bing-Index.
„OpenAI lieferte den gesamten GPT-3-Trainingsdatensatz an Microsoft, den Microsoft nutzte, um zu bewerten, wie OpenAIs Modelle in seinen eigenen kommerziellen Produkten implementiert werden können“, heißt es im Antrag. „Microsoft stellte OpenAI ebenfalls Trainingsdaten durch Initiativen namens Project Taxi und Project Mango zur Verfügung.“
Die Unternehmen sollen die Daten von Project Mango zu einem Trainingsdatensatz zusammengefügt haben, der Kopien von mindestens 160.903 einzigartigen Werken von Nachrichtenverlagen enthielt.
Um die Effektivität ihres Scrapings zu maximieren, entwickelten OpenAI-Mitarbeiter angeblich einen Plan, Paywalls unbemerkt zu umgehen. Die Akten zeigen, dass OpenAI-Forscher Nick Ryder Brockman über einen „Hack, um die nytimes-Paywall zu umgehen“ informierte, woraufhin Brockman antwortete: „ah nice“.
OpenAI-Mitarbeiter sollen angeblich Trainingsdatensätze wie WebText und WebText2 erstellt haben, die überproportional auf gescrapte Nachrichteninhalte zurückgriffen. Sie sollen angeblich Millionen von Artikeln aus Common Crawl, einem kostenlosen, offenen Repository für Web-Crawl-Daten, extrahiert haben. Die Ergebnisse beschreiben auch gezielte Bemühungen, Urheberrechtshinweise aus den Trainingsdaten zu entfernen, bevor sie das Modell erreichten, da Forscher „nicht wollten, dass das Modell“ „Urheberrechtshinweise“ an die Benutzer ausgibt.
OpenAI und Microsoft gaben keine Kommentare auf Anfragen zurück.
Verwandter Artikel
 OpenAI GPT-6 halbiert die Token-Kosten in allen Benchmarks – Sol und Luna kommen hinzu
Laut Artificial Analysis ist GPT-6 Sol (max) das führende Modell in Sachen Intelligenz und kostet 48 US-Dollar. Bildnachweis: Getty ImagesNachdem OpenAI GPT-6 Sol und Luna veröffentlicht hatte, erläut
Der KI-Friedhof: Eine fortlaufende Liste von Projekten und Start-ups, die es nicht geschafft haben
Relay, eine KI-gestützte Plattform zur Workflow-Automatisierung, die als Alternative zu Zapier positioniert war, hat am Montag den Betrieb eingestellt. Der Dienst ermöglichte es Nutzern, E-Mail- und A
OpenAI setzt auf Familien, während ChatGPT tiefer in die Haushalte eindringt
Seit mehr als drei Jahren, seitdem ChatGPT die generative KI in den Mittelpunkt der Aufmerksamkeit gerückt hat, erweitert OpenAI seinen Anwendungsbereich von einzelnen Nutzern auf ganze Haushalte.OpenAI stellt einen Produktmanager in San Francisco ei
Empfehlungen zu verwandten Spezialthemen
Prompt
 AI-Prompt-Management-Tools für Teams
2026 Neueste Besten Top-Bewertete KI-Prompt-Management-Tools für Teams werden hier von XIX.AI kuratiert. Dieser wöchentlich aktualisierte Leitfaden bietet leistungsstarke, bahnbrechende Lösungen, die die Produktivität von Teams durch reale Tests und detaillierte Ranglisten erheblich steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Version, um das perfekte Tool auszuwählen. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten.
 9 Tools
 xix.ai
Musikkomposition
KI-Tools zur Erarbeitung von Songtexten für die Musikkomposition
Die besten und am besten bewerteten KI-Tools für Songtextideen zur Musikkomposition des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Optionen, die in der Praxis getestet wurden, um schnell hochwertige Songtextkonzepte zu liefern. So können Nutzer ihre Kreativität steigern und ihren Musikschaffungsprozess optimieren. Erhalten Sie außerdem einen Überblick über den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie jetzt das perfekte Tool für sich!
16 Tools
xix.ai
Comic-Erstellung
Werkzeuge für KI-Charakterbögen zur Erstellung von Comic-Welten
2026 Neueste Besten Top-Bewerteten KI-Charakterbogen-Tools für Comic-Weltenerstellung sind hier auf XIX.AI! Diese kuratierte Liste bietet leistungsstarke, revolutionäre Optionen, die strengen Praxistests unterzogen wurden. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, die unbedingt auszuprobierenden Tools zu entdecken, die Ihre Kreativität fördern und Weltenerstellungsaufgaben optimieren. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
13 Tools
xix.ai
Automatisierung
n8n-KI-Automatisierungstools für interne Abläufe, Datensynchronisation und mehrstufige Agentenabläufe
Die neuesten und besten n8n-KI-Automatisierungstools für interne Abläufe, Datensynchronisation und mehrstufige Agentenabläufe für das Jahr 2026 sind da! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die die Produktivität bei allen Arbeitsaufgaben steigern. Jeder Eintrag durchläuft strenge Praxistests, um seine Zuverlässigkeit zu gewährleisten, und wird mit einem detaillierten Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierten Rankings präsentiert. Diese unverzichtbaren Optionen helfen Ihnen dabei, Ihren KI-Vorteil zu nutzen und Arbeitsabläufe mühelos zu optimieren. Entdecken Sie jetzt das perfekte Tool für Sie!
11 Tools
xix.ai
Prompt
Die besten Tools für das Prompt-Management in Teams mit mehreren Modellen
2026: Die neuesten und am besten bewerteten Prompt-Management-Tools für Multi-Modell-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Sie bietet einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und detaillierte Rankings. Diese erstklassigen Lösungen tragen dazu bei, die Produktivität erheblich zu steigern, indem sie Arbeitsabläufe optimieren, Wiederholungen vermeiden und die Kreativität in allen Teamprojekten fördern. Entdecken Sie jetzt das perfekte Tool für sich und legen Sie noch heute los!
9 Tools
xix.ai
Besprechungsassistent
KI-Tools zur Zusammenfassung von Besprechungen für Remote-Teams
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen für Remote-Teams im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Diese wurden in der Praxis getestet und liefern präzise Transkripte sowie umsetzbare Erkenntnisse. Hier finden Sie Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden, um die Produktivität zu steigern und die Teamkommunikation zu optimieren. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
13 Tools
xix.ai

 Kommentare (0)
Ungeöffnete Dokumente aus dem dreijährigen Urheberrechtsklageverfahren, das die New York Times gegen OpenAI und Microsoft eingereicht hat, offenbaren ein Geständnis, dass das Scraping von KI-Daten Diebstahl darstellt und eine schwere Bedrohung für Medienunternehmen darstellt.
Laut der Klage hat ein leitender Microsoft-Funktionär die KI-Trainingsmethoden der Unternehmen intern als „Diebstahl“ bezeichnet, während die Führung von OpenAI anerkannte, dass ihre Modelle eine „existenzielle Bedrohung“ für die Verlage und Journalisten darstellten, deren Inhalte sie trainierten.
Die neu freigegebenen Aufzeichnungen erläutern auch, wie die Unternehmen angeblich auf diese Inhalte zugriffen und sie nutzten, indem sie Paywalls unbemerkt umgingen, Trainingsdatensätze durch massives Scraping erstellten und Urheberrechtshinweise vorsätzlich aus den Daten entfernten.
Es ist wichtig anzumerken, dass ein Großteil dieser neuen Informationen aus den eigenen rechtlichen Schriftsätzen der Times stammt und nicht aus den zugrunde liegenden Beweismitteln, die weiterhin unter Verschluss stehen. Die unten stehenden Zitate werden ohne ihren ursprünglichen Kontext dargestellt.
Dieser unzensierte Antrag markiert die neueste Eskalation in der dreijährigen Klage, bei der die New York Times ursprünglich behauptete, die Firmen hätten das Urheberrechtsgesetz verletzt, indem sie generative KI-Modelle mit ihren Inhalten trainierten.
Es gibt keine klare rechtliche Antwort darauf, ob KI-Unternehmen urheberrechtlich geschütztes Material legal für Trainingszwecke nutzen dürfen, obwohl Richter im Allgemeinen die Argumentation der KI-Unternehmen bevorzugt haben, dass solches Training als „fair use“ (angemessene Nutzung) qualifiziert. Diese Rechtsdoktrin erlaubt die Nutzung urheberrechtlich geschützter Werke ohne Erlaubnis in bestimmten Fällen, wie Parodie, Nachrichtenberichterstattung oder Kritik. Anfang dieses Monats reichte die Trump-Verwaltung ein Schriftsatz ein, der die lizenzierte Nutzung urheberrechtlich geschützten Materials durch OpenAI zum Training ihrer großen Sprachmodelle unterstützte.
Einige dieser neuen Geständnisse widersprechen jedoch der Fair-Use-Verteidigung von OpenAI, insbesondere der Anforderung, dass eine solche Nutzung das Originalwerk nicht ersetzt oder dessen Markt schädigt.
So zeigen die eigenen Daten von Microsoft, dass die „Answer Engine“ von Copilot die Click-Through-Raten für die Domain der New York Times im Vergleich zu herkömmlichen Bing-Suchen um bis zu 93 % sinken ließ. Eine interne Microsoft-Präsentation von Brent Hecht, Microsofts Direktor für Angewandte Wissenschaft, aus Januar 2024, beschreibt diesen Rückgang als „Doom-Loop“ (Abwärtsspirale), der gleichzeitig „die Leistung unserer Modelle und das gesamte Web schädigen“ würde.
„Es ist höchst ungewöhnlich, dass ein Endprodukt die wirtschaftlichen Grundlagen seiner wesentlichen Lieferanten bedroht, aber genau diese Situation haben wir für unser LLM-Geschäft bezüglich seiner ‚Inhaltslieferkette‘ geschaffen“, heißt es im Microsoft-Dokument, wie im Antrag zitiert.
Der Microsoft-Vorstandsvorsitzende Satya Nadella sagte auch in einer Vernehmung zu Beginn dieses Jahres aus, dass „alles, was hinter einer Paywall steht, von jedem lizenziert werden sollte, der es verwenden möchte … für Grounding oder Training“, und präzisierte, dass er, wenn er „gewusst hätte, dass OpenAI hinter einer Paywall liegende Informationen gescraped und damit trainiert hat“, „das Recht von [Microsoft] angewendet hätte, OpenAI zur Neustrainierung seiner Modelle zu verpflichten“.
Andere Geständnisse untergraben verschiedene Aspekte des Fair-Use-Tests: OpenAIs Leiter von ChatGPT, Nick Turley, schrieb in internen Kommunikationen, dass Verlage eine „existenzielle Bedrohung“ durch Produkte wie den Chatbot erleben, die „weitgehend substituierend“ sind und „immer substituierender werden, je besser sie werden“.
OpenAIs Präsident Greg Brockman beschrieb die Modelle als „hervorragend in den Nachrichten“. Nadella stimmte zu Beginn dieses Jahres unter Eid zu, dass die Interaktion mit Chatbots „ersetzt … Ihnen die Informationen direkt auf der Website auf der KI-Plattform zu geben, anstatt zur ursprünglichen Quelle gehen zu müssen“.
Solche Formulierungen verdeutlichen, wie die Technologie direkt mit dem Originalwerk konkurrieren könnte, anstatt es zu transformieren.
Ein Microsoft-Dokument besagt, dass ein „reales Risiko“ besteht, dass generative KI die Beschäftigung derjenigen Menschen erheblich stören könnte, die die Daten generiert haben, auf denen das Foundation-Modell trainiert wurde.
Der schiere Umfang der Kopie ist auffällig. Die Dokumente enthüllen erstmals, dass die Mid-Training-Datensätze von OpenAI allein mehr als 91.692 Kopien von Werken enthalten, die von der NYT, dem Daily News und dem Center for Investigative Reporting veröffentlicht wurden. Ein Datensatz, der von Common Crawl abgeleitet wurde, enthielt mehr als 2 Millionen Dokumente allein von nytimes.com.
In einem internen Memo vom Januar 2023 nannte Hecht es „einen erstaunlichen Diebstahl von beispiellosem Ausmaß“ und „den größten Diebstahl von Arbeitskraft in der Geschichte der Menschheit“.
Der Antrag liefert neue Details darüber, wie OpenAI und Microsoft die Inhalte der Kläger erwarben, einschließlich des Scrapings aus dem Bing-Index.
„OpenAI lieferte den gesamten GPT-3-Trainingsdatensatz an Microsoft, den Microsoft nutzte, um zu bewerten, wie OpenAIs Modelle in seinen eigenen kommerziellen Produkten implementiert werden können“, heißt es im Antrag. „Microsoft stellte OpenAI ebenfalls Trainingsdaten durch Initiativen namens Project Taxi und Project Mango zur Verfügung.“
Die Unternehmen sollen die Daten von Project Mango zu einem Trainingsdatensatz zusammengefügt haben, der Kopien von mindestens 160.903 einzigartigen Werken von Nachrichtenverlagen enthielt.
Um die Effektivität ihres Scrapings zu maximieren, entwickelten OpenAI-Mitarbeiter angeblich einen Plan, Paywalls unbemerkt zu umgehen. Die Akten zeigen, dass OpenAI-Forscher Nick Ryder Brockman über einen „Hack, um die nytimes-Paywall zu umgehen“ informierte, woraufhin Brockman antwortete: „ah nice“.
OpenAI-Mitarbeiter sollen angeblich Trainingsdatensätze wie WebText und WebText2 erstellt haben, die überproportional auf gescrapte Nachrichteninhalte zurückgriffen. Sie sollen angeblich Millionen von Artikeln aus Common Crawl, einem kostenlosen, offenen Repository für Web-Crawl-Daten, extrahiert haben. Die Ergebnisse beschreiben auch gezielte Bemühungen, Urheberrechtshinweise aus den Trainingsdaten zu entfernen, bevor sie das Modell erreichten, da Forscher „nicht wollten, dass das Modell“ „Urheberrechtshinweise“ an die Benutzer ausgibt.
OpenAI und Microsoft gaben keine Kommentare auf Anfragen zurück.








 OpenAI GPT-6 halbiert die Token-Kosten in allen Benchmarks – Sol und Luna kommen hinzu
Laut Artificial Analysis ist GPT-6 Sol (max) das führende Modell in Sachen Intelligenz und kostet 48 US-Dollar. Bildnachweis: Getty ImagesNachdem OpenAI GPT-6 Sol und Luna veröffentlicht hatte, erläut
 Der KI-Friedhof: Eine fortlaufende Liste von Projekten und Start-ups, die es nicht geschafft haben
Relay, eine KI-gestützte Plattform zur Workflow-Automatisierung, die als Alternative zu Zapier positioniert war, hat am Montag den Betrieb eingestellt. Der Dienst ermöglichte es Nutzern, E-Mail- und A
 OpenAI setzt auf Familien, während ChatGPT tiefer in die Haushalte eindringt
Seit mehr als drei Jahren, seitdem ChatGPT die generative KI in den Mittelpunkt der Aufmerksamkeit gerückt hat, erweitert OpenAI seinen Anwendungsbereich von einzelnen Nutzern auf ganze Haushalte.OpenAI stellt einen Produktmanager in San Francisco ei

2026 Neueste Besten Top-Bewertete KI-Prompt-Management-Tools für Teams werden hier von XIX.AI kuratiert. Dieser wöchentlich aktualisierte Leitfaden bietet leistungsstarke, bahnbrechende Lösungen, die die Produktivität von Teams durch reale Tests und detaillierte Ranglisten erheblich steigern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Version, um das perfekte Tool auszuwählen. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten.
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Songtextideen zur Musikkomposition des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Optionen, die in der Praxis getestet wurden, um schnell hochwertige Songtextkonzepte zu liefern. So können Nutzer ihre Kreativität steigern und ihren Musikschaffungsprozess optimieren. Erhalten Sie außerdem einen Überblick über den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie jetzt das perfekte Tool für sich!
16 Tools
xix.ai
2026 Neueste Besten Top-Bewerteten KI-Charakterbogen-Tools für Comic-Weltenerstellung sind hier auf XIX.AI! Diese kuratierte Liste bietet leistungsstarke, revolutionäre Optionen, die strengen Praxistests unterzogen wurden. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich sowie wöchentlich aktualisierte Rankings, um Ihnen zu helfen, die unbedingt auszuprobierenden Tools zu entdecken, die Ihre Kreativität fördern und Weltenerstellungsaufgaben optimieren. Entdecken Sie jetzt, um Ihren KI-Vorteil freizuschalten!
13 Tools
xix.ai
Die neuesten und besten n8n-KI-Automatisierungstools für interne Abläufe, Datensynchronisation und mehrstufige Agentenabläufe für das Jahr 2026 sind da! XIX.AI hat eine Liste der besten leistungsstarken, bahnbrechenden Tools zusammengestellt, die die Produktivität bei allen Arbeitsaufgaben steigern. Jeder Eintrag durchläuft strenge Praxistests, um seine Zuverlässigkeit zu gewährleisten, und wird mit einem detaillierten Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierten Rankings präsentiert. Diese unverzichtbaren Optionen helfen Ihnen dabei, Ihren KI-Vorteil zu nutzen und Arbeitsabläufe mühelos zu optimieren. Entdecken Sie jetzt das perfekte Tool für Sie!
11 Tools
xix.ai
2026: Die neuesten und am besten bewerteten Prompt-Management-Tools für Multi-Modell-Teams! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Sie bietet einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Praxistests und detaillierte Rankings. Diese erstklassigen Lösungen tragen dazu bei, die Produktivität erheblich zu steigern, indem sie Arbeitsabläufe optimieren, Wiederholungen vermeiden und die Kreativität in allen Teamprojekten fördern. Entdecken Sie jetzt das perfekte Tool für sich und legen Sie noch heute los!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen für Remote-Teams im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Tools zusammengestellt, die Sie unbedingt ausprobieren sollten. Diese wurden in der Praxis getestet und liefern präzise Transkripte sowie umsetzbare Erkenntnisse. Hier finden Sie Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten sowie detaillierte Rankings, die Ihnen helfen, die perfekte Lösung zu finden, um die Produktivität zu steigern und die Teamkommunikation zu optimieren. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
13 Tools
xix.ai












