


 Hogar
Los ejecutivos de Microsoft califican el raspado de datos de IA como el mayor robo de trabajo en la historia, según documentos no enmendados
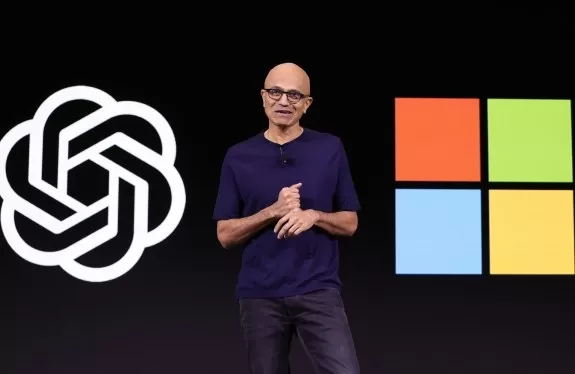
Los documentos desclasificados de la demanda por derechos de autor de tres años de antigüedad presentada por The New York Times contra OpenAI y Microsoft revelan una admisión de que el raspado de datos por parte de la inteligencia artificial constituye robo y representa una grave amenaza para los medios de comunicación.
Según la demanda, un alto directivo de Microsoft etiquetó privadamente los métodos de entrenamiento de inteligencia artificial de las compañías como "robo", mientras que el liderazgo de OpenAI reconoció que sus modelos crearon una "amenaza existencial" para los editores y periodistas cuyo contenido los entrenó.
Los registros recientemente desclasificados también detallan cómo las compañías supuestamente accedieron y utilizaron este contenido eludiendo los muros de pago sin ser detectadas, construyendo conjuntos de datos de entrenamiento mediante raspado masivo y eliminando intencionalmente los avisos de derechos de autor de los datos.
Es importante señalar que gran parte de esta nueva información proviene del propio escrito legal de The Times en lugar de los documentos adjuntos subyacentes, que permanecen sellados. Las citas a continuación se presentan sin su contexto original.
Este escrito sin censurar marca la última escalada en la demanda de tres años de antigüedad, donde The New York Times afirmó inicialmente que las empresas violaron la ley de derechos de autor al entrenar modelos de inteligencia artificial generativa con su contenido.
No hay una respuesta legal clara sobre si las empresas de inteligencia artificial pueden utilizar legalmente material con derechos de autor para el entrenamiento, aunque los jueces generalmente han favorecido el argumento de las compañías de inteligencia artificial de que dicho entrenamiento califica como "uso justo". Esta doctrina legal permite el uso de obras con derechos de autor sin permiso en instancias específicas, como parodias, reportajes de noticias o críticas. A principios de este mes, la administración Trump presentó un escrito apoyando el uso no licenciado por parte de OpenAI de material con derechos de autor para entrenar sus modelos de lenguaje grandes.
Sin embargo, varias de estas nuevas admisiones contradicen la defensa de uso justo de OpenAI, particularmente el requisito de que dicho uso no sustituya ni dañe el mercado de la obra original.
Por ejemplo, los propios datos de Microsoft indican que su "motor de respuestas" Copilot provocó que las tasas de clics para el dominio de The New York Times cayeran hasta un 93 % en comparación con las búsquedas tradicionales de Bing. Una presentación interna de Microsoft escrita por Brent Hecht, Director de Ciencia Aplicada de Microsoft, en enero de 2024, describe este declive como un "ciclo de la muerte" que dañaría simultáneamente "el rendimiento de nuestros modelos y de toda la web".
"Es muy inusual que un producto final amenace las bases económicas de sus proveedores esenciales, pero esa es la situación que hemos creado para nuestro negocio de modelos de lenguaje grandes con respecto a su 'cadena de suministro de contenido'", afirma el documento de Microsoft, según se cita en el escrito.
El director ejecutivo de Microsoft, Satya Nadella, también declaró en una declaración jurada a principios de este año que "cualquier contenido con muro de pago debería ser licenciado por cualquiera que desee utilizarlo... para fundamentar o entrenar", y aclaró que si hubiera "sido informado de que OpenAI había raspado y entrenado con información detrás de un muro de pago", habría "invocado [el derecho de Microsoft a] exigir que OpenAI vuelva a entrenar sus modelos".
Otras admisiones socavan diferentes aspectos de la prueba de uso justo: el jefe de ChatGPT de OpenAI, Nick Turley, escribió en comunicaciones internas que los editores enfrentan una "amenaza existencial" de productos como el chatbot, que son "largamente sustitutivos" y "se volverán cada vez más sustitutivos a medida que mejoren".
El presidente de OpenAI, Greg Brockman, describió los modelos como "excelentes para las noticias". Nadella estuvo de acuerdo bajo juramento a principios de este año que interactuar con chatbots "ha sustituido ... dándote la información directamente en el sitio web de la plataforma de inteligencia artificial en lugar de necesitar ir a la fuente subyacente".
Este tipo de lenguaje destaca cómo la tecnología podría competir directamente con, en lugar de transformar, la obra original.
Un documento de Microsoft afirma que existe un "riesgo real" de que la inteligencia artificial generativa pueda "perturbar significativamente el empleo de las mismas personas que generaron los datos en los que se entrenó el modelo base".
La escala masiva del copiado es impactante. Los documentos revelan por primera vez que los conjuntos de datos de entrenamiento intermedio de OpenAI contienen más de 91.692 copias de obras publicadas por el NYT, Daily News y Center for Investigative Reporting. Un conjunto de datos derivado de Common Crawl incluía más de 2 millones de documentos solo de nytimes.com.
En un memorando interno de enero de 2023, Hecht lo calificó como "un robo asombroso de proporciones sin precedentes" y "el mayor robo de trabajo en la historia de la humanidad".
El escrito proporciona nuevos detalles sobre cómo OpenAI y Microsoft adquirieron el contenido de los demandantes, incluido el raspado del Índice de Bing.
"OpenAI entregó a Microsoft todo el conjunto de datos de entrenamiento de GPT-3, que Microsoft utilizó para evaluar cómo implementar los modelos de OpenAI dentro de sus propios productos comerciales", afirma el escrito. "Microsoft proporcionó datos de entrenamiento a OpenAI de manera similar a través de iniciativas llamadas Proyecto Taxi y Proyecto Mango".
Las compañías supuestamente ensamblaron los datos del Proyecto Mango en un conjunto de datos de entrenamiento que contenía copias de al menos 160.903 obras únicas de editores de noticias.
Para maximizar la eficacia de su raspado, los empleados de OpenAI supuestamente idearon un plan para eludir los muros de pago sin ser detectados. Los escritos muestran que cuando el investigador de OpenAI Nick Ryder informó a Brockman sobre un "hack para eludir el muro de pago del NYT", Brockman respondió: "ah, genial".
Los empleados de OpenAI también supuestamente construyeron conjuntos de datos de entrenamiento como WebText y WebText2 que dependían desproporcionadamente del contenido de noticias raspado. También supuestamente extrajeron millones de artículos de Common Crawl, un repositorio abierto y gratuito de datos de rastreo web. Los hallazgos también describen esfuerzos deliberados para eliminar los avisos de derechos de autor de los datos de entrenamiento antes de que llegaran al modelo, ya que los investigadores "no querrían que el modelo emitiera" "avisos de derechos de autor" a los usuarios.
OpenAI y Microsoft no respondieron a las solicitudes de comentarios.
Artículo relacionado
 GPT-6 de OpenAI reduce a la mitad los costes de los tokens en todas las pruebas comparativas, mientras Sol y Luna se suman a la iniciativa
Según Artificial Analysis, GPT-6 Sol (max) se sitúa como el mejor modelo en cuanto a inteligencia, con un precio de 48 dólares. Crédito de la imagen: Getty ImagesTras el lanzamiento de GPT-6 Sol y Lun
El cementerio de la IA: una lista actualizada de proyectos y startups que no han tenido éxito
Relay, una plataforma de automatización de flujos de trabajo basada en IA que se posicionaba como alternativa a Zapier, cesó sus operaciones el lunes. El servicio permitía a los usuarios automatizar f
OpenAI apuesta por las familias mientras ChatGPT se adentra más en los hogares
Más de tres años después de que ChatGPT llevara la inteligencia artificial generativa al centro de atención, OpenAI está ampliando su alcance desde usuarios individuales hasta hogares completos.OpenAI está reclutando a un gerente de producto en San F
Recomendaciones de temas especiales relacionados
Inmediato
 Herramientas de gestión de prompts de IA para equipos
2026 Últimas Mejores Herramientas de Gestión de Prompts de IA Mejor Valoradas para Equipos están seleccionadas por XIX.AI aquí. Esta guía actualizada semanalmente presenta soluciones poderosas que cambian las reglas del juego y aumentan significativamente la productividad del equipo mediante pruebas en el mundo real y clasificaciones detalladas. Obtén una comparación gratuita entre versiones gratuitas y de pago para ayudarte a elegir la herramienta perfecta. Explora ahora para desbloquear tu ventaja con IA.
 9 herramientas
 xix.ai
composicion musical
Herramientas de IA para generar ideas de letras en la composición musical
¡Las mejores herramientas de IA para generar ideas de letras en 2026, con las mejores valoraciones para la composición musical, ya están aquí, en XIX.AI! Esta selección incluye potentes opciones revolucionarias que han superado pruebas en el mundo real para ofrecer rápidamente conceptos de letras de alta calidad, lo que ayuda a los usuarios a potenciar su creatividad y optimizar su proceso de creación musical. Consigue también una comparativa general entre las versiones gratuitas y de pago. ¡Explora ahora mismo y descubre tu herramienta perfecta!
16 herramientas
xix.ai
Creación de cómics
Herramientas de Hoja de Personaje IA para la Construcción del Mundo de Cómics
¡Las mejores herramientas de hojas de personajes de IA más recientes y mejor valoradas de 2026 para la creación de mundos de cómics están aquí en XIX.AI! Esta lista seleccionada incluye opciones poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real. Encontrarás una comparación entre versiones gratuitas y de pago, junto con clasificaciones actualizadas semanalmente para ayudarte a descubrir las herramientas imprescindibles que potencian tu creatividad y agilizan las tareas de creación de mundos. Explora ahora para desbloquear tu ventaja con IA.
13 herramientas
xix.ai
automatización
Herramientas de automatización con IA de n8n para operaciones internas, sincronización de datos y flujos de agentes de varios pasos
¡Ya están aquí las mejores herramientas de automatización con IA de n8n de 2026 para operaciones internas, sincronización de datos y flujos de agentes de varios pasos! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que aumentan la productividad en todas las tareas laborales. Cada entrada se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad, con una comparación detallada entre las versiones gratuitas y de pago, así como clasificaciones que se actualizan semanalmente. Estas opciones imprescindibles te ayudarán a sacar el máximo partido a la IA y a optimizar los flujos de trabajo sin esfuerzo. ¡Explora ahora mismo y descubre tu herramienta perfecta!
11 herramientas
xix.ai
Inmediato
Las mejores herramientas de gestión de solicitudes para equipos multimodelo
¡Las mejores herramientas de gestión de prompts de 2026, mejor valoradas para equipos multimodelo! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder, con comparativas entre versiones gratuitas y de pago, pruebas en condiciones reales y clasificaciones detalladas. Estas soluciones mejor valoradas ayudan a aumentar significativamente la productividad al optimizar los flujos de trabajo, eliminar la repetición y potenciar la creatividad en todos los proyectos del equipo. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Asistente de reuniones
Herramientas de resumen de reuniones basadas en IA para equipos que trabajan a distancia
¡Las mejores herramientas de resumen de reuniones con IA mejor valoradas de 2026 para equipos remotos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder, sometidas a pruebas en el mundo real para ofrecer transcripciones precisas e información útil. Encontrarás comparativas entre opciones gratuitas y de pago, así como clasificaciones detalladas que te ayudarán a elegir la opción perfecta para aumentar la productividad y optimizar la comunicación del equipo. ¡Explora ahora y aprovecha toda la ventaja que te ofrece la IA!
13 herramientas
xix.ai

 comentario (0)
0/500
Los documentos desclasificados de la demanda por derechos de autor de tres años de antigüedad presentada por The New York Times contra OpenAI y Microsoft revelan una admisión de que el raspado de datos por parte de la inteligencia artificial constituye robo y representa una grave amenaza para los medios de comunicación.
Según la demanda, un alto directivo de Microsoft etiquetó privadamente los métodos de entrenamiento de inteligencia artificial de las compañías como "robo", mientras que el liderazgo de OpenAI reconoció que sus modelos crearon una "amenaza existencial" para los editores y periodistas cuyo contenido los entrenó.
Los registros recientemente desclasificados también detallan cómo las compañías supuestamente accedieron y utilizaron este contenido eludiendo los muros de pago sin ser detectadas, construyendo conjuntos de datos de entrenamiento mediante raspado masivo y eliminando intencionalmente los avisos de derechos de autor de los datos.
Es importante señalar que gran parte de esta nueva información proviene del propio escrito legal de The Times en lugar de los documentos adjuntos subyacentes, que permanecen sellados. Las citas a continuación se presentan sin su contexto original.
Este escrito sin censurar marca la última escalada en la demanda de tres años de antigüedad, donde The New York Times afirmó inicialmente que las empresas violaron la ley de derechos de autor al entrenar modelos de inteligencia artificial generativa con su contenido.
No hay una respuesta legal clara sobre si las empresas de inteligencia artificial pueden utilizar legalmente material con derechos de autor para el entrenamiento, aunque los jueces generalmente han favorecido el argumento de las compañías de inteligencia artificial de que dicho entrenamiento califica como "uso justo". Esta doctrina legal permite el uso de obras con derechos de autor sin permiso en instancias específicas, como parodias, reportajes de noticias o críticas. A principios de este mes, la administración Trump presentó un escrito apoyando el uso no licenciado por parte de OpenAI de material con derechos de autor para entrenar sus modelos de lenguaje grandes.
Sin embargo, varias de estas nuevas admisiones contradicen la defensa de uso justo de OpenAI, particularmente el requisito de que dicho uso no sustituya ni dañe el mercado de la obra original.
Por ejemplo, los propios datos de Microsoft indican que su "motor de respuestas" Copilot provocó que las tasas de clics para el dominio de The New York Times cayeran hasta un 93 % en comparación con las búsquedas tradicionales de Bing. Una presentación interna de Microsoft escrita por Brent Hecht, Director de Ciencia Aplicada de Microsoft, en enero de 2024, describe este declive como un "ciclo de la muerte" que dañaría simultáneamente "el rendimiento de nuestros modelos y de toda la web".
"Es muy inusual que un producto final amenace las bases económicas de sus proveedores esenciales, pero esa es la situación que hemos creado para nuestro negocio de modelos de lenguaje grandes con respecto a su 'cadena de suministro de contenido'", afirma el documento de Microsoft, según se cita en el escrito.
El director ejecutivo de Microsoft, Satya Nadella, también declaró en una declaración jurada a principios de este año que "cualquier contenido con muro de pago debería ser licenciado por cualquiera que desee utilizarlo... para fundamentar o entrenar", y aclaró que si hubiera "sido informado de que OpenAI había raspado y entrenado con información detrás de un muro de pago", habría "invocado [el derecho de Microsoft a] exigir que OpenAI vuelva a entrenar sus modelos".
Otras admisiones socavan diferentes aspectos de la prueba de uso justo: el jefe de ChatGPT de OpenAI, Nick Turley, escribió en comunicaciones internas que los editores enfrentan una "amenaza existencial" de productos como el chatbot, que son "largamente sustitutivos" y "se volverán cada vez más sustitutivos a medida que mejoren".
El presidente de OpenAI, Greg Brockman, describió los modelos como "excelentes para las noticias". Nadella estuvo de acuerdo bajo juramento a principios de este año que interactuar con chatbots "ha sustituido ... dándote la información directamente en el sitio web de la plataforma de inteligencia artificial en lugar de necesitar ir a la fuente subyacente".
Este tipo de lenguaje destaca cómo la tecnología podría competir directamente con, en lugar de transformar, la obra original.
Un documento de Microsoft afirma que existe un "riesgo real" de que la inteligencia artificial generativa pueda "perturbar significativamente el empleo de las mismas personas que generaron los datos en los que se entrenó el modelo base".
La escala masiva del copiado es impactante. Los documentos revelan por primera vez que los conjuntos de datos de entrenamiento intermedio de OpenAI contienen más de 91.692 copias de obras publicadas por el NYT, Daily News y Center for Investigative Reporting. Un conjunto de datos derivado de Common Crawl incluía más de 2 millones de documentos solo de nytimes.com.
En un memorando interno de enero de 2023, Hecht lo calificó como "un robo asombroso de proporciones sin precedentes" y "el mayor robo de trabajo en la historia de la humanidad".
El escrito proporciona nuevos detalles sobre cómo OpenAI y Microsoft adquirieron el contenido de los demandantes, incluido el raspado del Índice de Bing.
"OpenAI entregó a Microsoft todo el conjunto de datos de entrenamiento de GPT-3, que Microsoft utilizó para evaluar cómo implementar los modelos de OpenAI dentro de sus propios productos comerciales", afirma el escrito. "Microsoft proporcionó datos de entrenamiento a OpenAI de manera similar a través de iniciativas llamadas Proyecto Taxi y Proyecto Mango".
Las compañías supuestamente ensamblaron los datos del Proyecto Mango en un conjunto de datos de entrenamiento que contenía copias de al menos 160.903 obras únicas de editores de noticias.
Para maximizar la eficacia de su raspado, los empleados de OpenAI supuestamente idearon un plan para eludir los muros de pago sin ser detectados. Los escritos muestran que cuando el investigador de OpenAI Nick Ryder informó a Brockman sobre un "hack para eludir el muro de pago del NYT", Brockman respondió: "ah, genial".
Los empleados de OpenAI también supuestamente construyeron conjuntos de datos de entrenamiento como WebText y WebText2 que dependían desproporcionadamente del contenido de noticias raspado. También supuestamente extrajeron millones de artículos de Common Crawl, un repositorio abierto y gratuito de datos de rastreo web. Los hallazgos también describen esfuerzos deliberados para eliminar los avisos de derechos de autor de los datos de entrenamiento antes de que llegaran al modelo, ya que los investigadores "no querrían que el modelo emitiera" "avisos de derechos de autor" a los usuarios.
OpenAI y Microsoft no respondieron a las solicitudes de comentarios.








 GPT-6 de OpenAI reduce a la mitad los costes de los tokens en todas las pruebas comparativas, mientras Sol y Luna se suman a la iniciativa
Según Artificial Analysis, GPT-6 Sol (max) se sitúa como el mejor modelo en cuanto a inteligencia, con un precio de 48 dólares. Crédito de la imagen: Getty ImagesTras el lanzamiento de GPT-6 Sol y Lun
 El cementerio de la IA: una lista actualizada de proyectos y startups que no han tenido éxito
Relay, una plataforma de automatización de flujos de trabajo basada en IA que se posicionaba como alternativa a Zapier, cesó sus operaciones el lunes. El servicio permitía a los usuarios automatizar f
 OpenAI apuesta por las familias mientras ChatGPT se adentra más en los hogares
Más de tres años después de que ChatGPT llevara la inteligencia artificial generativa al centro de atención, OpenAI está ampliando su alcance desde usuarios individuales hasta hogares completos.OpenAI está reclutando a un gerente de producto en San F

2026 Últimas Mejores Herramientas de Gestión de Prompts de IA Mejor Valoradas para Equipos están seleccionadas por XIX.AI aquí. Esta guía actualizada semanalmente presenta soluciones poderosas que cambian las reglas del juego y aumentan significativamente la productividad del equipo mediante pruebas en el mundo real y clasificaciones detalladas. Obtén una comparación gratuita entre versiones gratuitas y de pago para ayudarte a elegir la herramienta perfecta. Explora ahora para desbloquear tu ventaja con IA.
9 herramientas
xix.ai

¡Las mejores herramientas de IA para generar ideas de letras en 2026, con las mejores valoraciones para la composición musical, ya están aquí, en XIX.AI! Esta selección incluye potentes opciones revolucionarias que han superado pruebas en el mundo real para ofrecer rápidamente conceptos de letras de alta calidad, lo que ayuda a los usuarios a potenciar su creatividad y optimizar su proceso de creación musical. Consigue también una comparativa general entre las versiones gratuitas y de pago. ¡Explora ahora mismo y descubre tu herramienta perfecta!
16 herramientas
xix.ai
¡Las mejores herramientas de hojas de personajes de IA más recientes y mejor valoradas de 2026 para la creación de mundos de cómics están aquí en XIX.AI! Esta lista seleccionada incluye opciones poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real. Encontrarás una comparación entre versiones gratuitas y de pago, junto con clasificaciones actualizadas semanalmente para ayudarte a descubrir las herramientas imprescindibles que potencian tu creatividad y agilizan las tareas de creación de mundos. Explora ahora para desbloquear tu ventaja con IA.
13 herramientas
xix.ai
¡Ya están aquí las mejores herramientas de automatización con IA de n8n de 2026 para operaciones internas, sincronización de datos y flujos de agentes de varios pasos! XIX.AI ha elaborado una lista con las herramientas mejor valoradas, potentes y revolucionarias que aumentan la productividad en todas las tareas laborales. Cada entrada se somete a rigurosas pruebas en condiciones reales para garantizar su fiabilidad, con una comparación detallada entre las versiones gratuitas y de pago, así como clasificaciones que se actualizan semanalmente. Estas opciones imprescindibles te ayudarán a sacar el máximo partido a la IA y a optimizar los flujos de trabajo sin esfuerzo. ¡Explora ahora mismo y descubre tu herramienta perfecta!
11 herramientas
xix.ai
¡Las mejores herramientas de gestión de prompts de 2026, mejor valoradas para equipos multimodelo! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder, con comparativas entre versiones gratuitas y de pago, pruebas en condiciones reales y clasificaciones detalladas. Estas soluciones mejor valoradas ayudan a aumentar significativamente la productividad al optimizar los flujos de trabajo, eliminar la repetición y potenciar la creatividad en todos los proyectos del equipo. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
¡Las mejores herramientas de resumen de reuniones con IA mejor valoradas de 2026 para equipos remotos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder, sometidas a pruebas en el mundo real para ofrecer transcripciones precisas e información útil. Encontrarás comparativas entre opciones gratuitas y de pago, así como clasificaciones detalladas que te ayudarán a elegir la opción perfecta para aumentar la productividad y optimizar la comunicación del equipo. ¡Explora ahora y aprovecha toda la ventaja que te ofrece la IA!
13 herramientas
xix.ai












