


 Дом
Новая модель маршрутизатора стоимостью 1,5 млрд долларов достигает точности 93%, исключая дорогостоящие затраты на переобучение
Исследователи из Katanemo Labs представили Arch-Router, продвинутую модель маршрутизации и фреймворк, разработанный для интеллектуального направления пользовательских запросов к наиболее подходящей большой языковой модели (LLM).
Для компаний, разрабатывающих продукты, использующие несколько LLM, Arch-Rolver решает главную дилемму: как автоматически направить каждый запрос к идеальной модели для данной задачи, не прибегая к негибкой логике или дорогостоящему переобучению при необходимости обновления.
Проблемы маршрутизации LLM
По мере расширения разнообразия доступных LLM разработчики переходят от конфигураций с одной моделью к многомодельным архитектурам, использующим различные возможности разных моделей для выполнения специализированных функций - например, генерации кода, обобщения текста или редактирования изображений.
LLM-маршрутизация стала важным методом построения и работы таких систем, выступая в роли интеллектуального директора трафика, который направляет каждый запрос пользователя к модели, наиболее подходящей для его обработки.
Существующие подходы к маршрутизации обычно делятся на две основные группы: маршрутизация на основе задач, которая распределяет запросы в соответствии с заранее определенными категориями задач, и маршрутизация на основе производительности, которая ищет наилучший компромисс между затратами и качеством результата.
Однако системы, основанные на задачах, часто дают сбой, когда намерения пользователя неоднозначны или меняются по ходу разговора - особенно в многооборотных диалогах. Маршрутизация на основе производительности, в свою очередь, склонна отдавать предпочтение статичным результатам, часто игнорируя реальные предпочтения пользователей и медленно адаптируясь к новым моделям без дорогостоящего переобучения.
Как отмечают исследователи из Katanemo Labs в своей статье, более глубокая проблема заключается в том, что "существующие методы маршрутизации имеют практические ограничения в реальных приложениях. Большинство из них оптимизированы под эталонную производительность, но не учитывают предпочтения людей, которые руководствуются субъективными критериями оценки".
Команда подчеркивает важность систем маршрутизации, которые "отражают субъективные человеческие суждения, обеспечивают большую прозрачность и легко настраиваются по мере развития моделей и приложений".
Новая схема маршрутизации с учетом предпочтений
Чтобы преодолеть эти проблемы, исследователи разработали систему "маршрутизации с учетом предпочтений", которая сопоставляет входящие запросы с правилами маршрутизации, основанными на пользовательских предпочтениях.
В этой системе пользователи определяют свои политики маршрутизации с помощью естественного языка, используя двухуровневую "Таксономию доменов и действий". Эта структура отражает то, как люди естественным образом описывают задачи: начиная с широкой категории - домена, например "юриспруденция" или "финансы", - и заканчивая конкретной задачей - действием, например "обобщение" или "кодирование".
Затем каждая политика сопоставляется с предпочтительной моделью, что позволяет разработчикам основывать выбор маршрутизации на практических требованиях, а не только на эталонных показателях. Согласно статье, "эта таксономия действует как ментальная модель, помогающая пользователям создавать четко определенные, структурированные политики маршрутизации".
Процедура маршрутизации состоит из двух этапов. Во-первых, модель маршрутизатора, ориентированная на предпочтения, оценивает запрос пользователя в сравнении со всеми доступными политиками и выбирает наиболее подходящую. Во-вторых, функция отображения связывает выбранную политику с назначенным ей LLM.
Поскольку логика выбора модели отделена от определения политики, разработчики могут добавлять, удалять или обновлять модели, просто редактируя правила маршрутизации, без переобучения или изменения маршрутизатора. Такое разделение обеспечивает необходимую гибкость для производственных сред, где модели и приложения постоянно меняются.
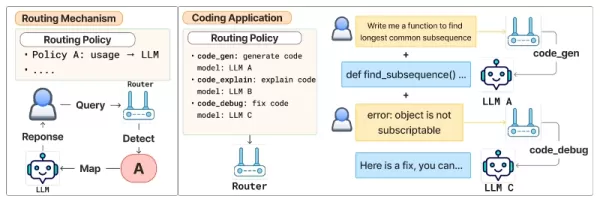
Система маршрутизации, ориентированная на предпочтения Источник: arXiv Выбор политики осуществляется с помощью Arch-Router, компактной языковой модели с 1,5 миллиардами параметров, оптимизированной для маршрутизации с учетом предпочтений. Arch-Router принимает на вход запрос пользователя и полный список описаний политик, а затем выдает идентификатор наиболее подходящей политики.
Поскольку политики включены в исходные данные, система может адаптироваться к новым или обновленным маршрутам в процессе вывода благодаря контекстному обучению - переобучение не требуется. Эта генеративная стратегия позволяет Arch-Router использовать свое предварительно обученное понимание для интерпретации смысла запроса и политик, а также анализировать всю историю разговоров за один раз.
Одним из распространенных опасений, связанных с включением длинных списков политик в запрос, является риск увеличения задержки. Однако команда создала Arch-Router с расчетом на высокую эффективность. "Даже при использовании обширных политик маршрутизации мы можем расширить контекстное окно Arch-Router с очень небольшим влиянием на задержку", - говорит Салман Парача, соавтор статьи и основатель/генеральный директор Katanemo Labs. Он отмечает, что задержка в основном определяется длиной вывода, а Arch-Router выводит только короткое имя политики - например, "image_editing" или "document_creation".
Arch-Router в действии
Чтобы создать Arch-Router, команда доработала вариант модели Qwen 2.5 с 1,5 млрд параметров, используя тщательно собранный набор данных из 43 000 примеров. Затем они сравнили ее с ведущими собственными моделями от OpenAI, Anthropic и Google на четырех публичных наборах данных, предназначенных для тестирования систем разговорного ИИ.
Результаты показали, что Arch-Router достигла наивысшей общей оценки маршрутизации 93,17 %, опередив все остальные модели, включая собственные модели высшего уровня, в среднем на 7,71 %. Преимущество модели стало более очевидным при длительных разговорах, продемонстрировав ее превосходную способность сохранять контекст при многократных обменах.
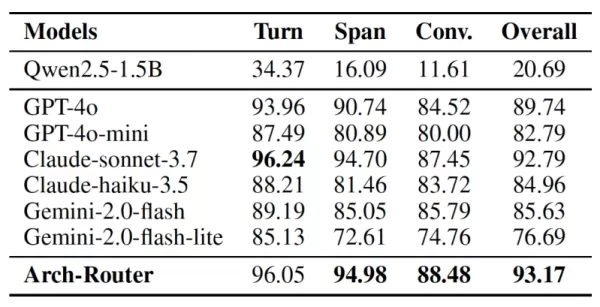
Arch-Router в сравнении с другими моделями Источник: arXiv В реальном мире эта методология уже применяется во многих ситуациях, отмечает Парача. Например, в платформах для кодирования с открытым исходным кодом разработчики полагаются на Arch-Router, чтобы направлять различные части своего рабочего процесса - "проектирование кода", "понимание кода" и "генерация кода" - к LLM, наиболее эффективным для каждого этапа. Аналогичным образом, организации могут направлять задачи по созданию документов в такую модель, как Claude 3.7 Sonnet, а запросы на редактирование изображений - в Gemini 2.5 Pro.
Система также хорошо подходит "для персональных помощников в различных областях, где пользователи выполняют целый ряд действий - от резюмирования текста до ответов на фактические запросы", - пояснил Парача, добавив, что "в таких ситуациях Arch-Router помогает командам разработчиков консолидировать и улучшать общий опыт пользователя".
Этот фреймворк встроен в Arch, ИИ-нативный прокси-сервер Katanemo Labs для агентов, который поддерживает реализацию гранулированных правил управления трафиком. Например, при добавлении нового LLM команда может перенаправить небольшой процент трафика по определенной политике на новую модель, проверить ее производительность с помощью внутренней аналитики, а затем уверенно переключить весь трафик. Компания также работает над интеграцией своих инструментов с платформами оценки, чтобы сделать этот рабочий процесс еще более удобным для корпоративных разработчиков.
По сути, цель состоит в том, чтобы помочь организациям выйти за рамки разрозненных внедрений ИИ. "Arch-Router и платформа Arch в целом позволяют разработчикам и компаниям перейти от фрагментарного использования LLM к единой, управляемой политиками системе", - говорит Парача. "Когда пользователи выполняют широкий спектр задач, наша платформа преобразует это разнообразие задач и моделей в целостный опыт, делая конечный продукт бесшовным и интуитивно понятным".
Связанная статья
 OpenAI запускает более безопасную версию ChatGPT для подростков спустя несколько лет после того, как они начали ею пользоваться
После серии судебных исков, связанных с отсутствием протоколов безопасности в чат-ботах на базе ИИ — что стало одной из причин самоубийств подростков и других кризисов, связанных с психическим здоровь
Google запускает функцию обнаружения поддельных звонков для защиты от мошенничества с использованием ИИ-дипфейков, имитирующих личность
Во вторник компания Google объявила о запуске в Android функции обнаружения поддельных звонков, призванной защитить пользователей от мошенничества с использованием технологии «дипфейк» на базе искусст
Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи
Рекомендации по связанным специальным темам
письмо
 Инструменты для создания плана статей с использованием ИИ при написании длинных текстов
2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
 9 инструментов
 xix.ai
чат-бот
Лучшие приложения для ролевых чатов с ИИ для практики языка, подготовки к собеседованиям и ежедневной разговорной практики
2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai
Музыкальная композиция
Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

 Комментарии (1)
![WillGarcía]()
Arch-Routerの構想は面白いね。社内でどのLLMを使うか毎回悩んでたから、これがあれば効率化に繋がりそう。ただ、精度93%って、結局残りの7%で重大なミスルーティングが起きたりしない? 医療や法務のようなクリティカルな分野への適用は少し不安かな。😅 開発元のKatanemo Labs、これでインフラ市場に本格参戦するつもり?
Исследователи из Katanemo Labs представили Arch-Router, продвинутую модель маршрутизации и фреймворк, разработанный для интеллектуального направления пользовательских запросов к наиболее подходящей большой языковой модели (LLM).
Для компаний, разрабатывающих продукты, использующие несколько LLM, Arch-Rolver решает главную дилемму: как автоматически направить каждый запрос к идеальной модели для данной задачи, не прибегая к негибкой логике или дорогостоящему переобучению при необходимости обновления.
Проблемы маршрутизации LLM
По мере расширения разнообразия доступных LLM разработчики переходят от конфигураций с одной моделью к многомодельным архитектурам, использующим различные возможности разных моделей для выполнения специализированных функций - например, генерации кода, обобщения текста или редактирования изображений.
LLM-маршрутизация стала важным методом построения и работы таких систем, выступая в роли интеллектуального директора трафика, который направляет каждый запрос пользователя к модели, наиболее подходящей для его обработки.
Существующие подходы к маршрутизации обычно делятся на две основные группы: маршрутизация на основе задач, которая распределяет запросы в соответствии с заранее определенными категориями задач, и маршрутизация на основе производительности, которая ищет наилучший компромисс между затратами и качеством результата.
Однако системы, основанные на задачах, часто дают сбой, когда намерения пользователя неоднозначны или меняются по ходу разговора - особенно в многооборотных диалогах. Маршрутизация на основе производительности, в свою очередь, склонна отдавать предпочтение статичным результатам, часто игнорируя реальные предпочтения пользователей и медленно адаптируясь к новым моделям без дорогостоящего переобучения.
Как отмечают исследователи из Katanemo Labs в своей статье, более глубокая проблема заключается в том, что "существующие методы маршрутизации имеют практические ограничения в реальных приложениях. Большинство из них оптимизированы под эталонную производительность, но не учитывают предпочтения людей, которые руководствуются субъективными критериями оценки".
Команда подчеркивает важность систем маршрутизации, которые "отражают субъективные человеческие суждения, обеспечивают большую прозрачность и легко настраиваются по мере развития моделей и приложений".
Новая схема маршрутизации с учетом предпочтений
Чтобы преодолеть эти проблемы, исследователи разработали систему "маршрутизации с учетом предпочтений", которая сопоставляет входящие запросы с правилами маршрутизации, основанными на пользовательских предпочтениях.
В этой системе пользователи определяют свои политики маршрутизации с помощью естественного языка, используя двухуровневую "Таксономию доменов и действий". Эта структура отражает то, как люди естественным образом описывают задачи: начиная с широкой категории - домена, например "юриспруденция" или "финансы", - и заканчивая конкретной задачей - действием, например "обобщение" или "кодирование".
Затем каждая политика сопоставляется с предпочтительной моделью, что позволяет разработчикам основывать выбор маршрутизации на практических требованиях, а не только на эталонных показателях. Согласно статье, "эта таксономия действует как ментальная модель, помогающая пользователям создавать четко определенные, структурированные политики маршрутизации".
Процедура маршрутизации состоит из двух этапов. Во-первых, модель маршрутизатора, ориентированная на предпочтения, оценивает запрос пользователя в сравнении со всеми доступными политиками и выбирает наиболее подходящую. Во-вторых, функция отображения связывает выбранную политику с назначенным ей LLM.
Поскольку логика выбора модели отделена от определения политики, разработчики могут добавлять, удалять или обновлять модели, просто редактируя правила маршрутизации, без переобучения или изменения маршрутизатора. Такое разделение обеспечивает необходимую гибкость для производственных сред, где модели и приложения постоянно меняются.
Выбор политики осуществляется с помощью Arch-Router, компактной языковой модели с 1,5 миллиардами параметров, оптимизированной для маршрутизации с учетом предпочтений. Arch-Router принимает на вход запрос пользователя и полный список описаний политик, а затем выдает идентификатор наиболее подходящей политики.
Поскольку политики включены в исходные данные, система может адаптироваться к новым или обновленным маршрутам в процессе вывода благодаря контекстному обучению - переобучение не требуется. Эта генеративная стратегия позволяет Arch-Router использовать свое предварительно обученное понимание для интерпретации смысла запроса и политик, а также анализировать всю историю разговоров за один раз.
Одним из распространенных опасений, связанных с включением длинных списков политик в запрос, является риск увеличения задержки. Однако команда создала Arch-Router с расчетом на высокую эффективность. "Даже при использовании обширных политик маршрутизации мы можем расширить контекстное окно Arch-Router с очень небольшим влиянием на задержку", - говорит Салман Парача, соавтор статьи и основатель/генеральный директор Katanemo Labs. Он отмечает, что задержка в основном определяется длиной вывода, а Arch-Router выводит только короткое имя политики - например, "image_editing" или "document_creation".
Arch-Router в действии
Чтобы создать Arch-Router, команда доработала вариант модели Qwen 2.5 с 1,5 млрд параметров, используя тщательно собранный набор данных из 43 000 примеров. Затем они сравнили ее с ведущими собственными моделями от OpenAI, Anthropic и Google на четырех публичных наборах данных, предназначенных для тестирования систем разговорного ИИ.
Результаты показали, что Arch-Router достигла наивысшей общей оценки маршрутизации 93,17 %, опередив все остальные модели, включая собственные модели высшего уровня, в среднем на 7,71 %. Преимущество модели стало более очевидным при длительных разговорах, продемонстрировав ее превосходную способность сохранять контекст при многократных обменах.
В реальном мире эта методология уже применяется во многих ситуациях, отмечает Парача. Например, в платформах для кодирования с открытым исходным кодом разработчики полагаются на Arch-Router, чтобы направлять различные части своего рабочего процесса - "проектирование кода", "понимание кода" и "генерация кода" - к LLM, наиболее эффективным для каждого этапа. Аналогичным образом, организации могут направлять задачи по созданию документов в такую модель, как Claude 3.7 Sonnet, а запросы на редактирование изображений - в Gemini 2.5 Pro.
Система также хорошо подходит "для персональных помощников в различных областях, где пользователи выполняют целый ряд действий - от резюмирования текста до ответов на фактические запросы", - пояснил Парача, добавив, что "в таких ситуациях Arch-Router помогает командам разработчиков консолидировать и улучшать общий опыт пользователя".
Этот фреймворк встроен в Arch, ИИ-нативный прокси-сервер Katanemo Labs для агентов, который поддерживает реализацию гранулированных правил управления трафиком. Например, при добавлении нового LLM команда может перенаправить небольшой процент трафика по определенной политике на новую модель, проверить ее производительность с помощью внутренней аналитики, а затем уверенно переключить весь трафик. Компания также работает над интеграцией своих инструментов с платформами оценки, чтобы сделать этот рабочий процесс еще более удобным для корпоративных разработчиков.
По сути, цель состоит в том, чтобы помочь организациям выйти за рамки разрозненных внедрений ИИ. "Arch-Router и платформа Arch в целом позволяют разработчикам и компаниям перейти от фрагментарного использования LLM к единой, управляемой политиками системе", - говорит Парача. "Когда пользователи выполняют широкий спектр задач, наша платформа преобразует это разнообразие задач и моделей в целостный опыт, делая конечный продукт бесшовным и интуитивно понятным".








 OpenAI запускает более безопасную версию ChatGPT для подростков спустя несколько лет после того, как они начали ею пользоваться
После серии судебных исков, связанных с отсутствием протоколов безопасности в чат-ботах на базе ИИ — что стало одной из причин самоубийств подростков и других кризисов, связанных с психическим здоровь
 Google запускает функцию обнаружения поддельных звонков для защиты от мошенничества с использованием ИИ-дипфейков, имитирующих личность
Во вторник компания Google объявила о запуске в Android функции обнаружения поддельных звонков, призванной защитить пользователей от мошенничества с использованием технологии «дипфейк» на базе искусст
 Frontier AI Labs отказывается раскрывать стратегии локализации неконтролируемых моделей
Последние исследования показывают, что лишь немногие ведущие лаборатории, занимающиеся ИИ, опубликовали или продемонстрировали планы реагирования на попытки выхода системы из-под контроля. План сдержи

2026: лучшие и самые популярные инструменты для создания планов статей с помощью ИИ для написания длинных текстов! В эту тщательно подобранную подборку вошли мощные, революционные инструменты, которые генерируют точные и структурированные планы, прошедшие проверку на практике, что позволяет значительно повысить эффективность написания текстов. XIX.AI входит в эту элитную подборку. Получите сравнение бесплатных и платных версий, чтобы выбрать идеальный инструмент. Изучите их прямо сейчас и раскройте свой потенциал с помощью ИИ!
9 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее рейтинговые приложения для ИИ-ролевых чатов, предназначенные для практики языка, подготовки к собеседованиям и ежедневной беглости речи! XIX.AI предлагает мощную коллекцию, меняющую правила игры: бесплатные и платные варианты, реальные тесты и обновляемые еженедельно рейтинги. Эти обязательные к использованию инструменты помогут вам улучшить навыки письма, преодолеть трудности с беглостью и повысить эффективность общения во всех повседневных ситуациях. Исследуйте сейчас, чтобы найти идеальный инструмент для развития вашего языка!
10 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

Arch-Routerの構想は面白いね。社内でどのLLMを使うか毎回悩んでたから、これがあれば効率化に繋がりそう。ただ、精度93%って、結局残りの7%で重大なミスルーティングが起きたりしない? 医療や法務のようなクリティカルな分野への適用は少し不安かな。😅 開発元のKatanemo Labs、これでインフラ市場に本格参戦するつもり?












