


 Lar
A NVIDIA torna o Polar Framework de código aberto para a evolução de agentes de IA sem barreiras por meio do aprendizado por reforço
Em 28 de maio, a equipe de pesquisa da NVIDIA tornou o Polar, uma estrutura de treinamento de aprendizagem por reforço, de código aberto. Sua principal inovação reside na integração perfeita de agentes de código convencionais já existentes — como Codex, Claude Code e Qwen Code — ao treinamento de aprendizagem por reforço GRPO (Otimização Generalizada de Políticas Relativas), sem exigir nenhuma alteração no código original.
I. Desafios do setor: a barreira para o aprendizado por reforço de agentes
À medida que os agentes de código evoluem de tarefas simples de uma única etapa para processos complexos e de longa duração — como modificações de código em nível de repositório ou interações com o sistema operacional —, os desenvolvedores dependem cada vez mais de estruturas de execução maduras (Harness). No entanto, integrar essas estruturas complexas à infraestrutura tradicional de aprendizado por reforço apresenta desafios significativos:
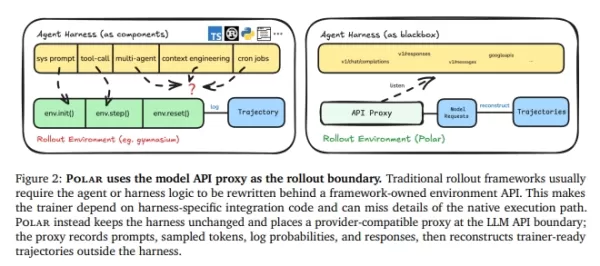
Alto custo de integração: os métodos tradicionais exigem a reescrita da lógica do código em interfaces de ambiente padrão, como env.init() e env.step(), um processo extremamente tedioso.
Perda de informações: durante a refatoração, detalhes críticos — como chamadas de ferramentas, contexto de diálogo de múltiplas rodadas ou lógica de colaboração entre subagentes — são frequentemente perdidos, impedindo que o modelo receba sinais de treinamento de alta qualidade.
II. Solução principal: usar o “limite” como ponto de entrada do treinamento
O Polar elimina a necessidade de reescrever a estrutura de execução. Em vez disso, ele trata o limite da API do modelo como o ponto de entrada do treinamento.
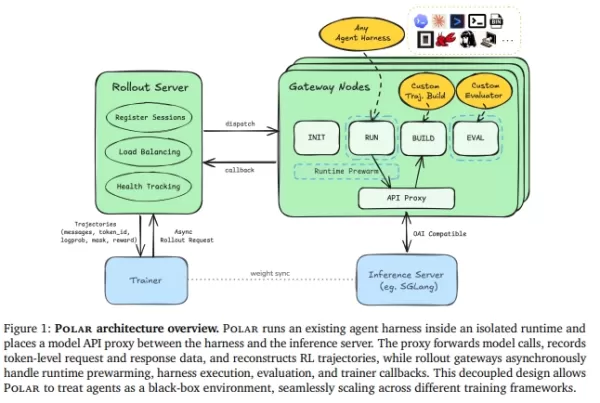
Processamento de caixa preta: O Polar coloca um proxy transparente (Gateway) entre a estrutura de execução de código e o servidor de inferência do modelo. Independentemente de o agente usar APIs da Anthropic, OpenAI ou Google, o Polar intercepta e encaminha as solicitações de forma integrada.
Reconstrução de rastreamento: durante o encaminhamento, o Polar registra dados-chave em tempo real — como prompts, tokens amostrados e probabilidades de log — e os reconstrói nos dados de “rastreamento” necessários ao treinador de aprendizado por reforço.
Arquitetura assíncrona eficiente: O sistema emprega um servidor de rollout para agendamento e persistência, enquanto os nós de gateway gerenciam o ciclo de vida e a reciclagem de recursos. Ao aproveitar um buffer pré-aquecido (buffer READY) e o processamento paralelo de tarefas, ele elimina efetivamente tarefas de cauda longa que poderiam bloquear o treinamento da GPU.
III. Salto de desempenho: transformando agentes de código
Dados experimentais mostram que o Polar, quando combinado com o treinamento GRPO, produz ganhos significativos de desempenho:
Teste de benchmark verificado pelo SWE-Bench: Usando o mesmo modelo base Qwen3.5-4B, o desempenho varia entre diferentes estruturas de código:
Estrutura Codex: a pontuação pass@1 salta de 3,8% para 26,4% — um aumento de 594,74%.
Estrutura de código Claude: de 29,8% para 34,6%.
Estrutura Pi: de 34,2% para 40,4%.
Eficiência extrema: Após a introdução da estratégia prefix_merging, o tempo de treinamento em tempo real é reduzido em cerca de 5,39 vezes em comparação com o modo tradicional por solicitação, e a utilização da GPU aumenta de 20,4% para 87,7%.
Comentário do setor
A abertura do código-fonte do Polar da NVIDIA basicamente constrói uma “rodovia” para que agentes de IA entrem no treinamento de aprendizado por reforço. Isso não apenas permite que pesquisadores treinem com eficiência usando enormes frameworks de código-fonte aberto, mas também reduz a barreira da computação em GPU por meio da otimização em nível de sistema.
Com a crescente popularidade do Polar, os desenvolvedores não precisam mais se preocupar com “como adaptar modelos às estruturas de treinamento”. No futuro, a evolução dos agentes de codificação de IA se tornará mais padronizada e eficiente. Isso marca uma mudança no treinamento de agentes de IA, passando do ajuste manual em laboratório para uma produção de engenharia sistemática em grande escala.
URL do artigo: https://arxiv.org/pdf/2605.24220
Artigo relacionado
 O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen
A corrida pela IA não vai esperar, nem esse desconto de 25% do TechCrunch Disrupt
Todo fundador que está trabalhando com IA neste momento faz a mesma pergunta: será que estamos avançando rápido o suficiente e de forma eficaz o suficiente? O TechCrunch Disrupt 2026 coloca você na me
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (1)
![AlbertWalker]()
So NVIDIA just dropped Polar as open source? That's huge for AI coding agents - integrating Codex and Claude with reinforcement learning sounds like a game changer. But I wonder how much compute you'd need to actually train it effectively... 🤔
Em 28 de maio, a equipe de pesquisa da NVIDIA tornou o Polar, uma estrutura de treinamento de aprendizagem por reforço, de código aberto. Sua principal inovação reside na integração perfeita de agentes de código convencionais já existentes — como Codex, Claude Code e Qwen Code — ao treinamento de aprendizagem por reforço GRPO (Otimização Generalizada de Políticas Relativas), sem exigir nenhuma alteração no código original.
I. Desafios do setor: a barreira para o aprendizado por reforço de agentes
À medida que os agentes de código evoluem de tarefas simples de uma única etapa para processos complexos e de longa duração — como modificações de código em nível de repositório ou interações com o sistema operacional —, os desenvolvedores dependem cada vez mais de estruturas de execução maduras (Harness). No entanto, integrar essas estruturas complexas à infraestrutura tradicional de aprendizado por reforço apresenta desafios significativos:
Alto custo de integração: os métodos tradicionais exigem a reescrita da lógica do código em interfaces de ambiente padrão, como env.init() e env.step(), um processo extremamente tedioso.
Perda de informações: durante a refatoração, detalhes críticos — como chamadas de ferramentas, contexto de diálogo de múltiplas rodadas ou lógica de colaboração entre subagentes — são frequentemente perdidos, impedindo que o modelo receba sinais de treinamento de alta qualidade.
II. Solução principal: usar o “limite” como ponto de entrada do treinamento
O Polar elimina a necessidade de reescrever a estrutura de execução. Em vez disso, ele trata o limite da API do modelo como o ponto de entrada do treinamento.
Processamento de caixa preta: O Polar coloca um proxy transparente (Gateway) entre a estrutura de execução de código e o servidor de inferência do modelo. Independentemente de o agente usar APIs da Anthropic, OpenAI ou Google, o Polar intercepta e encaminha as solicitações de forma integrada.
Reconstrução de rastreamento: durante o encaminhamento, o Polar registra dados-chave em tempo real — como prompts, tokens amostrados e probabilidades de log — e os reconstrói nos dados de “rastreamento” necessários ao treinador de aprendizado por reforço.
Arquitetura assíncrona eficiente: O sistema emprega um servidor de rollout para agendamento e persistência, enquanto os nós de gateway gerenciam o ciclo de vida e a reciclagem de recursos. Ao aproveitar um buffer pré-aquecido (buffer READY) e o processamento paralelo de tarefas, ele elimina efetivamente tarefas de cauda longa que poderiam bloquear o treinamento da GPU.
III. Salto de desempenho: transformando agentes de código
Dados experimentais mostram que o Polar, quando combinado com o treinamento GRPO, produz ganhos significativos de desempenho:
Teste de benchmark verificado pelo SWE-Bench: Usando o mesmo modelo base Qwen3.5-4B, o desempenho varia entre diferentes estruturas de código:
Estrutura Codex: a pontuação pass@1 salta de 3,8% para 26,4% — um aumento de 594,74%.
Estrutura de código Claude: de 29,8% para 34,6%.
Estrutura Pi: de 34,2% para 40,4%.
Eficiência extrema: Após a introdução da estratégia prefix_merging, o tempo de treinamento em tempo real é reduzido em cerca de 5,39 vezes em comparação com o modo tradicional por solicitação, e a utilização da GPU aumenta de 20,4% para 87,7%.
Comentário do setor
A abertura do código-fonte do Polar da NVIDIA basicamente constrói uma “rodovia” para que agentes de IA entrem no treinamento de aprendizado por reforço. Isso não apenas permite que pesquisadores treinem com eficiência usando enormes frameworks de código-fonte aberto, mas também reduz a barreira da computação em GPU por meio da otimização em nível de sistema.
Com a crescente popularidade do Polar, os desenvolvedores não precisam mais se preocupar com “como adaptar modelos às estruturas de treinamento”. No futuro, a evolução dos agentes de codificação de IA se tornará mais padronizada e eficiente. Isso marca uma mudança no treinamento de agentes de IA, passando do ajuste manual em laboratório para uma produção de engenharia sistemática em grande escala.
URL do artigo: https://arxiv.org/pdf/2605.24220








 O ex-pesquisador da OpenAI, Barrett Zoph, retorna ao Google para apoiar o desenvolvimento do Gemini
Barret Zoph, que anteriormente havia deixado a empresa de forma repentina e se juntado à OpenAI devido a um desentendimento com a CEO da Thinking Machines Lab, Miriam Mularati, mudou de emprego mais u
 Como a Recursive Intelligence levantou US$ 335 milhões com uma avaliação de US$ 4 bilhões em 4 meses
As cofundadoras da startup Ricursive Intelligence pareciam destinadas a serem cofundadoras.Anna Goldie, CEO, e Azalia Mirhoseini, CTO, são tão conhecidas na comunidade de IA que estavam entre os engen
 A corrida pela IA não vai esperar, nem esse desconto de 25% do TechCrunch Disrupt
Todo fundador que está trabalhando com IA neste momento faz a mesma pergunta: será que estamos avançando rápido o suficiente e de forma eficaz o suficiente? O TechCrunch Disrupt 2026 coloca você na me

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

So NVIDIA just dropped Polar as open source? That's huge for AI coding agents - integrating Codex and Claude with reinforcement learning sounds like a game changer. But I wonder how much compute you'd need to actually train it effectively... 🤔












