


 Lar
As habilidades de programação da DeepSeek V4 geram buzz online e discussões sobre tendências de estilo
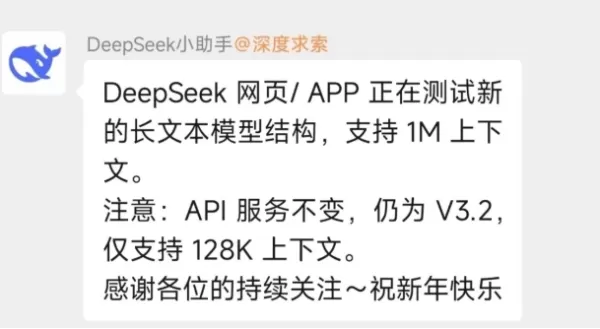
Em 11 de fevereiro, a DeepSeek começou a lançar uma atualização gradual para suas plataformas web e de aplicativos móveis. Em 14 de fevereiro, a empresa anunciou oficialmente isso como um teste de sua nova arquitetura de modelo de texto longo. As interfaces web e de aplicativos atualizadas agora lidam com contextos ultralongos de até 1 milhão de tokens, com a base de conhecimento atualizada para incluir informações até maio de 2025. No entanto, o serviço API permanece na versão V3.2, que ainda suporta apenas 128K de contexto. Especialistas do setor veem essa atualização como um aquecimento técnico e um teste de estresse antes do lançamento de seu modelo V4 de última geração. Consequentemente, a expectativa online está crescendo em plataformas como o Weibo para o próximo lançamento do V4.
Após a atualização, o estilo de interação do DeepSeek mudou visivelmente, levando os usuários a comentarem que ele “se tornou menos simpático”. Esse assunto rapidamente chegou ao topo da lista de tendências do Weibo, acumulando mais de 68,535 milhões de visualizações. As mudanças específicas incluem o fato de o modelo não usar mais apelidos personalizados para os usuários, passando a se dirigir a todos uniformemente como “usuário”. No modo de pensamento profundo, as respostas se tornaram mais curtas e diretas, adotando um tom direto e conciso. Algumas respostas foram até mesmo percebidas como “ambíguas no tom” ou “sarcásticas”, deixando os usuários acostumados com seu estilo empático anterior com uma sensação de rejeição. As reações dos internautas foram divididas: fãs emocionados sentiram falta das interações calorosas anteriores, enquanto usuários preocupados com a eficiência elogiaram a comunicação racional e simplificada, vendo-a como a marca registrada de uma verdadeira ferramenta de produtividade. Notavelmente, o modelo atualizado passou com sucesso no “teste de Turing da lavagem de carros”, um desafio que muitas vezes atrapalha os principais modelos de IA.
Em relação à mudança de estilo, o comunicado oficial da DeepSeek esclareceu que não se tratava de uma mudança intencional, mas um subproduto da priorização da eficiência e do refinamento dos limites de resposta. Expressões excessivas e conteúdo de preenchimento poderiam diluir a densidade das informações em consultas complexas, e a atualização também atendeu aos usuários que preferem respostas claras, sem o que consideram “IA fingindo se importar”. Esse desenvolvimento alimentou ainda mais o entusiasmo online pelo DeepSeek V4. Relatórios sugerem que o modelo está programado para ser lançado por volta do Festival da Primavera, em meados de fevereiro de 2026, possivelmente em ou perto de 17 de fevereiro, de acordo com fontes do Weibo.
Como um modelo emblemático com trilhões de parâmetros, o V4 dá grande ênfase às melhorias de programação. Os primeiros benchmarks internos indicam que o V4 já superou modelos líderes como Claude e GPT em tarefas de programação, posicionando-o para potencialmente remodelar o cenário da programação de IA. Além disso, o V4 introduz vários avanços tecnológicos importantes, permitindo processar e interpretar prompts de código extremamente longos e compreender grandes contextos de código em uma única passagem — uma vantagem significativa para o desenvolvimento em nível empresarial. Algoritmos de treinamento atualizados aprimoram sua capacidade de reconhecer padrões de dados e reduzir a degradação do desempenho. O raciocínio do modelo é mais rigoroso e confiável, alcançando um desempenho estável sem regressão, ao mesmo tempo em que alcança um melhor equilíbrio entre vários recursos.
Ao mesmo tempo, o modelo manterá sua vantagem de contexto de um milhão de tokens, com custos de inferência significativamente mais baixos do que os dos concorrentes ocidentais. Também está programado para ser disponibilizado como código aberto sob a licença Apache 2.0.
Artigo relacionado
 Wan-Streamer v0.2 oferece chat de IA com latência ultrabaixa
À medida que a tecnologia moderna avança rapidamente, a interação entre humanos e inteligência artificial está se tornando mais comum. As chamadas de vídeo tradicionais frequentemente enfrentam problemas de atraso, latência e dessincronização áudio-v
A Meta se une à TSMC e Micron para equipar novos servidores com memória antiga
À medida que a adoção da inteligência artificial se acelera em todo o mundo, a memória DDR5 de próxima geração está enfrentando uma escassez crítica de suprimentos. Para evitar atrasos nos despliegues de data centers de IA, a Meta estabeleceu uma par
Como os Bancos de Dados de Séries Temporais Impulsionam Dados de Robótica em Tempo Real
Doug Pagnutti da Tiger Data.Pagnutti atua como defensor de desenvolvedores industriais na Tiger Data, apoiando equipes na construção de sistemas industriais do mundo real.Com mais de 12 anos de experiência em petróleo e gás e automação de manufatura,
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (0)
Em 11 de fevereiro, a DeepSeek começou a lançar uma atualização gradual para suas plataformas web e de aplicativos móveis. Em 14 de fevereiro, a empresa anunciou oficialmente isso como um teste de sua nova arquitetura de modelo de texto longo. As interfaces web e de aplicativos atualizadas agora lidam com contextos ultralongos de até 1 milhão de tokens, com a base de conhecimento atualizada para incluir informações até maio de 2025. No entanto, o serviço API permanece na versão V3.2, que ainda suporta apenas 128K de contexto. Especialistas do setor veem essa atualização como um aquecimento técnico e um teste de estresse antes do lançamento de seu modelo V4 de última geração. Consequentemente, a expectativa online está crescendo em plataformas como o Weibo para o próximo lançamento do V4.
Após a atualização, o estilo de interação do DeepSeek mudou visivelmente, levando os usuários a comentarem que ele “se tornou menos simpático”. Esse assunto rapidamente chegou ao topo da lista de tendências do Weibo, acumulando mais de 68,535 milhões de visualizações. As mudanças específicas incluem o fato de o modelo não usar mais apelidos personalizados para os usuários, passando a se dirigir a todos uniformemente como “usuário”. No modo de pensamento profundo, as respostas se tornaram mais curtas e diretas, adotando um tom direto e conciso. Algumas respostas foram até mesmo percebidas como “ambíguas no tom” ou “sarcásticas”, deixando os usuários acostumados com seu estilo empático anterior com uma sensação de rejeição. As reações dos internautas foram divididas: fãs emocionados sentiram falta das interações calorosas anteriores, enquanto usuários preocupados com a eficiência elogiaram a comunicação racional e simplificada, vendo-a como a marca registrada de uma verdadeira ferramenta de produtividade. Notavelmente, o modelo atualizado passou com sucesso no “teste de Turing da lavagem de carros”, um desafio que muitas vezes atrapalha os principais modelos de IA.
Em relação à mudança de estilo, o comunicado oficial da DeepSeek esclareceu que não se tratava de uma mudança intencional, mas um subproduto da priorização da eficiência e do refinamento dos limites de resposta. Expressões excessivas e conteúdo de preenchimento poderiam diluir a densidade das informações em consultas complexas, e a atualização também atendeu aos usuários que preferem respostas claras, sem o que consideram “IA fingindo se importar”. Esse desenvolvimento alimentou ainda mais o entusiasmo online pelo DeepSeek V4. Relatórios sugerem que o modelo está programado para ser lançado por volta do Festival da Primavera, em meados de fevereiro de 2026, possivelmente em ou perto de 17 de fevereiro, de acordo com fontes do Weibo.
Como um modelo emblemático com trilhões de parâmetros, o V4 dá grande ênfase às melhorias de programação. Os primeiros benchmarks internos indicam que o V4 já superou modelos líderes como Claude e GPT em tarefas de programação, posicionando-o para potencialmente remodelar o cenário da programação de IA. Além disso, o V4 introduz vários avanços tecnológicos importantes, permitindo processar e interpretar prompts de código extremamente longos e compreender grandes contextos de código em uma única passagem — uma vantagem significativa para o desenvolvimento em nível empresarial. Algoritmos de treinamento atualizados aprimoram sua capacidade de reconhecer padrões de dados e reduzir a degradação do desempenho. O raciocínio do modelo é mais rigoroso e confiável, alcançando um desempenho estável sem regressão, ao mesmo tempo em que alcança um melhor equilíbrio entre vários recursos.
Ao mesmo tempo, o modelo manterá sua vantagem de contexto de um milhão de tokens, com custos de inferência significativamente mais baixos do que os dos concorrentes ocidentais. Também está programado para ser disponibilizado como código aberto sob a licença Apache 2.0.








 Wan-Streamer v0.2 oferece chat de IA com latência ultrabaixa
À medida que a tecnologia moderna avança rapidamente, a interação entre humanos e inteligência artificial está se tornando mais comum. As chamadas de vídeo tradicionais frequentemente enfrentam problemas de atraso, latência e dessincronização áudio-v
 A Meta se une à TSMC e Micron para equipar novos servidores com memória antiga
À medida que a adoção da inteligência artificial se acelera em todo o mundo, a memória DDR5 de próxima geração está enfrentando uma escassez crítica de suprimentos. Para evitar atrasos nos despliegues de data centers de IA, a Meta estabeleceu uma par
 Como os Bancos de Dados de Séries Temporais Impulsionam Dados de Robótica em Tempo Real
Doug Pagnutti da Tiger Data.Pagnutti atua como defensor de desenvolvedores industriais na Tiger Data, apoiando equipes na construção de sistemas industriais do mundo real.Com mais de 12 anos de experiência em petróleo e gás e automação de manufatura,

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai












