


 Lar
O AntGroup torna o LingBot-Video, o primeiro modelo de base de vídeo para inteligência incorporada, de código aberto
Em 9 de julho, o Ant Group disponibilizou como código aberto o LingBot-Video, o primeiro modelo de base de geração de vídeo de código aberto do mundo, construído com base na arquitetura Mixture-of-Experts (MoE) e desenvolvido especificamente para a inteligência incorporada. O modelo redefine o pré-treinamento de vídeo ao se concentrar nas necessidades centrais dos robôs e da inteligência incorporada, proporcionando ganhos sistemáticos em eficiência de raciocínio, plausibilidade física, compreensão de ações e conclusão de tarefas. Ele oferece uma nova base de código aberto para que os modelos fundamentais de vídeo vão além da criação de conteúdo digital e avancem para a inteligência incorporada.
No benchmark RBench, desenvolvido em conjunto pela Universidade de Pequim e pela ByteDance, o LingBot-Video obteve uma pontuação de 0,620, superando o Wan2.6 (0,607), o Seedance1.5Pro (0,584) e o Cosmos3Super (0,581). O RBench, um benchmark de avaliação abrangente para vídeos de manipulação robótica, avalia especificamente se um modelo é capaz de gerar comportamentos robóticos que sigam as leis da física do mundo real. Esse resultado indica que o LingBot-Video é mais eficaz em preservar a racionalidade das ações e a integridade da execução de tarefas ao gerar vídeos relacionados a robôs.
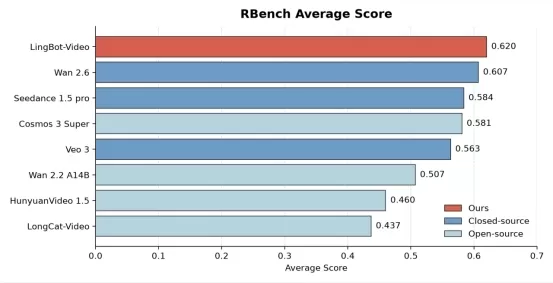
(Legenda da figura: O LingBot-Video alcança o melhor desempenho no RBench)
Para verificar ainda mais a capacidade do LingBot-Video de modelar mudanças no mundo físico, o Ant Group o avaliou em um benchmark interno em duas dimensões: qualidade geral e domínio incorporado. Os resultados mostram que, em comparação com cinco modelos de código aberto — NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 e LTX-2.3 —, o LingBot-Video supera os principais modelos de referência no domínio incorporado.
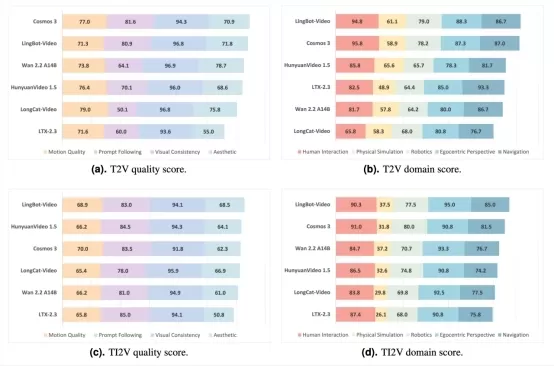
(Legenda da figura: Avaliação abrangente mostra que o LingBot-Video apresenta maior compreensão física e consistência de ação em cenários incorporados)
Nos últimos anos, os modelos de geração de vídeo avançaram rapidamente em termos de qualidade visual, fluidez e expressão criativa. No entanto, para a inteligência incorporada, um vídeo que pareça realista e tenha movimentos suaves pode não refletir as leis físicas reais, dificultando o suporte à previsão contínua, ao planejamento e à execução de tarefas por robôs. Ao mesmo tempo, a inteligência incorporada também exige maior eficiência de raciocínio para se adaptar à interação em tempo real e aos ciclos de controle.
Isso levou a geração de vídeos a evoluir por dois caminhos distintos: um voltado para o cinema, voltado à criação de conteúdo; o outro voltado para robôs, voltado à compreensão, previsão e interação com o mundo físico. O LingBot-Video representa uma exploração significativa do Ant Group em um novo caminho para a geração de vídeos adaptados à inteligência incorporada.
O LingBot-Video introduz inovações sistemáticas em arquitetura, dados e treinamento.
Em termos de arquitetura, o LingBot-Video emprega um design DiT + MoE, substituindo as arquiteturas densas tradicionais pelo MoE. Isso permite que o modelo amplie sua capacidade, mantendo os custos de inferência controláveis. Com 30 bilhões de parâmetros, o modelo ativa apenas cerca de 3 bilhões durante a geração, oferecendo aproximadamente três vezes a eficiência de raciocínio de uma arquitetura densa do mesmo tamanho. Esse projeto confere ao modelo expressividade visual a partir de parâmetros em grande escala, ao mesmo tempo em que atende melhor às demandas de eficiência da inteligência incorporada.
Quanto aos dados, o LingBot-Video desenvolveu um mecanismo de perfilagem de dados, incorporando dados relacionados a robôs, como VLA, VLN e Ego, além de uma enorme quantidade de vídeos da internet, abrangendo cenários que incluem manipulação hábil, mobilidade robótica e interações em primeira pessoa, totalizando 70.000 horas de dados incorporados. Esses dados ajudam o modelo a aprender a relação entre ações e mudanças ambientais, em vez de apenas a textura superficial e o estilo visual dos vídeos.
No treinamento, o LingBot-Video introduziu um sistema de recompensa de aprendizado por reforço multidimensional. Além de métricas convencionais como estética, obediência a comandos e consistência de movimento, o modelo também leva em conta a plausibilidade física e a conclusão de tarefas, tornando os resultados gerados mais consistentes com a física do mundo real e mais próximos das necessidades dos robôs que realizam tarefas no mundo real.
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
chatbot
 Melhores aplicativos de chat de interpretação de papéis com IA para prática de idiomas, preparação para entrevistas e fluência diária
2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
 10 ferramentas
 xix.ai
Composição musical
Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

 Comentários (0)
Em 9 de julho, o Ant Group disponibilizou como código aberto o LingBot-Video, o primeiro modelo de base de geração de vídeo de código aberto do mundo, construído com base na arquitetura Mixture-of-Experts (MoE) e desenvolvido especificamente para a inteligência incorporada. O modelo redefine o pré-treinamento de vídeo ao se concentrar nas necessidades centrais dos robôs e da inteligência incorporada, proporcionando ganhos sistemáticos em eficiência de raciocínio, plausibilidade física, compreensão de ações e conclusão de tarefas. Ele oferece uma nova base de código aberto para que os modelos fundamentais de vídeo vão além da criação de conteúdo digital e avancem para a inteligência incorporada.
No benchmark RBench, desenvolvido em conjunto pela Universidade de Pequim e pela ByteDance, o LingBot-Video obteve uma pontuação de 0,620, superando o Wan2.6 (0,607), o Seedance1.5Pro (0,584) e o Cosmos3Super (0,581). O RBench, um benchmark de avaliação abrangente para vídeos de manipulação robótica, avalia especificamente se um modelo é capaz de gerar comportamentos robóticos que sigam as leis da física do mundo real. Esse resultado indica que o LingBot-Video é mais eficaz em preservar a racionalidade das ações e a integridade da execução de tarefas ao gerar vídeos relacionados a robôs.
(Legenda da figura: O LingBot-Video alcança o melhor desempenho no RBench)
Para verificar ainda mais a capacidade do LingBot-Video de modelar mudanças no mundo físico, o Ant Group o avaliou em um benchmark interno em duas dimensões: qualidade geral e domínio incorporado. Os resultados mostram que, em comparação com cinco modelos de código aberto — NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 e LTX-2.3 —, o LingBot-Video supera os principais modelos de referência no domínio incorporado.
(Legenda da figura: Avaliação abrangente mostra que o LingBot-Video apresenta maior compreensão física e consistência de ação em cenários incorporados)
Nos últimos anos, os modelos de geração de vídeo avançaram rapidamente em termos de qualidade visual, fluidez e expressão criativa. No entanto, para a inteligência incorporada, um vídeo que pareça realista e tenha movimentos suaves pode não refletir as leis físicas reais, dificultando o suporte à previsão contínua, ao planejamento e à execução de tarefas por robôs. Ao mesmo tempo, a inteligência incorporada também exige maior eficiência de raciocínio para se adaptar à interação em tempo real e aos ciclos de controle.
Isso levou a geração de vídeos a evoluir por dois caminhos distintos: um voltado para o cinema, voltado à criação de conteúdo; o outro voltado para robôs, voltado à compreensão, previsão e interação com o mundo físico. O LingBot-Video representa uma exploração significativa do Ant Group em um novo caminho para a geração de vídeos adaptados à inteligência incorporada.
O LingBot-Video introduz inovações sistemáticas em arquitetura, dados e treinamento.
Em termos de arquitetura, o LingBot-Video emprega um design DiT + MoE, substituindo as arquiteturas densas tradicionais pelo MoE. Isso permite que o modelo amplie sua capacidade, mantendo os custos de inferência controláveis. Com 30 bilhões de parâmetros, o modelo ativa apenas cerca de 3 bilhões durante a geração, oferecendo aproximadamente três vezes a eficiência de raciocínio de uma arquitetura densa do mesmo tamanho. Esse projeto confere ao modelo expressividade visual a partir de parâmetros em grande escala, ao mesmo tempo em que atende melhor às demandas de eficiência da inteligência incorporada.
Quanto aos dados, o LingBot-Video desenvolveu um mecanismo de perfilagem de dados, incorporando dados relacionados a robôs, como VLA, VLN e Ego, além de uma enorme quantidade de vídeos da internet, abrangendo cenários que incluem manipulação hábil, mobilidade robótica e interações em primeira pessoa, totalizando 70.000 horas de dados incorporados. Esses dados ajudam o modelo a aprender a relação entre ações e mudanças ambientais, em vez de apenas a textura superficial e o estilo visual dos vídeos.
No treinamento, o LingBot-Video introduziu um sistema de recompensa de aprendizado por reforço multidimensional. Além de métricas convencionais como estética, obediência a comandos e consistência de movimento, o modelo também leva em conta a plausibilidade física e a conclusão de tarefas, tornando os resultados gerados mais consistentes com a física do mundo real e mais próximos das necessidades dos robôs que realizam tarefas no mundo real.








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

2026 Últimas Melhores Aplicativos de Chat de Interpretação de Papéis por IA Mais Bem Avaliados para Prática de Idiomas, Preparação para Entrevistas e Fluência Diária! O XIX.AI seleciona uma poderosa coleção revolucionária que oferece comparação entre gratuito e pago, testes do mundo real e classificações atualizadas semanalmente. Essas ferramentas imperdíveis ajudam você a aprimorar suas habilidades de escrita, superar desafios de fluência e melhorar a eficiência da comunicação em todos os cenários diários. Explore agora para descobrir sua ferramenta perfeita para o crescimento do idioma!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai












