


 Maison
AntGroup met en open source LingBot-Video, le premier modèle de base vidéo dédié à l'intelligence incarnée
Le 9 juillet, Ant Group a mis en open source LingBot-Video, le premier modèle de base open source au monde dédié à la génération de vidéos, reposant sur l’architecture « Mixture-of-Experts » (MoE) et spécialement conçu pour l’intelligence incarnée. Ce modèle redéfinit le pré-entraînement vidéo en se concentrant sur les besoins fondamentaux des robots et de l’intelligence incarnée, ce qui se traduit par des gains systématiques en termes d’efficacité du raisonnement, de plausibilité physique, de compréhension des actions et d’exécution des tâches. Il offre une nouvelle base open source permettant aux modèles de base vidéo d’aller au-delà de la création de contenu numérique pour s’orienter vers l’intelligence incarnée.
Sur le benchmark RBench, développé conjointement par l’université de Pékin et ByteDance, LingBot-Video a obtenu un score de 0,620, surpassant ainsi Wan2.6 (0,607), Seedance1.5Pro (0,584) et Cosmos3Super (0,581). RBench, un benchmark d’évaluation complet dédié aux vidéos de manipulation robotique, évalue spécifiquement si un modèle est capable de générer des comportements robotiques conformes aux lois de la physique du monde réel. Ce résultat indique que LingBot-Video parvient mieux à préserver la rationalité des actions et l’intégrité de l’exécution des tâches lors de la génération de vidéos liées à la robotique.
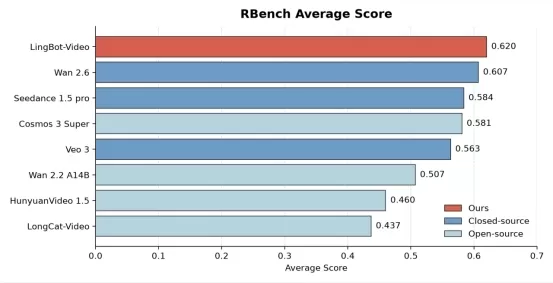
(Légende de la figure : LingBot-Video obtient les meilleures performances sur RBench)
Afin de vérifier plus en détail la capacité de LingBot-Video à modéliser les changements dans le monde physique, Ant Group l’a évalué à l’aide d’un benchmark interne selon deux dimensions : la qualité générale et le domaine incarné. Les résultats montrent que, par rapport à cinq modèles open source — NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 et LTX-2.3 —, LingBot-Video surpasse les principaux modèles de référence dans le domaine incarné.
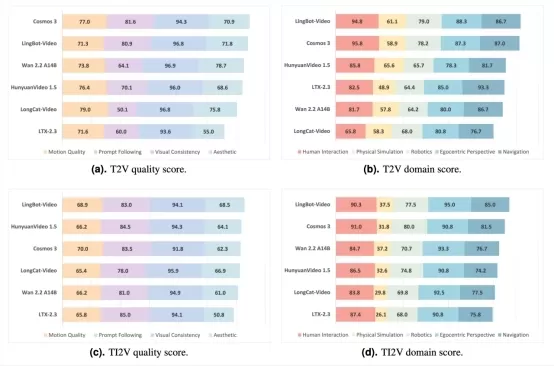
(Légende de la figure : Une évaluation exhaustive montre que LingBot-Video fait preuve d’une meilleure compréhension physique et d’une plus grande cohérence des actions dans des scénarios incarnés)
Ces dernières années, les modèles de génération vidéo ont connu des progrès rapides en termes de qualité visuelle, de fluidité et d’expression créative. Cependant, en matière d’intelligence incarnée, une vidéo qui semble réaliste et dont les mouvements sont fluides peut ne pas refléter les lois physiques réelles, ce qui rend difficile la prédiction continue, la planification et l’exécution de tâches pour les robots. Parallèlement, l’intelligence incarnée exige également une plus grande efficacité de raisonnement pour s’adapter aux interactions en temps réel et aux boucles de contrôle.
Cela a conduit la génération de vidéos à évoluer selon deux voies distinctes : l’une vers le cinéma, au service de la création de contenu ; l’autre vers la robotique, au service de la compréhension, de la prédiction et de l’interaction avec le monde physique. LingBot-Video représente l’exploration majeure menée par Ant Group d’une nouvelle voie pour la génération de vidéos adaptée à l’intelligence incarnée.
LingBot-Video introduit des innovations systématiques en matière d’architecture, de données et d’entraînement.
Sur le plan architectural, LingBot-Video utilise une conception DiT + MoE, remplaçant les architectures denses traditionnelles par le MoE. Cela permet au modèle d’augmenter sa capacité tout en maintenant les coûts d’inférence à un niveau raisonnable. Avec 30 milliards de paramètres, le modèle n’en active qu’environ 3 milliards lors de la génération, offrant ainsi une efficacité de raisonnement environ trois fois supérieure à celle d’une architecture dense de même taille. Cette conception confère au modèle une expressivité visuelle grâce à ses paramètres à grande échelle, tout en répondant mieux aux exigences d’efficacité de l’intelligence incarnée.
En ce qui concerne les données, LingBot-Video a développé un moteur de profilage des données, intégrant des données liées aux robots telles que VLA, VLN et Ego en complément d’une vaste collection de vidéos issues d’Internet, couvrant des scénarios incluant la manipulation de précision, la mobilité des robots et les interactions à la première personne, pour un total de 70 000 heures de données incarnées. Ces données aident le modèle à apprendre la relation entre les actions et les changements environnementaux, plutôt que de se limiter à la texture de surface et au style visuel des vidéos.
Lors de l’entraînement, LingBot-Video a introduit un système de récompense d’apprentissage par renforcement multidimensionnel. Au-delà des métriques conventionnelles telles que l’esthétique, le respect des consignes et la cohérence des mouvements, le modèle tient également compte de la plausibilité physique et de l’accomplissement des tâches, rendant ainsi les résultats générés plus conformes à la physique du monde réel et plus proches des besoins des robots effectuant des tâches dans le monde réel.
Article connexe
 OpenAI ajoute GPT-Live-1 à son API, avec prise en charge de la communication vocale en duplex intégral et des interruptions pour les appels de service client
OpenAI a intégré GPT-Live-1 à son API, permettant ainsi aux développeurs de créer des applications et des flux de travail professionnels qui facilitent les interactions vocales en temps réel. Ce modèl
Cloudflare dévoile « AI Agent Workspace », une solution open source permettant aux employés de créer des flux de travail personnalisés sans avoir à coder
Cloudflare a officiellement lancé Cloudflare OS, un espace de travail open source dédié aux agents d’IA qui fonctionne directement dans le navigateur. Cette plateforme intègre un large éventail de mic
La méthode de paiement par carte de crédit d’IA de Musk suscule une vague de critiques après les moqueries d’un dirigeant d’OpenAI
Elon Musk a récemment dévoilé sur les réseaux sociaux la nouvelle fonctionnalité d’achat de Grok, expliquant que les utilisateurs peuvent prendre en photo leur carte de crédit et l’envoyer à l’interface de chat. L’IA recherchera ensuite sur le web le
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
Le 9 juillet, Ant Group a mis en open source LingBot-Video, le premier modèle de base open source au monde dédié à la génération de vidéos, reposant sur l’architecture « Mixture-of-Experts » (MoE) et spécialement conçu pour l’intelligence incarnée. Ce modèle redéfinit le pré-entraînement vidéo en se concentrant sur les besoins fondamentaux des robots et de l’intelligence incarnée, ce qui se traduit par des gains systématiques en termes d’efficacité du raisonnement, de plausibilité physique, de compréhension des actions et d’exécution des tâches. Il offre une nouvelle base open source permettant aux modèles de base vidéo d’aller au-delà de la création de contenu numérique pour s’orienter vers l’intelligence incarnée.
Sur le benchmark RBench, développé conjointement par l’université de Pékin et ByteDance, LingBot-Video a obtenu un score de 0,620, surpassant ainsi Wan2.6 (0,607), Seedance1.5Pro (0,584) et Cosmos3Super (0,581). RBench, un benchmark d’évaluation complet dédié aux vidéos de manipulation robotique, évalue spécifiquement si un modèle est capable de générer des comportements robotiques conformes aux lois de la physique du monde réel. Ce résultat indique que LingBot-Video parvient mieux à préserver la rationalité des actions et l’intégrité de l’exécution des tâches lors de la génération de vidéos liées à la robotique.
(Légende de la figure : LingBot-Video obtient les meilleures performances sur RBench)
Afin de vérifier plus en détail la capacité de LingBot-Video à modéliser les changements dans le monde physique, Ant Group l’a évalué à l’aide d’un benchmark interne selon deux dimensions : la qualité générale et le domaine incarné. Les résultats montrent que, par rapport à cinq modèles open source — NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 et LTX-2.3 —, LingBot-Video surpasse les principaux modèles de référence dans le domaine incarné.
(Légende de la figure : Une évaluation exhaustive montre que LingBot-Video fait preuve d’une meilleure compréhension physique et d’une plus grande cohérence des actions dans des scénarios incarnés)
Ces dernières années, les modèles de génération vidéo ont connu des progrès rapides en termes de qualité visuelle, de fluidité et d’expression créative. Cependant, en matière d’intelligence incarnée, une vidéo qui semble réaliste et dont les mouvements sont fluides peut ne pas refléter les lois physiques réelles, ce qui rend difficile la prédiction continue, la planification et l’exécution de tâches pour les robots. Parallèlement, l’intelligence incarnée exige également une plus grande efficacité de raisonnement pour s’adapter aux interactions en temps réel et aux boucles de contrôle.
Cela a conduit la génération de vidéos à évoluer selon deux voies distinctes : l’une vers le cinéma, au service de la création de contenu ; l’autre vers la robotique, au service de la compréhension, de la prédiction et de l’interaction avec le monde physique. LingBot-Video représente l’exploration majeure menée par Ant Group d’une nouvelle voie pour la génération de vidéos adaptée à l’intelligence incarnée.
LingBot-Video introduit des innovations systématiques en matière d’architecture, de données et d’entraînement.
Sur le plan architectural, LingBot-Video utilise une conception DiT + MoE, remplaçant les architectures denses traditionnelles par le MoE. Cela permet au modèle d’augmenter sa capacité tout en maintenant les coûts d’inférence à un niveau raisonnable. Avec 30 milliards de paramètres, le modèle n’en active qu’environ 3 milliards lors de la génération, offrant ainsi une efficacité de raisonnement environ trois fois supérieure à celle d’une architecture dense de même taille. Cette conception confère au modèle une expressivité visuelle grâce à ses paramètres à grande échelle, tout en répondant mieux aux exigences d’efficacité de l’intelligence incarnée.
En ce qui concerne les données, LingBot-Video a développé un moteur de profilage des données, intégrant des données liées aux robots telles que VLA, VLN et Ego en complément d’une vaste collection de vidéos issues d’Internet, couvrant des scénarios incluant la manipulation de précision, la mobilité des robots et les interactions à la première personne, pour un total de 70 000 heures de données incarnées. Ces données aident le modèle à apprendre la relation entre les actions et les changements environnementaux, plutôt que de se limiter à la texture de surface et au style visuel des vidéos.
Lors de l’entraînement, LingBot-Video a introduit un système de récompense d’apprentissage par renforcement multidimensionnel. Au-delà des métriques conventionnelles telles que l’esthétique, le respect des consignes et la cohérence des mouvements, le modèle tient également compte de la plausibilité physique et de l’accomplissement des tâches, rendant ainsi les résultats générés plus conformes à la physique du monde réel et plus proches des besoins des robots effectuant des tâches dans le monde réel.








 OpenAI ajoute GPT-Live-1 à son API, avec prise en charge de la communication vocale en duplex intégral et des interruptions pour les appels de service client
OpenAI a intégré GPT-Live-1 à son API, permettant ainsi aux développeurs de créer des applications et des flux de travail professionnels qui facilitent les interactions vocales en temps réel. Ce modèl
 Cloudflare dévoile « AI Agent Workspace », une solution open source permettant aux employés de créer des flux de travail personnalisés sans avoir à coder
Cloudflare a officiellement lancé Cloudflare OS, un espace de travail open source dédié aux agents d’IA qui fonctionne directement dans le navigateur. Cette plateforme intègre un large éventail de mic
 La méthode de paiement par carte de crédit d’IA de Musk suscule une vague de critiques après les moqueries d’un dirigeant d’OpenAI
Elon Musk a récemment dévoilé sur les réseaux sociaux la nouvelle fonctionnalité d’achat de Grok, expliquant que les utilisateurs peuvent prendre en photo leur carte de crédit et l’envoyer à l’interface de chat. L’IA recherchera ensuite sur le web le

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












