


 Hogar
AntGroup publica en código abierto LingBot-Video, el primer modelo base de vídeo para la inteligencia incorporada
El 9 de julio, Ant Group publicó en código abierto LingBot-Video, el primer modelo base de generación de vídeo de código abierto del mundo, basado en la arquitectura «Mixture-of-Experts» (MoE) y diseñado específicamente para la inteligencia incorporada. El modelo redefine el preentrenamiento de vídeo al centrarse en las necesidades fundamentales de los robots y la inteligencia encarnada, lo que aporta mejoras sistemáticas en la eficiencia del razonamiento, la verosimilitud física, la comprensión de las acciones y la realización de tareas. Ofrece una nueva base de código abierto para que los modelos base de vídeo vayan más allá de la creación de contenido digital y se adentren en el ámbito de la inteligencia encarnada.
En el banco de pruebas RBench, desarrollado conjuntamente por la Universidad de Pekín y ByteDance, LingBot-Video obtuvo una puntuación de 0,620, superando a Wan2.6 (0,607), Seedance1.5Pro (0,584) y Cosmos3Super (0,581). RBench, un banco de pruebas de evaluación exhaustivo para vídeos de manipulación robótica, evalúa específicamente si un modelo es capaz de generar comportamientos robóticos que se ajusten a las leyes de la física del mundo real. Este resultado indica que LingBot-Video es más eficaz a la hora de preservar la racionalidad de las acciones y la integridad en la ejecución de tareas al generar vídeos relacionados con la robótica.
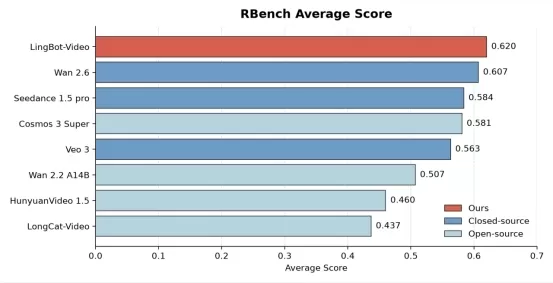
(Pie de foto: LingBot-Video alcanza el mejor rendimiento en RBench)
Para verificar aún más la capacidad de LingBot-Video para modelar los cambios en el mundo físico, Ant Group lo evaluó en un banco de pruebas interno en dos dimensiones: calidad general y dominio incorporado. Los resultados muestran que, en comparación con cinco modelos de código abierto —NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 y LTX-2.3—, LingBot-Video supera a los principales modelos de referencia en el ámbito encarnado.
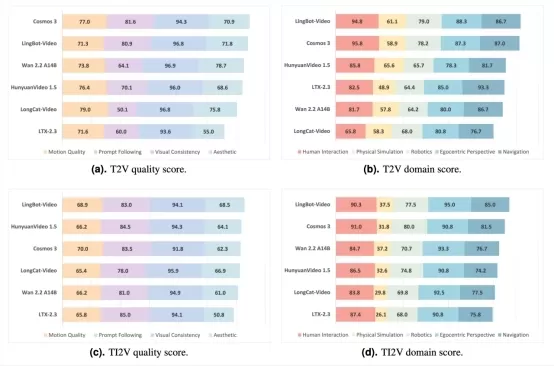
(Pie de foto: Una evaluación exhaustiva muestra que LingBot-Video presenta una mayor comprensión física y coherencia en las acciones en escenarios incorporados)
En los últimos años, los modelos de generación de vídeo han avanzado rápidamente en cuanto a calidad visual, fluidez y expresión creativa. Sin embargo, en el caso de la inteligencia incorporada, un vídeo que parezca realista y se mueva con fluidez puede no reflejar las leyes físicas reales, lo que dificulta la predicción continua, la planificación y la ejecución de tareas por parte de los robots. Al mismo tiempo, la inteligencia incorporada también exige una mayor eficiencia en el razonamiento para adaptarse a la interacción en tiempo real y a los bucles de control.
Esto ha impulsado la evolución de la generación de vídeo por dos vías distintas: una hacia el cine, al servicio de la creación de contenidos; y otra hacia los robots, al servicio de la comprensión, la predicción y la interacción con el mundo físico. LingBot-Video representa la importante exploración de Ant Group de una nueva vía para la generación de vídeo adaptada a la inteligencia incorporada.
LingBot-Video introduce innovaciones sistemáticas en arquitectura, datos y entrenamiento.
Desde el punto de vista arquitectónico, LingBot-Video emplea un diseño DiT + MoE, sustituyendo las arquitecturas densas tradicionales por MoE. Esto permite al modelo ampliar su capacidad al tiempo que mantiene los costes de inferencia dentro de unos límites razonables. Con 30 000 millones de parámetros, el modelo activa solo unos 3 000 millones durante la generación, lo que ofrece aproximadamente el triple de eficiencia de razonamiento que una arquitectura densa del mismo tamaño. Este diseño dota al modelo de expresividad visual gracias a los parámetros a gran escala, al tiempo que satisface mejor las exigencias de eficiencia de la inteligencia incorporada.
En cuanto a los datos, LingBot-Video ha creado un motor de perfilado de datos que incorpora datos relacionados con la robótica —como VLA, VLN y Ego— además de una enorme cantidad de vídeos de Internet, cubriendo escenarios que incluyen la manipulación diestra, la movilidad de los robots y las interacciones en primera persona, lo que suma un total de 70 000 horas de datos incorporados. Estos datos ayudan al modelo a aprender la relación entre las acciones y los cambios ambientales, en lugar de limitarse únicamente a la textura superficial y el estilo visual de los vídeos.
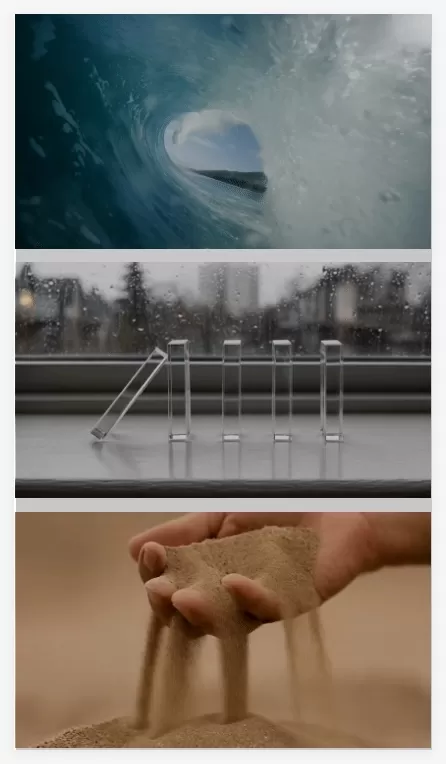
Durante el entrenamiento, LingBot-Video introdujo un sistema de recompensas de aprendizaje por refuerzo multidimensional. Más allá de métricas convencionales como la estética, el seguimiento de indicaciones y la coherencia del movimiento, el modelo también tiene en cuenta la plausibilidad física y la finalización de tareas, lo que hace que los resultados generados sean más coherentes con la física del mundo real y más cercanos a las necesidades de los robots que realizan tareas en el mundo real.
Artículo relacionado
 OpenAI incorpora GPT-Live-1 a su API con voz full-duplex y compatibilidad con interrupciones para llamadas de atención al cliente
OpenAI ha integrado GPT-Live-1 en su API, lo que permite a los desarrolladores crear aplicaciones y flujos de trabajo empresariales que facilitan las interacciones de voz en tiempo real. Este modelo p
Cloudflare presenta «AI Agent Workspace», una herramienta de código abierto que permite a los empleados crear flujos de trabajo personalizados sin necesidad de programar
Cloudflare ha lanzado oficialmente Cloudflare OS, un espacio de trabajo de código abierto basado en inteligencia artificial que funciona directamente en el navegador. Esta plataforma integra una ampli
La salida de Musk con la tarjeta de crédito de IA genera rechazo tras las burlas de un ejecutivo de OpenAI
Elon Musk presentó recientemente la nueva capacidad de compras de Grok en las redes sociales, explicando que los usuarios pueden tomar una foto de su tarjeta de crédito y enviarla a la interfaz de chat. La IA luego buscará en la web los mejores preci
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
El 9 de julio, Ant Group publicó en código abierto LingBot-Video, el primer modelo base de generación de vídeo de código abierto del mundo, basado en la arquitectura «Mixture-of-Experts» (MoE) y diseñado específicamente para la inteligencia incorporada. El modelo redefine el preentrenamiento de vídeo al centrarse en las necesidades fundamentales de los robots y la inteligencia encarnada, lo que aporta mejoras sistemáticas en la eficiencia del razonamiento, la verosimilitud física, la comprensión de las acciones y la realización de tareas. Ofrece una nueva base de código abierto para que los modelos base de vídeo vayan más allá de la creación de contenido digital y se adentren en el ámbito de la inteligencia encarnada.
En el banco de pruebas RBench, desarrollado conjuntamente por la Universidad de Pekín y ByteDance, LingBot-Video obtuvo una puntuación de 0,620, superando a Wan2.6 (0,607), Seedance1.5Pro (0,584) y Cosmos3Super (0,581). RBench, un banco de pruebas de evaluación exhaustivo para vídeos de manipulación robótica, evalúa específicamente si un modelo es capaz de generar comportamientos robóticos que se ajusten a las leyes de la física del mundo real. Este resultado indica que LingBot-Video es más eficaz a la hora de preservar la racionalidad de las acciones y la integridad en la ejecución de tareas al generar vídeos relacionados con la robótica.
(Pie de foto: LingBot-Video alcanza el mejor rendimiento en RBench)
Para verificar aún más la capacidad de LingBot-Video para modelar los cambios en el mundo físico, Ant Group lo evaluó en un banco de pruebas interno en dos dimensiones: calidad general y dominio incorporado. Los resultados muestran que, en comparación con cinco modelos de código abierto —NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 y LTX-2.3—, LingBot-Video supera a los principales modelos de referencia en el ámbito encarnado.
(Pie de foto: Una evaluación exhaustiva muestra que LingBot-Video presenta una mayor comprensión física y coherencia en las acciones en escenarios incorporados)
En los últimos años, los modelos de generación de vídeo han avanzado rápidamente en cuanto a calidad visual, fluidez y expresión creativa. Sin embargo, en el caso de la inteligencia incorporada, un vídeo que parezca realista y se mueva con fluidez puede no reflejar las leyes físicas reales, lo que dificulta la predicción continua, la planificación y la ejecución de tareas por parte de los robots. Al mismo tiempo, la inteligencia incorporada también exige una mayor eficiencia en el razonamiento para adaptarse a la interacción en tiempo real y a los bucles de control.
Esto ha impulsado la evolución de la generación de vídeo por dos vías distintas: una hacia el cine, al servicio de la creación de contenidos; y otra hacia los robots, al servicio de la comprensión, la predicción y la interacción con el mundo físico. LingBot-Video representa la importante exploración de Ant Group de una nueva vía para la generación de vídeo adaptada a la inteligencia incorporada.
LingBot-Video introduce innovaciones sistemáticas en arquitectura, datos y entrenamiento.
Desde el punto de vista arquitectónico, LingBot-Video emplea un diseño DiT + MoE, sustituyendo las arquitecturas densas tradicionales por MoE. Esto permite al modelo ampliar su capacidad al tiempo que mantiene los costes de inferencia dentro de unos límites razonables. Con 30 000 millones de parámetros, el modelo activa solo unos 3 000 millones durante la generación, lo que ofrece aproximadamente el triple de eficiencia de razonamiento que una arquitectura densa del mismo tamaño. Este diseño dota al modelo de expresividad visual gracias a los parámetros a gran escala, al tiempo que satisface mejor las exigencias de eficiencia de la inteligencia incorporada.
En cuanto a los datos, LingBot-Video ha creado un motor de perfilado de datos que incorpora datos relacionados con la robótica —como VLA, VLN y Ego— además de una enorme cantidad de vídeos de Internet, cubriendo escenarios que incluyen la manipulación diestra, la movilidad de los robots y las interacciones en primera persona, lo que suma un total de 70 000 horas de datos incorporados. Estos datos ayudan al modelo a aprender la relación entre las acciones y los cambios ambientales, en lugar de limitarse únicamente a la textura superficial y el estilo visual de los vídeos.
Durante el entrenamiento, LingBot-Video introdujo un sistema de recompensas de aprendizaje por refuerzo multidimensional. Más allá de métricas convencionales como la estética, el seguimiento de indicaciones y la coherencia del movimiento, el modelo también tiene en cuenta la plausibilidad física y la finalización de tareas, lo que hace que los resultados generados sean más coherentes con la física del mundo real y más cercanos a las necesidades de los robots que realizan tareas en el mundo real.








 OpenAI incorpora GPT-Live-1 a su API con voz full-duplex y compatibilidad con interrupciones para llamadas de atención al cliente
OpenAI ha integrado GPT-Live-1 en su API, lo que permite a los desarrolladores crear aplicaciones y flujos de trabajo empresariales que facilitan las interacciones de voz en tiempo real. Este modelo p
 Cloudflare presenta «AI Agent Workspace», una herramienta de código abierto que permite a los empleados crear flujos de trabajo personalizados sin necesidad de programar
Cloudflare ha lanzado oficialmente Cloudflare OS, un espacio de trabajo de código abierto basado en inteligencia artificial que funciona directamente en el navegador. Esta plataforma integra una ampli
 La salida de Musk con la tarjeta de crédito de IA genera rechazo tras las burlas de un ejecutivo de OpenAI
Elon Musk presentó recientemente la nueva capacidad de compras de Grok en las redes sociales, explicando que los usuarios pueden tomar una foto de su tarjeta de crédito y enviarla a la interfaz de chat. La IA luego buscará en la web los mejores preci

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












