


 Heim
AntGroup veröffentlicht „LingBot-Video“ als Open-Source-Projekt – das erste Video-Grundmodell für verkörperte Intelligenz
Am 9. Juli hat die Ant Group „LingBot-Video“ als Open-Source-Projekt veröffentlicht – das weltweit erste Open-Source-Grundmodell zur Videogenerierung, das auf der Mixture-of-Experts-Architektur (MoE) basiert und speziell für verkörperte Intelligenz entwickelt wurde. Das Modell definiert das Vortraining von Videos neu, indem es sich auf die Kernanforderungen von Robotern und verkörperter Intelligenz konzentriert und systematische Verbesserungen bei der Effizienz des logischen Denkens, der physikalischen Plausibilität, dem Verständnis von Handlungen und der Aufgabenbewältigung erzielt. Es bietet eine neue Open-Source-Grundlage für Video-Grundmodelle, um über die Erstellung digitaler Inhalte hinaus in den Bereich der verkörperten Intelligenz vorzudringen.
Im RBench-Benchmark, der gemeinsam von der Peking-Universität und ByteDance entwickelt wurde, erzielte LingBot-Video einen Wert von 0,620 und übertraf damit Wan2.6 (0,607), Seedance1.5Pro (0,584) und Cosmos3Super (0,581). RBench, ein umfassender Bewertungs-Benchmark für Videos zur Robotermanipulation, prüft insbesondere, ob ein Modell Roboterverhalten generieren kann, das den Gesetzen der realen Physik folgt. Dieses Ergebnis zeigt, dass LingBot-Video bei der Generierung von roboterbezogenen Videos die Handlungsrationalität und die Integrität der Aufgabenausführung besser bewahrt.
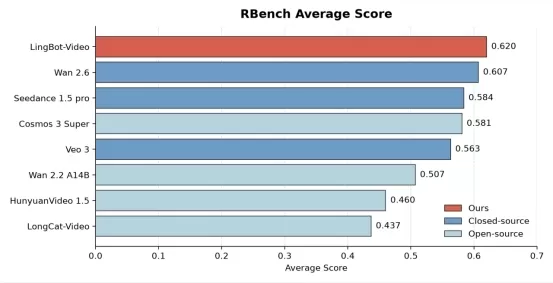
(Bildunterschrift: LingBot-Video erzielt die beste Leistung bei RBench)
Um die Fähigkeit von LingBot-Video zur Modellierung von Veränderungen in der physikalischen Welt weiter zu überprüfen, bewertete die Ant Group das Modell anhand eines internen Benchmarks in zwei Dimensionen: allgemeine Qualität und verkörperter Anwendungsbereich. Die Ergebnisse zeigen, dass LingBot-Video im Vergleich zu fünf Open-Source-Modellen – NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 und LTX-2.3 – die wichtigsten Basismodelle im Bereich der verkörperten Domäne übertrifft.
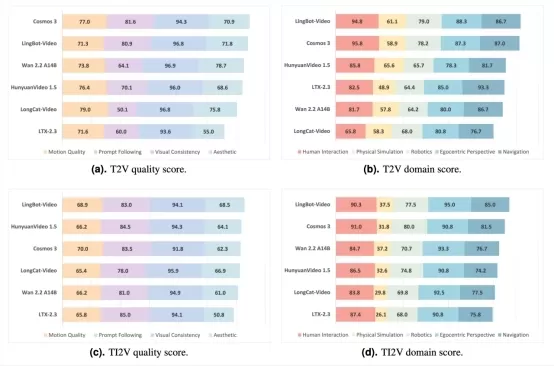
(Bildunterschrift: Eine umfassende Bewertung zeigt, dass LingBot-Video in verkörperten Szenarien ein besseres Verständnis der physikalischen Welt und eine höhere Konsistenz der Handlungen aufweist)
In den letzten Jahren haben sich Modelle zur Videogenerierung hinsichtlich visueller Qualität, Laufruhe und kreativem Ausdruck rasant weiterentwickelt. Für die verkörperte Intelligenz spiegelt ein Video, das realistisch aussieht und sich flüssig bewegt, jedoch möglicherweise nicht die tatsächlichen physikalischen Gesetze wider, was die Unterstützung kontinuierlicher Vorhersagen, Planungen und Aufgabenausführung für Roboter erschwert. Gleichzeitig erfordert verkörperte Intelligenz auch eine höhere Effizienz beim logischen Schlussfolgern, um sich an Echtzeit-Interaktionen und Regelkreise anzupassen.
Dies hat dazu geführt, dass sich die Videogenerierung entlang zweier unterschiedlicher Wege weiterentwickelt hat: zum einen in Richtung Filmindustrie, um die Erstellung von Inhalten zu unterstützen; zum anderen in Richtung Robotik, um das Verständnis, die Vorhersage und die Interaktion mit der physikalischen Welt zu fördern. LingBot-Video steht für die bedeutende Erforschung eines neuen Weges zur Videogenerierung durch die Ant Group, der speziell auf verkörperte Intelligenz zugeschnitten ist.
LingBot-Video führt systematische Innovationen in den Bereichen Architektur, Daten und Training ein.
Architektonisch setzt LingBot-Video auf ein DiT + MoE-Design, bei dem traditionelle dichte Architekturen durch MoE ersetzt werden. Dadurch kann das Modell seine Kapazität skalieren und gleichzeitig die Inferenzkosten überschaubar halten. Bei 30 Milliarden Parametern aktiviert das Modell während der Generierung nur etwa 3 Milliarden und bietet damit eine etwa dreimal so hohe Schlussfolgerungseffizienz wie eine dichte Architektur gleicher Größe. Dieses Design verleiht dem Modell visuelle Ausdruckskraft durch die große Anzahl an Parametern und erfüllt gleichzeitig besser die Effizienzanforderungen der verkörperten Intelligenz.
Für die Daten hat LingBot-Video eine Datenprofilierungs-Engine entwickelt, die roboterbezogene Daten wie VLA, VLN und Ego zusätzlich zu umfangreichen Internetvideos einbezieht und Szenarien wie geschickte Manipulation, Robotermobilität und Interaktionen aus der Ich-Perspektive abdeckt – insgesamt 70.000 Stunden verkörperter Daten. Diese Daten helfen dem Modell dabei, die Zusammenhänge zwischen Handlungen und Veränderungen in der Umgebung zu erlernen, anstatt sich nur auf die Oberflächenstruktur und den visuellen Stil der Videos zu beschränken.
Beim Training führte LingBot-Video ein mehrdimensionales Belohnungssystem für das verstärkende Lernen ein. Über herkömmliche Metriken wie Ästhetik, Befehlsbefolgung und Bewegungskonsistenz hinaus orientiert sich das Modell auch an physikalischer Plausibilität und der Erledigung von Aufgaben, wodurch die generierten Ergebnisse besser mit der Physik der realen Welt übereinstimmen und den Anforderungen von Robotern entsprechen, die Aufgaben in der realen Welt ausführen.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
 8 Tools
 xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

 Kommentare (0)
Am 9. Juli hat die Ant Group „LingBot-Video“ als Open-Source-Projekt veröffentlicht – das weltweit erste Open-Source-Grundmodell zur Videogenerierung, das auf der Mixture-of-Experts-Architektur (MoE) basiert und speziell für verkörperte Intelligenz entwickelt wurde. Das Modell definiert das Vortraining von Videos neu, indem es sich auf die Kernanforderungen von Robotern und verkörperter Intelligenz konzentriert und systematische Verbesserungen bei der Effizienz des logischen Denkens, der physikalischen Plausibilität, dem Verständnis von Handlungen und der Aufgabenbewältigung erzielt. Es bietet eine neue Open-Source-Grundlage für Video-Grundmodelle, um über die Erstellung digitaler Inhalte hinaus in den Bereich der verkörperten Intelligenz vorzudringen.
Im RBench-Benchmark, der gemeinsam von der Peking-Universität und ByteDance entwickelt wurde, erzielte LingBot-Video einen Wert von 0,620 und übertraf damit Wan2.6 (0,607), Seedance1.5Pro (0,584) und Cosmos3Super (0,581). RBench, ein umfassender Bewertungs-Benchmark für Videos zur Robotermanipulation, prüft insbesondere, ob ein Modell Roboterverhalten generieren kann, das den Gesetzen der realen Physik folgt. Dieses Ergebnis zeigt, dass LingBot-Video bei der Generierung von roboterbezogenen Videos die Handlungsrationalität und die Integrität der Aufgabenausführung besser bewahrt.
(Bildunterschrift: LingBot-Video erzielt die beste Leistung bei RBench)
Um die Fähigkeit von LingBot-Video zur Modellierung von Veränderungen in der physikalischen Welt weiter zu überprüfen, bewertete die Ant Group das Modell anhand eines internen Benchmarks in zwei Dimensionen: allgemeine Qualität und verkörperter Anwendungsbereich. Die Ergebnisse zeigen, dass LingBot-Video im Vergleich zu fünf Open-Source-Modellen – NVIDIA Cosmos3, Wan2.2A14B, LongCat-Video, Hunyuan Video1.5 und LTX-2.3 – die wichtigsten Basismodelle im Bereich der verkörperten Domäne übertrifft.
(Bildunterschrift: Eine umfassende Bewertung zeigt, dass LingBot-Video in verkörperten Szenarien ein besseres Verständnis der physikalischen Welt und eine höhere Konsistenz der Handlungen aufweist)
In den letzten Jahren haben sich Modelle zur Videogenerierung hinsichtlich visueller Qualität, Laufruhe und kreativem Ausdruck rasant weiterentwickelt. Für die verkörperte Intelligenz spiegelt ein Video, das realistisch aussieht und sich flüssig bewegt, jedoch möglicherweise nicht die tatsächlichen physikalischen Gesetze wider, was die Unterstützung kontinuierlicher Vorhersagen, Planungen und Aufgabenausführung für Roboter erschwert. Gleichzeitig erfordert verkörperte Intelligenz auch eine höhere Effizienz beim logischen Schlussfolgern, um sich an Echtzeit-Interaktionen und Regelkreise anzupassen.
Dies hat dazu geführt, dass sich die Videogenerierung entlang zweier unterschiedlicher Wege weiterentwickelt hat: zum einen in Richtung Filmindustrie, um die Erstellung von Inhalten zu unterstützen; zum anderen in Richtung Robotik, um das Verständnis, die Vorhersage und die Interaktion mit der physikalischen Welt zu fördern. LingBot-Video steht für die bedeutende Erforschung eines neuen Weges zur Videogenerierung durch die Ant Group, der speziell auf verkörperte Intelligenz zugeschnitten ist.
LingBot-Video führt systematische Innovationen in den Bereichen Architektur, Daten und Training ein.
Architektonisch setzt LingBot-Video auf ein DiT + MoE-Design, bei dem traditionelle dichte Architekturen durch MoE ersetzt werden. Dadurch kann das Modell seine Kapazität skalieren und gleichzeitig die Inferenzkosten überschaubar halten. Bei 30 Milliarden Parametern aktiviert das Modell während der Generierung nur etwa 3 Milliarden und bietet damit eine etwa dreimal so hohe Schlussfolgerungseffizienz wie eine dichte Architektur gleicher Größe. Dieses Design verleiht dem Modell visuelle Ausdruckskraft durch die große Anzahl an Parametern und erfüllt gleichzeitig besser die Effizienzanforderungen der verkörperten Intelligenz.
Für die Daten hat LingBot-Video eine Datenprofilierungs-Engine entwickelt, die roboterbezogene Daten wie VLA, VLN und Ego zusätzlich zu umfangreichen Internetvideos einbezieht und Szenarien wie geschickte Manipulation, Robotermobilität und Interaktionen aus der Ich-Perspektive abdeckt – insgesamt 70.000 Stunden verkörperter Daten. Diese Daten helfen dem Modell dabei, die Zusammenhänge zwischen Handlungen und Veränderungen in der Umgebung zu erlernen, anstatt sich nur auf die Oberflächenstruktur und den visuellen Stil der Videos zu beschränken.
Beim Training führte LingBot-Video ein mehrdimensionales Belohnungssystem für das verstärkende Lernen ein. Über herkömmliche Metriken wie Ästhetik, Befehlsbefolgung und Bewegungskonsistenz hinaus orientiert sich das Modell auch an physikalischer Plausibilität und der Erledigung von Aufgaben, wodurch die generierten Ergebnisse besser mit der Physik der realen Welt übereinstimmen und den Anforderungen von Robotern entsprechen, die Aufgaben in der realen Welt ausführen.








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai












