


 家
清華大学とテンセント・フンユアン、NPUの処理速度を4.1倍に高速化し、MLSys2026 MoE推論チャレンジで優勝
清華大学のストレージ研究所とテンセントのMegEngine AIインフラチームは、最近、機械学習システムの主要な国際会議であるMLSys2026で開催された「MoEモデル推論最適化チャレンジ」で世界優勝を果たした。
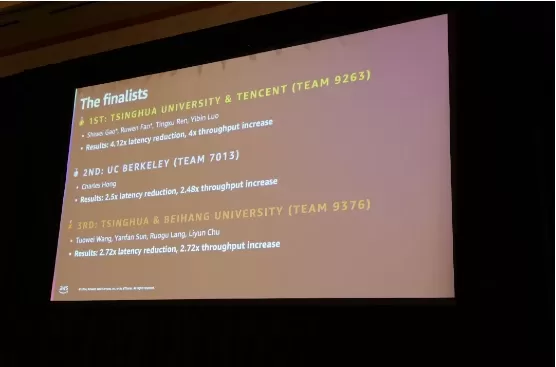
異種NPUチップ上で動作するパラメータ数が1兆規模に達する「Mixture-of-Experts(MoE)」アーキテクチャにおける推論性能のボトルネックに対処するため、共同チームは公式モデルとNPUハードウェアを対象としたフルチェーン最適化ソリューションを設計した。 エキスパートレベルでのタスク分割に「E-Shard」戦略を採用し、PSUM 3Dテンソルのバッチ読み出し、並行処理のために複数のバンクに出力を分散させるGEMVパス、および初期データ転送の遅延を低減するためのスカラーエンジンを活用することで、オペレーターレベルにおけるデータ転送効率の低さや反復的な活性化転送の問題を解消することに成功しました。
並行して、チームはアテンションモジュールおよびコアとなるTransformer演算子のオンチップデータレイアウトを再編成し、ビットレベルでの高精度なアライメントを実現した。
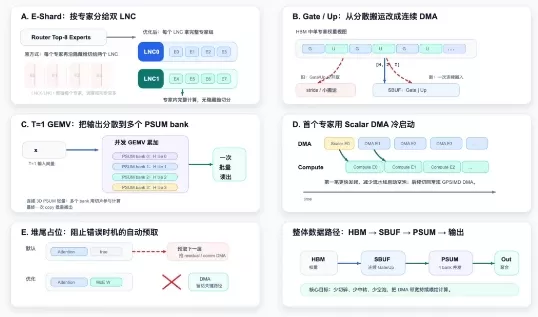
図 3: E-Shard によるエキスパート分割、連続 DMA、PSUM/GEMV による並行処理、コールドスタートパイプライン、およびプリフェッチ制御を特徴とする MoE 最適化アーキテクチャの図。
さらに、チームは「Knight」というエージェントベースの推論オペレータオプティマイザを開発しました。 提案、コード実装、反復という自動化された閉ループプロセスを通じて、最適化の探索空間を劇的に拡大しました。その結果、エンドツーエンドの推論時間は 14.91 秒から 3.56 秒へと短縮され、4.1 倍の高速化を実現しました。 1ステップあたりのデコード遅延は12.63msから5.45msに短縮され、重み読み込み時のDMAエンジンの利用率は約80%に達した。
スタンフォード大学やMITといった世界有数の大学のチームを上回るこの成果は、大規模モデルを基盤システムに適応させ、演算子を最適化する中国チームの深い専門知識を浮き彫りにしています。また、将来のスーパーノード・コンピューティング・プラットフォーム上で、1兆パラメータ規模のMoEモデルを展開するための貴重なエンジニアリングの青写真も提供しています。
関連記事
 Anthropic、1週間の間に2件の大規模なデータ漏洩が発生し、AI安全に関する主張への信頼が揺らいだ
Anthropicは、安全性と慎重さを重視することで認識されているAIのリーダーであり、最近、技術分野で大きな反響を巻き起こした。先週、3,000件の内部文書が誤って公開された後、同社は火曜日にさらに重大な過ちを犯した:パッケージング設定のミスにより、同社の主力製品の「設計図」が露出し、512,000行以上のソースコードが一般に漏洩した。この事件は外部のサイバー攻撃ではなく、人間のミスに起因するものである。Anthropicはこれを「リリースパッケージングの問題」として軽視しようとしたが、モデ
Agility Robotics、Digit 5 の高速充電に Nyobolt を採用
Nyobolt supplies fast-charging, long-lasting battery technology for Digit 5. Source: Agilityパワー管理は、ヒューマノイドロボット開発者にとって依然として重要な課題です。Agility Robotics Inc.は、Nyoboltとの協業を発表し、そのDigit 5プラットフォーム向けの急速充電バッテリーシステムの開発を行っています。両社によると、この革新により、ロボットは1日あたり20時間以上稼働すること
Apple iOS 27 アップデート:Siri、ChatGPT 無償切替機能付きのデュアルモード時代へ突入
iOS 27では、Siriのアーキテクチャに根本的な見直しが行われ、従来の音声のみによる対話を超えた、新しいスタンドアロンアプリケーションを中心に据えています。チャットボットインターフェースを備えたこのアプリは、ユーザーがプロンプトを入力してシームレスなAI会話を行うことを可能にします。画像やドキュメントのアップロードをサポートし、チャット履歴を保持し、複雑なマルチステップタスクを簡素化します。Appleは、ネイティブのSiriとChatGPTなどのサードパーティ製モデルを切り替えることをユーザ
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (1)
0/500
![BrianMartinez]()
That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉
清華大学のストレージ研究所とテンセントのMegEngine AIインフラチームは、最近、機械学習システムの主要な国際会議であるMLSys2026で開催された「MoEモデル推論最適化チャレンジ」で世界優勝を果たした。
異種NPUチップ上で動作するパラメータ数が1兆規模に達する「Mixture-of-Experts(MoE)」アーキテクチャにおける推論性能のボトルネックに対処するため、共同チームは公式モデルとNPUハードウェアを対象としたフルチェーン最適化ソリューションを設計した。 エキスパートレベルでのタスク分割に「E-Shard」戦略を採用し、PSUM 3Dテンソルのバッチ読み出し、並行処理のために複数のバンクに出力を分散させるGEMVパス、および初期データ転送の遅延を低減するためのスカラーエンジンを活用することで、オペレーターレベルにおけるデータ転送効率の低さや反復的な活性化転送の問題を解消することに成功しました。
並行して、チームはアテンションモジュールおよびコアとなるTransformer演算子のオンチップデータレイアウトを再編成し、ビットレベルでの高精度なアライメントを実現した。
図 3: E-Shard によるエキスパート分割、連続 DMA、PSUM/GEMV による並行処理、コールドスタートパイプライン、およびプリフェッチ制御を特徴とする MoE 最適化アーキテクチャの図。
さらに、チームは「Knight」というエージェントベースの推論オペレータオプティマイザを開発しました。 提案、コード実装、反復という自動化された閉ループプロセスを通じて、最適化の探索空間を劇的に拡大しました。その結果、エンドツーエンドの推論時間は 14.91 秒から 3.56 秒へと短縮され、4.1 倍の高速化を実現しました。 1ステップあたりのデコード遅延は12.63msから5.45msに短縮され、重み読み込み時のDMAエンジンの利用率は約80%に達した。
スタンフォード大学やMITといった世界有数の大学のチームを上回るこの成果は、大規模モデルを基盤システムに適応させ、演算子を最適化する中国チームの深い専門知識を浮き彫りにしています。また、将来のスーパーノード・コンピューティング・プラットフォーム上で、1兆パラメータ規模のMoEモデルを展開するための貴重なエンジニアリングの青写真も提供しています。








 Anthropic、1週間の間に2件の大規模なデータ漏洩が発生し、AI安全に関する主張への信頼が揺らいだ
Anthropicは、安全性と慎重さを重視することで認識されているAIのリーダーであり、最近、技術分野で大きな反響を巻き起こした。先週、3,000件の内部文書が誤って公開された後、同社は火曜日にさらに重大な過ちを犯した:パッケージング設定のミスにより、同社の主力製品の「設計図」が露出し、512,000行以上のソースコードが一般に漏洩した。この事件は外部のサイバー攻撃ではなく、人間のミスに起因するものである。Anthropicはこれを「リリースパッケージングの問題」として軽視しようとしたが、モデ
Agility Robotics、Digit 5 の高速充電に Nyobolt を採用
Nyobolt supplies fast-charging, long-lasting battery technology for Digit 5. Source: Agilityパワー管理は、ヒューマノイドロボット開発者にとって依然として重要な課題です。Agility Robotics Inc.は、Nyoboltとの協業を発表し、そのDigit 5プラットフォーム向けの急速充電バッテリーシステムの開発を行っています。両社によると、この革新により、ロボットは1日あたり20時間以上稼働すること
 Apple iOS 27 アップデート:Siri、ChatGPT 無償切替機能付きのデュアルモード時代へ突入
iOS 27では、Siriのアーキテクチャに根本的な見直しが行われ、従来の音声のみによる対話を超えた、新しいスタンドアロンアプリケーションを中心に据えています。チャットボットインターフェースを備えたこのアプリは、ユーザーがプロンプトを入力してシームレスなAI会話を行うことを可能にします。画像やドキュメントのアップロードをサポートし、チャット履歴を保持し、複雑なマルチステップタスクを簡素化します。Appleは、ネイティブのSiriとChatGPTなどのサードパーティ製モデルを切り替えることをユーザ

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉












