


 Heim
Tsinghua und Tencent Hunyuan gewinnen die „MLSys2026 MoE Inference Challenge“ mit einer 4,1-fachen Beschleunigung der NPU
Das Storage Lab der Tsinghua-Universität und das MegEngine AI Infra-Team von Tencent haben kürzlich den Weltmeistertitel bei der „MoE Model Inference Optimization Challenge“ im Rahmen der MLSys2026, einer führenden Konferenz für Machine-Learning-Systeme, errungen.
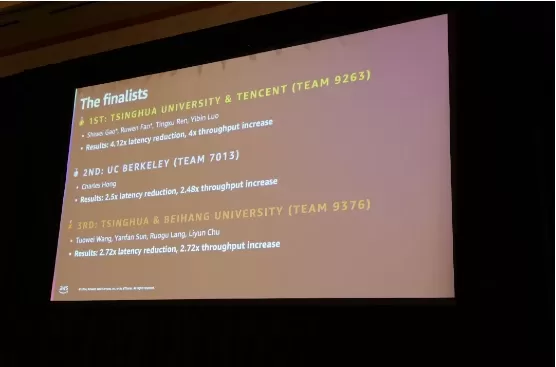
Um Leistungsengpässe bei der Inferenz in der „Mixture-of-Experts“-Architektur (MoE) mit Parametern im Billionenbereich zu beseitigen, die auf heterogenen NPU-Chips laufen, entwickelte das gemeinsame Team eine ganzheitliche Optimierungslösung für das offizielle Modell und die NPU-Hardware. Durch den Einsatz der E-Shard-Strategie zur Aufgabenteilung auf Expertenebene, des PSUM-3D-Tensor-Batch-Readouts, des GEMV-Pfads zur Verteilung der Ausgaben auf mehrere Bänke zur Gewährleistung von Parallelität sowie der Verwendung von Skalar-Engines zur Reduzierung der anfänglichen Datenübertragungslatenz gelang es ihnen, die geringe Datenübertragungseffizienz und wiederholte Aktivierungsübertragungen auf Operatorenebene erfolgreich zu beheben.
Parallel dazu reorganisierte das Team das On-Chip-Datenlayout für das Attention-Modul und integrierte zentrale Transformer-Operatoren, wodurch eine hochpräzise Ausrichtung auf Bit-Ebene erreicht wurde.
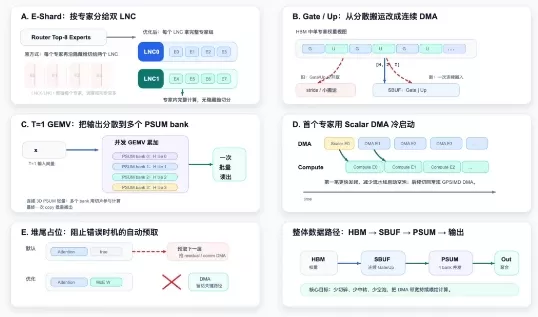
Abbildung 3: Schematische Darstellung der MoE-Optimierungsarchitektur mit E-Shard-Expertenpartitionierung, kontinuierlichem DMA, PSUM/GEMV-Parallelität, Cold-Start-Pipeline und Prefetch-Steuerung.
Darüber hinaus entwickelte das Team einen agentenbasierten Optimierer für Inferenzoperatoren namens „Knight“. Durch einen automatisierten Closed-Loop-Prozess aus Vorschlag, Code-Implementierung und Iteration wurde der Suchraum für die Optimierung drastisch erweitert. Infolgedessen sank die End-to-End-Inferenzzeit von 14,91 Sekunden auf 3,56 Sekunden, was einer 4,1-fachen Beschleunigung entspricht; die Latenz bei der Einzelschritt-Dekodierung sank von 12,63 ms auf 5,45 ms, und die Auslastung der DMA-Engine beim Laden der Gewichte stieg auf rund 80 % an.
Diese Leistung, mit der Teams von weltweit führenden Universitäten wie Stanford und dem MIT übertroffen wurden, unterstreicht die fundierte Expertise chinesischer Teams bei der Anpassung großer Modelle an zugrunde liegende Systeme und der Optimierung von Operatoren. Sie liefert zudem einen wertvollen technischen Leitfaden für den Einsatz von MoE-Modellen mit Billionen von Parametern auf zukünftigen Super-Node-Rechenplattformen.
Verwandter Artikel
 Anthropic innerhalb einer Woche von zwei großen Datenlecks getroffen, was das Vertrauen in die Sicherheitsbehauptungen seiner KI erschüttert
Anthropic, der als KI-Pionier für seinen Fokus auf Sicherheit und Vorsicht anerkannt ist, hat in der Tech-Branche kürzlich für Aufregung gesorgt. Nach der versehentlichen Veröffentlichung von 3.000 internen Dokumenten letzte Woche beging das Unterneh
Agility Robotics wählt Nyobolt für das Schnellladen des Digit 5 Humanoiden
Nyobolt liefert Schnellladetechnologie und langlebige Batterielösungen für Digit 5. Quelle: AgilityDas Energiemanagement bleibt eine kritische Hürde für Entwickler humanoider Roboter. Agility Robotics Inc. hat eine Zusammenarbeit mit Nyobolt angekünd
Apple iOS 27 Update: Siri tritt in das Zeitalter des Dual-Modus ein, mit kostenlosem Wechsel zu ChatGPT
iOS 27 führt eine grundlegende Überarbeitung der Siri-Architektur ein, die auf einer neuen, eigenständigen Anwendung basiert und über traditionelle rein sprachbasierte Interaktionen hinausgeht.Die App ist mit einer Chatbot-Schnittstelle gestaltet und
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (1)
![BrianMartinez]()
That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉
Das Storage Lab der Tsinghua-Universität und das MegEngine AI Infra-Team von Tencent haben kürzlich den Weltmeistertitel bei der „MoE Model Inference Optimization Challenge“ im Rahmen der MLSys2026, einer führenden Konferenz für Machine-Learning-Systeme, errungen.
Um Leistungsengpässe bei der Inferenz in der „Mixture-of-Experts“-Architektur (MoE) mit Parametern im Billionenbereich zu beseitigen, die auf heterogenen NPU-Chips laufen, entwickelte das gemeinsame Team eine ganzheitliche Optimierungslösung für das offizielle Modell und die NPU-Hardware. Durch den Einsatz der E-Shard-Strategie zur Aufgabenteilung auf Expertenebene, des PSUM-3D-Tensor-Batch-Readouts, des GEMV-Pfads zur Verteilung der Ausgaben auf mehrere Bänke zur Gewährleistung von Parallelität sowie der Verwendung von Skalar-Engines zur Reduzierung der anfänglichen Datenübertragungslatenz gelang es ihnen, die geringe Datenübertragungseffizienz und wiederholte Aktivierungsübertragungen auf Operatorenebene erfolgreich zu beheben.
Parallel dazu reorganisierte das Team das On-Chip-Datenlayout für das Attention-Modul und integrierte zentrale Transformer-Operatoren, wodurch eine hochpräzise Ausrichtung auf Bit-Ebene erreicht wurde.
Abbildung 3: Schematische Darstellung der MoE-Optimierungsarchitektur mit E-Shard-Expertenpartitionierung, kontinuierlichem DMA, PSUM/GEMV-Parallelität, Cold-Start-Pipeline und Prefetch-Steuerung.
Darüber hinaus entwickelte das Team einen agentenbasierten Optimierer für Inferenzoperatoren namens „Knight“. Durch einen automatisierten Closed-Loop-Prozess aus Vorschlag, Code-Implementierung und Iteration wurde der Suchraum für die Optimierung drastisch erweitert. Infolgedessen sank die End-to-End-Inferenzzeit von 14,91 Sekunden auf 3,56 Sekunden, was einer 4,1-fachen Beschleunigung entspricht; die Latenz bei der Einzelschritt-Dekodierung sank von 12,63 ms auf 5,45 ms, und die Auslastung der DMA-Engine beim Laden der Gewichte stieg auf rund 80 % an.
Diese Leistung, mit der Teams von weltweit führenden Universitäten wie Stanford und dem MIT übertroffen wurden, unterstreicht die fundierte Expertise chinesischer Teams bei der Anpassung großer Modelle an zugrunde liegende Systeme und der Optimierung von Operatoren. Sie liefert zudem einen wertvollen technischen Leitfaden für den Einsatz von MoE-Modellen mit Billionen von Parametern auf zukünftigen Super-Node-Rechenplattformen.








 Anthropic innerhalb einer Woche von zwei großen Datenlecks getroffen, was das Vertrauen in die Sicherheitsbehauptungen seiner KI erschüttert
Anthropic, der als KI-Pionier für seinen Fokus auf Sicherheit und Vorsicht anerkannt ist, hat in der Tech-Branche kürzlich für Aufregung gesorgt. Nach der versehentlichen Veröffentlichung von 3.000 internen Dokumenten letzte Woche beging das Unterneh
Agility Robotics wählt Nyobolt für das Schnellladen des Digit 5 Humanoiden
Nyobolt liefert Schnellladetechnologie und langlebige Batterielösungen für Digit 5. Quelle: AgilityDas Energiemanagement bleibt eine kritische Hürde für Entwickler humanoider Roboter. Agility Robotics Inc. hat eine Zusammenarbeit mit Nyobolt angekünd
 Apple iOS 27 Update: Siri tritt in das Zeitalter des Dual-Modus ein, mit kostenlosem Wechsel zu ChatGPT
iOS 27 führt eine grundlegende Überarbeitung der Siri-Architektur ein, die auf einer neuen, eigenständigen Anwendung basiert und über traditionelle rein sprachbasierte Interaktionen hinausgeht.Die App ist mit einer Chatbot-Schnittstelle gestaltet und

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉












