


 Hogar
Tsinghua y Tencent Hunyuan ganan el MoE Inference Challenge de MLSys2026 con una aceleración de 4,1 veces en la NPU
El Laboratorio de Almacenamiento de la Universidad de Tsinghua y el equipo de infraestructura de IA MegEngine de Tencent se han proclamado recientemente campeones mundiales en el «MoE Model Inference Optimization Challenge» celebrado en MLSys2026, una de las principales conferencias sobre sistemas de aprendizaje automático.
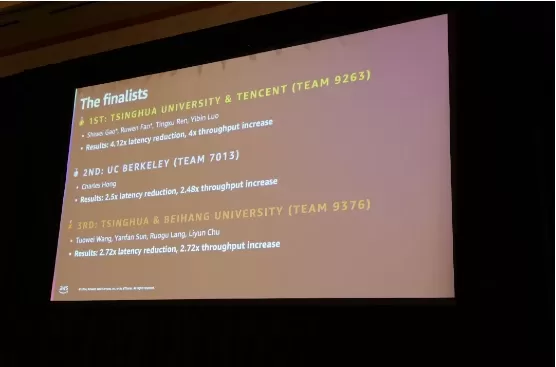
Para abordar los cuellos de botella en el rendimiento de la inferencia en la arquitectura «mezcla de expertos» (MoE), con parámetros a escala de billones que se ejecutan en chips NPU heterogéneos, el equipo conjunto diseñó una solución de optimización de cadena completa para el modelo oficial y el hardware NPU. Mediante el empleo de la estrategia E-Shard para la partición de tareas a nivel de experto, la lectura por lotes de tensores 3D PSUM, la ruta GEMV que distribuye las salidas entre múltiples bancos para lograr la concurrencia, y el uso de motores escalares para reducir la latencia inicial en la transferencia de datos, lograron resolver con éxito la baja eficiencia en la transferencia de datos y las transferencias repetidas de activación a nivel de operador.
Paralelamente, el equipo reorganizó la disposición de los datos en el chip para el módulo de atención e integró los operadores Transformer básicos, logrando una alineación de alta precisión a nivel de bits.
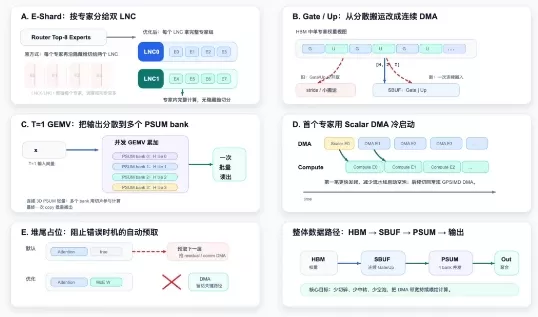
Figura 3: Diagrama de la arquitectura de optimización MoE, que incluye la partición experta E-Shard, DMA continuo, concurrencia PSUM/GEMV, canal de arranque en frío y control de precarga.
Además, el equipo desarrolló un optimizador de operadores de inferencia basado en agentes denominado «Knight». Mediante un proceso automatizado de bucle cerrado que incluye propuesta, implementación de código e iteración, amplió drásticamente el espacio de búsqueda de optimización. Como resultado, el tiempo de inferencia de extremo a extremo se redujo de 14,91 segundos a 3,56 segundos, lo que supone una aceleración de 4,1 veces; la latencia de decodificación en un solo paso se redujo de 12,63 ms a 5,45 ms, y la utilización del motor DMA durante la carga de pesos ascendió a alrededor del 80 %.
Al superar a equipos de universidades líderes a nivel mundial, como Stanford y el MIT, este logro pone de relieve la profunda experiencia de los equipos chinos a la hora de adaptar modelos de gran tamaño a los sistemas subyacentes y optimizar los operadores. Además, proporciona un valioso modelo de ingeniería para el despliegue de modelos MoE con billones de parámetros en futuras plataformas informáticas de supernodos.
Artículo relacionado
 Anthropic se ve afectada por dos grandes filtraciones de datos en una semana, lo que sacude la confianza en sus afirmaciones sobre la seguridad de la IA
Anthropic, líder de la inteligencia artificial reconocido por su énfasis en la seguridad y la precaución, ha causado recientemente un gran revuelo en el sector tecnológico. Tras la publicación accidental de 3.000 documentos internos la semana pasada,
Agility Robotics selecciona a Nyobolt para la carga rápida del robot humanoide Digit 5
Nyobolt proporciona tecnología de baterías de carga rápida y larga duración para Digit 5. Fuente: AgilityLa gestión de la energía sigue siendo un obstáculo crítico para los desarrolladores de robots humanoides. Agility Robotics Inc. anunció una colab
Actualización de Apple iOS 27: Siri entra en la era de doble modo con cambio gratuito a ChatGPT
iOS 27 introduce una revisión fundamental de la arquitectura de Siri, centrada en una nueva aplicación independiente que va más allá de las interacciones tradicionales solo por voz.Diseñada con una interfaz de chatbot, la aplicación permite a los usu
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (1)
0/500
![BrianMartinez]()
That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉
El Laboratorio de Almacenamiento de la Universidad de Tsinghua y el equipo de infraestructura de IA MegEngine de Tencent se han proclamado recientemente campeones mundiales en el «MoE Model Inference Optimization Challenge» celebrado en MLSys2026, una de las principales conferencias sobre sistemas de aprendizaje automático.
Para abordar los cuellos de botella en el rendimiento de la inferencia en la arquitectura «mezcla de expertos» (MoE), con parámetros a escala de billones que se ejecutan en chips NPU heterogéneos, el equipo conjunto diseñó una solución de optimización de cadena completa para el modelo oficial y el hardware NPU. Mediante el empleo de la estrategia E-Shard para la partición de tareas a nivel de experto, la lectura por lotes de tensores 3D PSUM, la ruta GEMV que distribuye las salidas entre múltiples bancos para lograr la concurrencia, y el uso de motores escalares para reducir la latencia inicial en la transferencia de datos, lograron resolver con éxito la baja eficiencia en la transferencia de datos y las transferencias repetidas de activación a nivel de operador.
Paralelamente, el equipo reorganizó la disposición de los datos en el chip para el módulo de atención e integró los operadores Transformer básicos, logrando una alineación de alta precisión a nivel de bits.
Figura 3: Diagrama de la arquitectura de optimización MoE, que incluye la partición experta E-Shard, DMA continuo, concurrencia PSUM/GEMV, canal de arranque en frío y control de precarga.
Además, el equipo desarrolló un optimizador de operadores de inferencia basado en agentes denominado «Knight». Mediante un proceso automatizado de bucle cerrado que incluye propuesta, implementación de código e iteración, amplió drásticamente el espacio de búsqueda de optimización. Como resultado, el tiempo de inferencia de extremo a extremo se redujo de 14,91 segundos a 3,56 segundos, lo que supone una aceleración de 4,1 veces; la latencia de decodificación en un solo paso se redujo de 12,63 ms a 5,45 ms, y la utilización del motor DMA durante la carga de pesos ascendió a alrededor del 80 %.
Al superar a equipos de universidades líderes a nivel mundial, como Stanford y el MIT, este logro pone de relieve la profunda experiencia de los equipos chinos a la hora de adaptar modelos de gran tamaño a los sistemas subyacentes y optimizar los operadores. Además, proporciona un valioso modelo de ingeniería para el despliegue de modelos MoE con billones de parámetros en futuras plataformas informáticas de supernodos.








 Anthropic se ve afectada por dos grandes filtraciones de datos en una semana, lo que sacude la confianza en sus afirmaciones sobre la seguridad de la IA
Anthropic, líder de la inteligencia artificial reconocido por su énfasis en la seguridad y la precaución, ha causado recientemente un gran revuelo en el sector tecnológico. Tras la publicación accidental de 3.000 documentos internos la semana pasada,
Agility Robotics selecciona a Nyobolt para la carga rápida del robot humanoide Digit 5
Nyobolt proporciona tecnología de baterías de carga rápida y larga duración para Digit 5. Fuente: AgilityLa gestión de la energía sigue siendo un obstáculo crítico para los desarrolladores de robots humanoides. Agility Robotics Inc. anunció una colab
 Actualización de Apple iOS 27: Siri entra en la era de doble modo con cambio gratuito a ChatGPT
iOS 27 introduce una revisión fundamental de la arquitectura de Siri, centrada en una nueva aplicación independiente que va más allá de las interacciones tradicionales solo por voz.Diseñada con una interfaz de chatbot, la aplicación permite a los usu

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉












