


 Lar
Tsinghua e Tencent Hunyuan vencem o Desafio de Inferência MoE do MLSys2026 com um aumento de velocidade de 4,1x na NPU
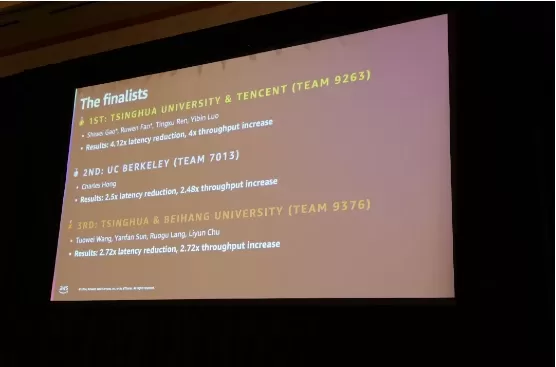
O Laboratório de Armazenamento da Universidade de Tsinghua e a equipe de infraestrutura de IA MegEngine da Tencent conquistaram recentemente o título de campeões mundiais no Desafio de Otimização de Inferência de Modelos MoE (Mixture of Experts) na MLSys2026, uma das principais conferências sobre sistemas de aprendizado de máquina.
Para superar os gargalos de desempenho na inferência na arquitetura “mixture-of-experts” (MoE) com parâmetros na escala de trilhões executados em chips NPU heterogêneos, a equipe conjunta projetou uma solução de otimização de cadeia completa para o modelo oficial e o hardware NPU. Ao empregar a estratégia E-Shard para o particionamento de tarefas em nível de especialista, a leitura em lote de tensores 3D PSUM, o caminho GEMV que distribui saídas por vários bancos para garantir a concorrência e o uso de motores escalares para reduzir a latência inicial da transferência de dados, eles resolveram com sucesso a baixa eficiência na transferência de dados e as transferências repetidas de ativação no nível do operador.
Paralelamente, a equipe reorganizou o layout de dados no chip para o módulo de atenção e integrou os operadores principais do Transformer, alcançando um alinhamento de alta precisão no nível de bits.
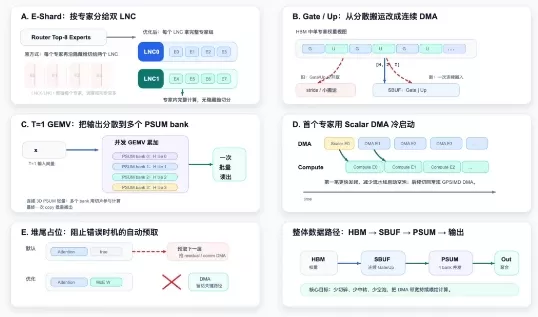
Figura 3: Diagrama da arquitetura de otimização MoE, apresentando particionamento especializado E-Shard, DMA contínuo, concorrência PSUM/GEMV, pipeline de partida a frio e controle de pré-busca.
Além disso, a equipe desenvolveu um otimizador de operadores de inferência baseado em agentes chamado “Knight”. Por meio de um processo automatizado de ciclo fechado de proposta, implementação de código e iteração, ele ampliou drasticamente o espaço de busca de otimização. Como resultado, o tempo de inferência de ponta a ponta caiu de 14,91 segundos para 3,56 segundos, um aumento de velocidade de 4,1 vezes; a latência de decodificação em uma única etapa caiu de 12,63 ms para 5,45 ms, e a utilização do mecanismo DMA durante o carregamento de pesos subiu para cerca de 80%.
Superando equipes de universidades líderes globais, como Stanford e o MIT, essa conquista destaca a profunda expertise das equipes chinesas na adaptação de grandes modelos aos sistemas subjacentes e na otimização de operadores. Ela também fornece um valioso plano de engenharia para a implantação de modelos MoE com trilhões de parâmetros em futuras plataformas de computação com supernós.
Artigo relacionado
 Anthropic é atingida por dois grandes vazamentos de dados em uma semana, abalando a confiança em suas alegações de segurança da IA
Anthropic, líder de IA reconhecida por sua ênfase na segurança e cautela, causou recentemente agitação no setor de tecnologia. Após a divulgação acidental de 3.000 documentos internos na semana passada, a empresa cometeu outro erro significativo nest
A Agility Robotics seleciona a Nyobolt para o carregamento rápido do humanoide Digit 5
A Nyobolt fornece tecnologia de bateria de carregamento rápido e longa duração para o Digit 5. Fonte: AgilityO gerenciamento de energia continua sendo um obstáculo crítico para os desenvolvedores de robôs humanoides. A Agility Robotics Inc. anunciou
Atualização do Apple iOS 27: Siri entra na era de modo duplo com alternância gratuita para ChatGPT
O iOS 27 introduz uma reformulação fundamental da arquitetura da Siri, centrada em um novo aplicativo independente que vai além das interações tradicionais apenas por voz.Projetado com uma interface de chatbot, o aplicativo permite que os usuários di
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
 10 ferramentas
 xix.ai
Educação e Aprendizagem
Os melhores professores particulares especializados em IA para preparação para exames: pratique matemática, ciências e inglês
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai
Financiar
Ferramentas de planejamento orçamentário com IA para gestão financeira pessoal
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai
Saúde e Bem-Estar
Assistentes de rastreamento do sono com IA: melhore sua recuperação adotando hábitos mais adequados antes de dormir
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai
Análise de dados
Copilotos de IA em SQL para análise de produtos e receitas
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai
Educação e Aprendizagem
Os melhores auxiliares de tarefas escolares com IA que ensinam: aprenda conceitos, não apenas respostas
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

 Comentários (1)
![BrianMartinez]()
That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉
O Laboratório de Armazenamento da Universidade de Tsinghua e a equipe de infraestrutura de IA MegEngine da Tencent conquistaram recentemente o título de campeões mundiais no Desafio de Otimização de Inferência de Modelos MoE (Mixture of Experts) na MLSys2026, uma das principais conferências sobre sistemas de aprendizado de máquina.
Para superar os gargalos de desempenho na inferência na arquitetura “mixture-of-experts” (MoE) com parâmetros na escala de trilhões executados em chips NPU heterogêneos, a equipe conjunta projetou uma solução de otimização de cadeia completa para o modelo oficial e o hardware NPU. Ao empregar a estratégia E-Shard para o particionamento de tarefas em nível de especialista, a leitura em lote de tensores 3D PSUM, o caminho GEMV que distribui saídas por vários bancos para garantir a concorrência e o uso de motores escalares para reduzir a latência inicial da transferência de dados, eles resolveram com sucesso a baixa eficiência na transferência de dados e as transferências repetidas de ativação no nível do operador.
Paralelamente, a equipe reorganizou o layout de dados no chip para o módulo de atenção e integrou os operadores principais do Transformer, alcançando um alinhamento de alta precisão no nível de bits.
Figura 3: Diagrama da arquitetura de otimização MoE, apresentando particionamento especializado E-Shard, DMA contínuo, concorrência PSUM/GEMV, pipeline de partida a frio e controle de pré-busca.
Além disso, a equipe desenvolveu um otimizador de operadores de inferência baseado em agentes chamado “Knight”. Por meio de um processo automatizado de ciclo fechado de proposta, implementação de código e iteração, ele ampliou drasticamente o espaço de busca de otimização. Como resultado, o tempo de inferência de ponta a ponta caiu de 14,91 segundos para 3,56 segundos, um aumento de velocidade de 4,1 vezes; a latência de decodificação em uma única etapa caiu de 12,63 ms para 5,45 ms, e a utilização do mecanismo DMA durante o carregamento de pesos subiu para cerca de 80%.
Superando equipes de universidades líderes globais, como Stanford e o MIT, essa conquista destaca a profunda expertise das equipes chinesas na adaptação de grandes modelos aos sistemas subjacentes e na otimização de operadores. Ela também fornece um valioso plano de engenharia para a implantação de modelos MoE com trilhões de parâmetros em futuras plataformas de computação com supernós.








 Anthropic é atingida por dois grandes vazamentos de dados em uma semana, abalando a confiança em suas alegações de segurança da IA
Anthropic, líder de IA reconhecida por sua ênfase na segurança e cautela, causou recentemente agitação no setor de tecnologia. Após a divulgação acidental de 3.000 documentos internos na semana passada, a empresa cometeu outro erro significativo nest
A Agility Robotics seleciona a Nyobolt para o carregamento rápido do humanoide Digit 5
A Nyobolt fornece tecnologia de bateria de carregamento rápido e longa duração para o Digit 5. Fonte: AgilityO gerenciamento de energia continua sendo um obstáculo crítico para os desenvolvedores de robôs humanoides. A Agility Robotics Inc. anunciou
 Atualização do Apple iOS 27: Siri entra na era de modo duplo com alternância gratuita para ChatGPT
O iOS 27 introduz uma reformulação fundamental da arquitetura da Siri, centrada em um novo aplicativo independente que vai além das interações tradicionais apenas por voz.Projetado com uma interface de chatbot, o aplicativo permite que os usuários di

As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
10 ferramentas
xix.ai

Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
11 ferramentas
xix.ai

2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
10 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
14 ferramentas
xix.ai

2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
10 ferramentas
xix.ai

That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉












