


 Maison
Tsinghua et Tencent Hunyuan remportent le concours « MoE Inference Challenge » de MLSys2026 avec un gain de vitesse de 4,1 fois sur les NPU
Le laboratoire de stockage de l’université de Tsinghua et l’équipe MegEngine AI Infra de Tencent ont récemment remporté le championnat mondial du « MoE Model Inference Optimization Challenge » lors de MLSys2026, une conférence de premier plan consacrée aux systèmes d’apprentissage automatique.
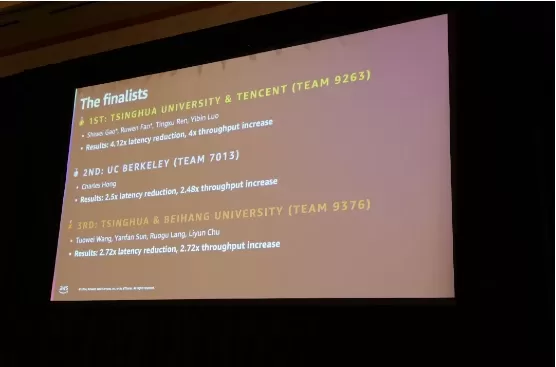
Afin de remédier aux goulots d’étranglement affectant les performances d’inférence dans l’architecture « mixture-of-experts » (MoE), qui comporte des paramètres à l’échelle des billions et s’exécute sur des puces NPU hétérogènes, l’équipe conjointe a conçu une solution d’optimisation de bout en bout pour le modèle officiel et le matériel NPU. En recourant à la stratégie E-Shard pour le partitionnement des tâches au niveau des experts, à la lecture par lots de tenseurs 3D PSUM, au chemin GEMV distribuant les sorties sur plusieurs banques pour assurer la concurrence, et en utilisant des moteurs scalaires pour réduire la latence initiale du transfert de données, elle a réussi à résoudre les problèmes de faible efficacité du transfert de données et de transferts d’activation répétés au niveau des opérateurs.
Parallèlement, l’équipe a réorganisé la disposition des données sur la puce pour le module d’attention et les opérateurs Transformer de base, parvenant ainsi à un alignement de haute précision au niveau des bits.
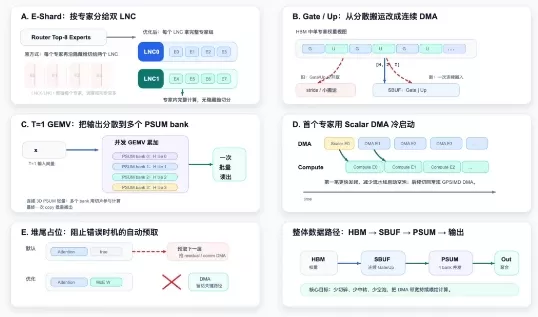
Figure 3 : Schéma de l’architecture d’optimisation MoE, comprenant le partitionnement expert E-Shard, le DMA continu, la concurrence PSUM/GEMV, le pipeline de démarrage à froid et le contrôle de prélecture.
De plus, l’équipe a développé un optimiseur d’opérateurs d’inférence basé sur des agents, baptisé « Knight ». Grâce à un processus automatisé en boucle fermée comprenant la formulation de propositions, l’implémentation du code et l’itération, cet outil a considérablement élargi l’espace de recherche d’optimisation. En conséquence, le temps d’inférence de bout en bout est passé de 14,91 secondes à 3,56 secondes, soit un gain de vitesse de 4,1 fois ; la latence de décodage en une seule étape est passée de 12,63 ms à 5,45 ms, et l’utilisation du moteur DMA lors du chargement des poids a grimpé à environ 80 %.
Surpassant des équipes issues d’universités mondiales de premier plan telles que Stanford et le MIT, cette réussite met en évidence la grande expertise des équipes chinoises dans l’adaptation de modèles de grande taille aux systèmes sous-jacents et dans l’optimisation des opérateurs. Elle fournit également un précieux modèle d’ingénierie pour le déploiement de modèles MoE comportant des milliers de milliards de paramètres sur les futures plateformes de calcul à super-nœuds.
Article connexe
 Anthropic touchée par deux importantes fuites de données en l’espace d’une semaine, ce qui ébranle la confiance dans ses affirmations en matière de sécurité de l’IA
Anthropic, leader de l’IA reconnu pour son accent mis sur la sécurité et la prudence, a récemment provoqué un tollé dans le secteur technologique. Suite à la divulgation accidentelle de 3 000 documents internes la semaine dernière, l’entreprise a com
Agility Robotics sélectionne Nyobolt pour la charge rapide du robot humanoïde Digit 5
Nyobolt fournit une technologie de batterie à charge rapide et longue durée pour Digit 5. Source : AgilityLa gestion de l’énergie reste un obstacle critique pour les développeurs de robots humanoïdes. Agility Robotics Inc. a annoncé une collaboration
Mise à jour Apple iOS 27 : Siri entre dans l'ère du mode double avec un basculement gratuit vers ChatGPT
iOS 27 introduit une refonte fondamentale de l’architecture de Siri, centrée sur une nouvelle application autonome qui va au-delà des interactions vocales traditionnelles.Conçue avec une interface de chatbot, l’application permet aux utilisateurs de
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (1)
![BrianMartinez]()
That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉
Le laboratoire de stockage de l’université de Tsinghua et l’équipe MegEngine AI Infra de Tencent ont récemment remporté le championnat mondial du « MoE Model Inference Optimization Challenge » lors de MLSys2026, une conférence de premier plan consacrée aux systèmes d’apprentissage automatique.
Afin de remédier aux goulots d’étranglement affectant les performances d’inférence dans l’architecture « mixture-of-experts » (MoE), qui comporte des paramètres à l’échelle des billions et s’exécute sur des puces NPU hétérogènes, l’équipe conjointe a conçu une solution d’optimisation de bout en bout pour le modèle officiel et le matériel NPU. En recourant à la stratégie E-Shard pour le partitionnement des tâches au niveau des experts, à la lecture par lots de tenseurs 3D PSUM, au chemin GEMV distribuant les sorties sur plusieurs banques pour assurer la concurrence, et en utilisant des moteurs scalaires pour réduire la latence initiale du transfert de données, elle a réussi à résoudre les problèmes de faible efficacité du transfert de données et de transferts d’activation répétés au niveau des opérateurs.
Parallèlement, l’équipe a réorganisé la disposition des données sur la puce pour le module d’attention et les opérateurs Transformer de base, parvenant ainsi à un alignement de haute précision au niveau des bits.
Figure 3 : Schéma de l’architecture d’optimisation MoE, comprenant le partitionnement expert E-Shard, le DMA continu, la concurrence PSUM/GEMV, le pipeline de démarrage à froid et le contrôle de prélecture.
De plus, l’équipe a développé un optimiseur d’opérateurs d’inférence basé sur des agents, baptisé « Knight ». Grâce à un processus automatisé en boucle fermée comprenant la formulation de propositions, l’implémentation du code et l’itération, cet outil a considérablement élargi l’espace de recherche d’optimisation. En conséquence, le temps d’inférence de bout en bout est passé de 14,91 secondes à 3,56 secondes, soit un gain de vitesse de 4,1 fois ; la latence de décodage en une seule étape est passée de 12,63 ms à 5,45 ms, et l’utilisation du moteur DMA lors du chargement des poids a grimpé à environ 80 %.
Surpassant des équipes issues d’universités mondiales de premier plan telles que Stanford et le MIT, cette réussite met en évidence la grande expertise des équipes chinoises dans l’adaptation de modèles de grande taille aux systèmes sous-jacents et dans l’optimisation des opérateurs. Elle fournit également un précieux modèle d’ingénierie pour le déploiement de modèles MoE comportant des milliers de milliards de paramètres sur les futures plateformes de calcul à super-nœuds.








 Anthropic touchée par deux importantes fuites de données en l’espace d’une semaine, ce qui ébranle la confiance dans ses affirmations en matière de sécurité de l’IA
Anthropic, leader de l’IA reconnu pour son accent mis sur la sécurité et la prudence, a récemment provoqué un tollé dans le secteur technologique. Suite à la divulgation accidentelle de 3 000 documents internes la semaine dernière, l’entreprise a com
Agility Robotics sélectionne Nyobolt pour la charge rapide du robot humanoïde Digit 5
Nyobolt fournit une technologie de batterie à charge rapide et longue durée pour Digit 5. Source : AgilityLa gestion de l’énergie reste un obstacle critique pour les développeurs de robots humanoïdes. Agility Robotics Inc. a annoncé une collaboration
 Mise à jour Apple iOS 27 : Siri entre dans l'ère du mode double avec un basculement gratuit vers ChatGPT
iOS 27 introduit une refonte fondamentale de l’architecture de Siri, centrée sur une nouvelle application autonome qui va au-delà des interactions vocales traditionnelles.Conçue avec une interface de chatbot, l’application permet aux utilisateurs de

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

That's a massive leap! 4.1x NPU speedup for MoE inference? I'm curious about the techniques they used. Is it better quantization or sparse attention? Either way, congrats to the team! 🎉












