


 家
「Tongyi Qianwen Qwen-Audio-3.0-TTS」が、初回パケット遅延300ミリ秒、20の方言に対応してサービス開始
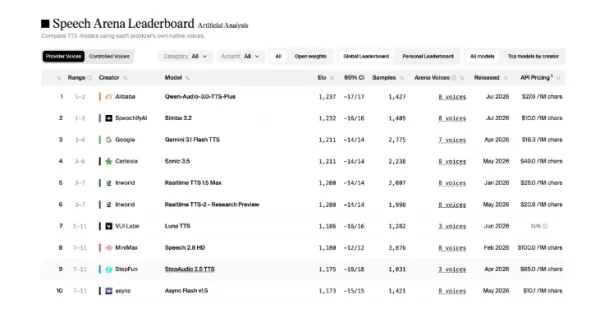
アリババのQwenチームは、新しいリアルタイム音声合成モデル「Qwen-Audio-3.0-TTS」をリリースし、音声合成を単なる生成から真の表現へと進化させました。 Plusバージョンは、Artificial Analysisが提供する権威あるベンチマーク「Speech Arena」において世界1位を獲得し、Gemini 3.1 TTSやElevenLabs v3をはじめとする主要モデルを上回る性能を示しています。
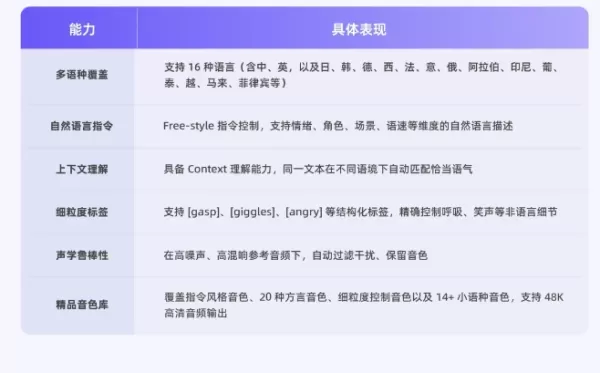
2つのバージョンが利用可能です。「Flash」バージョンはリアルタイムの対話に対応し、初期レイテンシは約300msで、スマートアシスタントやその他の低レイテンシが求められるユースケースに最適です。「Plus」バージョンは高品質な生成を優先し、自然さと声の類似性を向上させています。
中核機能における4つの重要なブレークスルー:
第一に、多言語および方言のサポートが16言語に拡大され、Plusバージョンでは全16言語において平均82.75%の話し手類似度を達成しており、これは業界最高水準です。また、20の中国方言をカバーしており、方言の特徴を弱めることなく忠実に再現することで、よりネイティブに近い表現を実現しています。
第二に、柔軟な自然言語による指示機能により、ユーザーは「丁寧なカスタマーサービスの口調」や「ライブ配信の司会者スタイル」といったプロンプトを使って、専門的なアノテーションを必要とせずに正確な音声を生成できます。
第三に、きめ細かなタグ制御により、[gasp]や[angry]といった構造化されたタグをサポートし、呼吸や笑い声といった非言語的な詳細を精密に管理できます。これはゲームやオーディオブック、および同様のシナリオに適しています。
第四に、優れた音響的堅牢性を備えています。参照音声に高いノイズや残響が含まれていても、モデルは音声品質を維持しつつ背景ノイズを自動的に除去し、安定した合成出力を保証します。
付属のプレミアム音声ライブラリには、指示音声、方言、あまり使われない言語など、さまざまな音声タイプが含まれており、48Kの高解像度音声出力に対応(7月24日に公開予定)し、1回のセッションで最大3分間の長文を合成可能です。 このモデルは現在、Alibaba Cloud BaiLianプラットフォームで全面的に利用可能となっており、開発者はアクセスして試用することができ、音声インタラクションに新たな可能性を切り開いています。
関連記事
 Qwen3.5-Max PreviewがLMArenaでトップに立ち、中国のAIモデルが世界の最前列に到達
3月20日、権威ある大規模モデル盲検プラットフォームLMArenaの最新ランキングが公開され、アリババのQwenシリーズにおける最新フラッグシッププレビューモデルQwen3.5-Max-Previewが卓越したパフォーマンスを示したことが明らかになった。スコアは1464点で、トップクラスの位置を確保した。この成果は、国内モデルの過去の記録を塗り替えるだけでなく、GPT5.4、Claude4.5、Grok4.1といった主要な海外モデルを複数の次元で上回るものであった。このマイルストーンは、中国の独
Marc Benioffが支援するスタートアップ、AI導入の課題解決を目指す
大企業は信頼性の高いAIツールの導入において極めて厳しい課題に直面しており、そのギャップを埋めるために、顧客企業に組み込まれてAIシステムの運用化を担当する専門家の「フォワード・デプロイされたエンジニア」チームが台頭している。「皮肉なことに、AIはプロフェッショナルサービスへの需要を増大させています」と、先月月曜にステルスモードを解除した新会社「June」の創業者で元セールスフォース執行役員のエフラット・ラポポートは指摘する。「業界のAI統合に対する解決策は、単により多くの人材を採用することで
アリビデオ、Wan3.0を発表:超長編動画の生成と多次元の一貫性を実現
8月24日、アリババは最新の動画生成大規模モデル「Wan3.0」を発表しました。このリリースはアリババの動画技術における大きな飛躍を表しており、動画の長さ、汎用的な作成能力、参照画像の扱い、そして現実的な世界シミュレーションにおいて顕著な改善をもたらしました。Wan3.0は、単一の動画生成を最大30秒まで延長し、1つのショット内でより豊かな物語の可能性を提供します。また、doc、xls、ppt、pdf、mdなど主要なファイル形式のサポートを導入し、テキスト、表、スライドを動的な視覚コンテンツに直
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (0)
0/500
アリババのQwenチームは、新しいリアルタイム音声合成モデル「Qwen-Audio-3.0-TTS」をリリースし、音声合成を単なる生成から真の表現へと進化させました。 Plusバージョンは、Artificial Analysisが提供する権威あるベンチマーク「Speech Arena」において世界1位を獲得し、Gemini 3.1 TTSやElevenLabs v3をはじめとする主要モデルを上回る性能を示しています。
2つのバージョンが利用可能です。「Flash」バージョンはリアルタイムの対話に対応し、初期レイテンシは約300msで、スマートアシスタントやその他の低レイテンシが求められるユースケースに最適です。「Plus」バージョンは高品質な生成を優先し、自然さと声の類似性を向上させています。
中核機能における4つの重要なブレークスルー:
第一に、多言語および方言のサポートが16言語に拡大され、Plusバージョンでは全16言語において平均82.75%の話し手類似度を達成しており、これは業界最高水準です。また、20の中国方言をカバーしており、方言の特徴を弱めることなく忠実に再現することで、よりネイティブに近い表現を実現しています。
第二に、柔軟な自然言語による指示機能により、ユーザーは「丁寧なカスタマーサービスの口調」や「ライブ配信の司会者スタイル」といったプロンプトを使って、専門的なアノテーションを必要とせずに正確な音声を生成できます。
第三に、きめ細かなタグ制御により、[gasp]や[angry]といった構造化されたタグをサポートし、呼吸や笑い声といった非言語的な詳細を精密に管理できます。これはゲームやオーディオブック、および同様のシナリオに適しています。
第四に、優れた音響的堅牢性を備えています。参照音声に高いノイズや残響が含まれていても、モデルは音声品質を維持しつつ背景ノイズを自動的に除去し、安定した合成出力を保証します。
付属のプレミアム音声ライブラリには、指示音声、方言、あまり使われない言語など、さまざまな音声タイプが含まれており、48Kの高解像度音声出力に対応(7月24日に公開予定)し、1回のセッションで最大3分間の長文を合成可能です。 このモデルは現在、Alibaba Cloud BaiLianプラットフォームで全面的に利用可能となっており、開発者はアクセスして試用することができ、音声インタラクションに新たな可能性を切り開いています。








 Qwen3.5-Max PreviewがLMArenaでトップに立ち、中国のAIモデルが世界の最前列に到達
3月20日、権威ある大規模モデル盲検プラットフォームLMArenaの最新ランキングが公開され、アリババのQwenシリーズにおける最新フラッグシッププレビューモデルQwen3.5-Max-Previewが卓越したパフォーマンスを示したことが明らかになった。スコアは1464点で、トップクラスの位置を確保した。この成果は、国内モデルの過去の記録を塗り替えるだけでなく、GPT5.4、Claude4.5、Grok4.1といった主要な海外モデルを複数の次元で上回るものであった。このマイルストーンは、中国の独
 Marc Benioffが支援するスタートアップ、AI導入の課題解決を目指す
大企業は信頼性の高いAIツールの導入において極めて厳しい課題に直面しており、そのギャップを埋めるために、顧客企業に組み込まれてAIシステムの運用化を担当する専門家の「フォワード・デプロイされたエンジニア」チームが台頭している。「皮肉なことに、AIはプロフェッショナルサービスへの需要を増大させています」と、先月月曜にステルスモードを解除した新会社「June」の創業者で元セールスフォース執行役員のエフラット・ラポポートは指摘する。「業界のAI統合に対する解決策は、単により多くの人材を採用することで
 アリビデオ、Wan3.0を発表:超長編動画の生成と多次元の一貫性を実現
8月24日、アリババは最新の動画生成大規模モデル「Wan3.0」を発表しました。このリリースはアリババの動画技術における大きな飛躍を表しており、動画の長さ、汎用的な作成能力、参照画像の扱い、そして現実的な世界シミュレーションにおいて顕著な改善をもたらしました。Wan3.0は、単一の動画生成を最大30秒まで延長し、1つのショット内でより豊かな物語の可能性を提供します。また、doc、xls、ppt、pdf、mdなど主要なファイル形式のサポートを導入し、テキスト、表、スライドを動的な視覚コンテンツに直

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai












