


 Hogar
Tongyi Qianwen Qwen-Audio-3.0-TTS entra en funcionamiento con un retraso del primer paquete de 300 ms y 20 dialectos
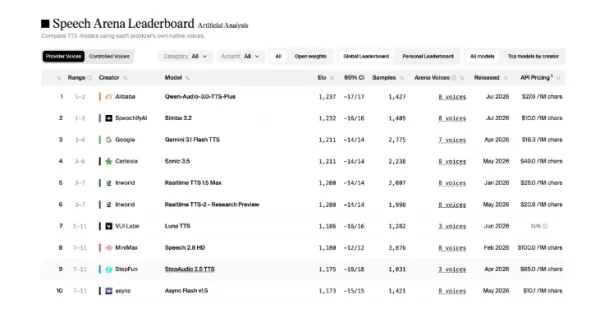
El equipo de Alibaba Qwen ha lanzado el nuevo modelo de síntesis de voz en tiempo real Qwen-Audio-3.0-TTS, lo que supone un avance que lleva la síntesis de voz de la generación básica a la verdadera expresión. La versión Plus ocupa ahora el primer puesto a nivel mundial en Speech Arena, un prestigioso banco de pruebas de Artificial Analysis, superando a Gemini 3.1 TTS, ElevenLabs v3 y otros modelos importantes.
Hay dos versiones disponibles: la versión Flash está pensada para la interacción en tiempo real, con una latencia inicial de unos 300 ms, ideal para asistentes inteligentes y otros casos de uso que requieren baja latencia; la versión Plus da prioridad a la generación de alta calidad, ofreciendo una mayor naturalidad y similitud vocal.
Cuatro avances clave en las capacidades principales:
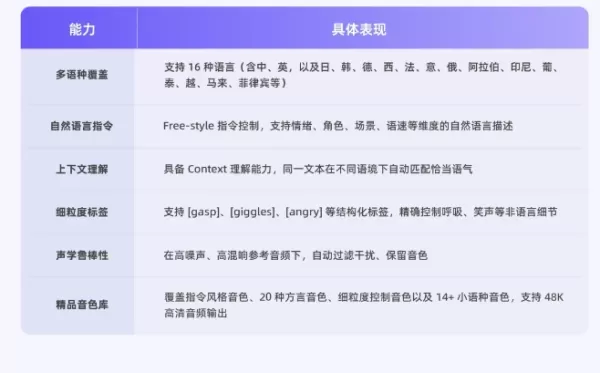
En primer lugar, la compatibilidad multilingüe y con dialectos se ha ampliado a 16 idiomas, y la versión Plus alcanza una similitud media con el hablante del 82,75 % en los 16 idiomas, la más alta del sector. También abarca 20 dialectos chinos, manteniendo las características auténticas de los dialectos en lugar de atenuarlas, lo que permite expresiones más parecidas a las de un nativo.
En segundo lugar, las instrucciones flexibles en lenguaje natural permiten a los usuarios generar voz precisa con indicaciones como «tono amable de atención al cliente» o «estilo de presentador de retransmisión en directo», sin necesidad de anotaciones profesionales.
En tercer lugar, el control detallado de etiquetas admite etiquetas estructuradas como [jadeo] y [enfadado], lo que permite una gestión precisa de detalles no verbales como la respiración y la risa —ideal para videojuegos, audiolibros y situaciones similares—.
En cuarto lugar, una gran robustez acústica: incluso si el audio de referencia contiene mucho ruido o reverberación, el modelo filtra automáticamente el ruido de fondo al tiempo que conserva la calidad de la voz, lo que garantiza una salida de síntesis estable.
La biblioteca de voces premium que lo acompaña incluye diversos tipos de voces —instrucciones, dialectos e idiomas menos utilizados—, admite salida de audio de alta definición a 48K (cuya puesta en marcha está prevista para el 24 de julio) y puede sintetizar hasta 3 minutos de texto largo por sesión. El modelo ya está totalmente disponible en la plataforma BaiLian de Alibaba Cloud, donde los desarrolladores pueden acceder a él y probarlo, lo que abre nuevas posibilidades en la interacción por voz.
Artículo relacionado
 La startup respaldada por Marc Benioff tiene como objetivo resolver los desafíos del despliegue de IA
Las grandes empresas enfrentan desafíos tan elevados al implementar herramientas de IA confiables que han surgido equipos enteros de ingenieros desplegados en el campo—especialistas incrustados dentro de las empresas cliente para operacionalizar sist
AliVideo presenta Wan3.0, ofreciendo generación de vídeo ultra largo y consistencia multidimensional
El 24 de agosto, Alibaba presentó Wan3.0, su último modelo de generación de video a gran escala. Este lanzamiento representa un avance importante en la tecnología de video de Alibaba, ofreciendo mejoras significativas en duración, creación universal,
MiniMax Grandes Modelos Pronuncian Incorrectamente Nombres - Xiyu Technology: Entrenamiento Insuficiente Después de Tokens Específicos
MiniMax publicó recientemente un informe técnico que detalla por qué sus modelos de la serie M2 tuvieron dificultades para generar con precisión nombres específicos como "Ma Jiaqi". Este aparente error destaca una falla sistémica en el entrenamiento
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
El equipo de Alibaba Qwen ha lanzado el nuevo modelo de síntesis de voz en tiempo real Qwen-Audio-3.0-TTS, lo que supone un avance que lleva la síntesis de voz de la generación básica a la verdadera expresión. La versión Plus ocupa ahora el primer puesto a nivel mundial en Speech Arena, un prestigioso banco de pruebas de Artificial Analysis, superando a Gemini 3.1 TTS, ElevenLabs v3 y otros modelos importantes.
Hay dos versiones disponibles: la versión Flash está pensada para la interacción en tiempo real, con una latencia inicial de unos 300 ms, ideal para asistentes inteligentes y otros casos de uso que requieren baja latencia; la versión Plus da prioridad a la generación de alta calidad, ofreciendo una mayor naturalidad y similitud vocal.
Cuatro avances clave en las capacidades principales:
En primer lugar, la compatibilidad multilingüe y con dialectos se ha ampliado a 16 idiomas, y la versión Plus alcanza una similitud media con el hablante del 82,75 % en los 16 idiomas, la más alta del sector. También abarca 20 dialectos chinos, manteniendo las características auténticas de los dialectos en lugar de atenuarlas, lo que permite expresiones más parecidas a las de un nativo.
En segundo lugar, las instrucciones flexibles en lenguaje natural permiten a los usuarios generar voz precisa con indicaciones como «tono amable de atención al cliente» o «estilo de presentador de retransmisión en directo», sin necesidad de anotaciones profesionales.
En tercer lugar, el control detallado de etiquetas admite etiquetas estructuradas como [jadeo] y [enfadado], lo que permite una gestión precisa de detalles no verbales como la respiración y la risa —ideal para videojuegos, audiolibros y situaciones similares—.
En cuarto lugar, una gran robustez acústica: incluso si el audio de referencia contiene mucho ruido o reverberación, el modelo filtra automáticamente el ruido de fondo al tiempo que conserva la calidad de la voz, lo que garantiza una salida de síntesis estable.
La biblioteca de voces premium que lo acompaña incluye diversos tipos de voces —instrucciones, dialectos e idiomas menos utilizados—, admite salida de audio de alta definición a 48K (cuya puesta en marcha está prevista para el 24 de julio) y puede sintetizar hasta 3 minutos de texto largo por sesión. El modelo ya está totalmente disponible en la plataforma BaiLian de Alibaba Cloud, donde los desarrolladores pueden acceder a él y probarlo, lo que abre nuevas posibilidades en la interacción por voz.








 La startup respaldada por Marc Benioff tiene como objetivo resolver los desafíos del despliegue de IA
Las grandes empresas enfrentan desafíos tan elevados al implementar herramientas de IA confiables que han surgido equipos enteros de ingenieros desplegados en el campo—especialistas incrustados dentro de las empresas cliente para operacionalizar sist
 AliVideo presenta Wan3.0, ofreciendo generación de vídeo ultra largo y consistencia multidimensional
El 24 de agosto, Alibaba presentó Wan3.0, su último modelo de generación de video a gran escala. Este lanzamiento representa un avance importante en la tecnología de video de Alibaba, ofreciendo mejoras significativas en duración, creación universal,
 MiniMax Grandes Modelos Pronuncian Incorrectamente Nombres - Xiyu Technology: Entrenamiento Insuficiente Después de Tokens Específicos
MiniMax publicó recientemente un informe técnico que detalla por qué sus modelos de la serie M2 tuvieron dificultades para generar con precisión nombres específicos como "Ma Jiaqi". Este aparente error destaca una falla sistémica en el entrenamiento

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












