


 Heim
Tongyi Qianwen Qwen-Audio-3.0-TTS geht mit einer Verzögerung des ersten Pakets von 300 ms und 20 Dialekten in Betrieb
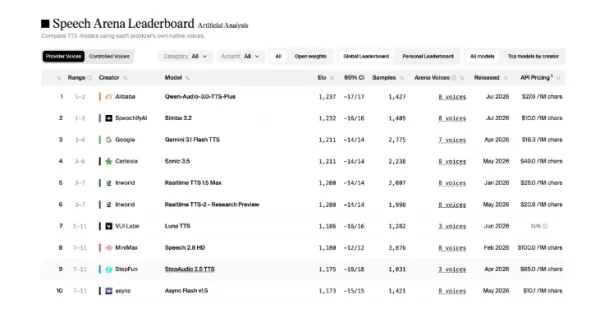
Das Alibaba-Qwen-Team hat das neue Echtzeit-Sprachsynthese-Modell „Qwen-Audio-3.0-TTS“ vorgestellt, das die Sprachsynthese von der einfachen Erzeugung hin zu echtem Ausdruck weiterentwickelt. Die Plus-Version belegt nun weltweit den ersten Platz in der „Speech Arena“, einem angesehenen Benchmark von Artificial Analysis, und übertrifft damit Gemini 3.1 TTS, ElevenLabs v3 und andere führende Modelle.
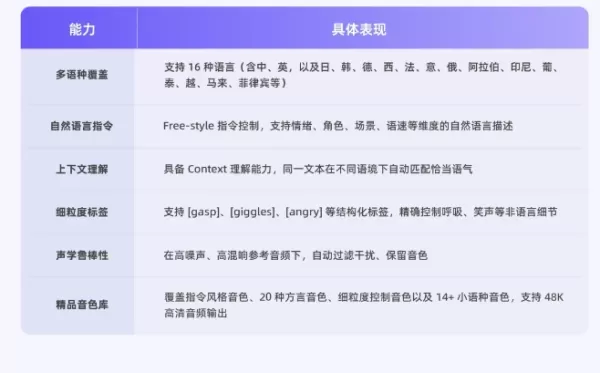
Es stehen zwei Versionen zur Verfügung: Die Flash-Version zielt auf Echtzeit-Interaktion mit einer anfänglichen Latenz von etwa 300 ms ab und eignet sich ideal für Smart-Assistenten und andere Anwendungsfälle mit geringer Latenz; die Plus-Version legt den Schwerpunkt auf eine hochwertige Sprachausgabe und bietet eine verbesserte Natürlichkeit sowie eine höhere Stimmähnlichkeit.
Vier wesentliche Durchbrüche bei den Kernfunktionen:
Erstens wurde die Unterstützung für mehrere Sprachen und Dialekte auf 16 Sprachen erweitert, wobei die Plus-Version über alle 16 Sprachen hinweg eine durchschnittliche Sprecherähnlichkeit von 82,75 % erreicht – der branchenweit höchste Wert. Sie deckt zudem 20 chinesische Dialekte ab und bewahrt dabei authentische Dialektmerkmale, anstatt sie zu verwässern, was zu muttersprachlicheren Äußerungen führt.
Zweitens ermöglichen flexible Anweisungen in natürlicher Sprache den Nutzern, präzise Sprachausgaben mit Vorgaben wie „sanfter Kundenservice-Tonfall“ oder „Live-Streaming-Moderator-Stil“ zu generieren, ohne dass professionelle Annotationen erforderlich sind.
Drittens unterstützt die fein abgestufte Tag-Steuerung strukturierte Tags wie [gasp] und [angry], was eine präzise Steuerung nonverbaler Details wie Atmung und Lachen ermöglicht – geeignet für Spiele, Hörbücher und ähnliche Szenarien.
Viertens: hohe akustische Robustheit: Selbst wenn das Referenzaudio starkes Rauschen oder Nachhall enthält, filtert das Modell Hintergrundgeräusche automatisch heraus und bewahrt dabei die Sprachqualität, wodurch eine stabile Syntheseausgabe gewährleistet wird.
Die dazugehörige Premium-Stimmenbibliothek umfasst verschiedene Stimmtypen – Anweisungen, Dialekte und seltener verwendete Sprachen –, unterstützt eine hochauflösende Audioausgabe mit 48K (voraussichtlich ab dem 24. Juli verfügbar) und kann pro Sitzung bis zu 3 Minuten langen Text synthetisieren. Das Modell ist ab sofort vollständig auf der Alibaba Cloud BaiLian-Plattform verfügbar, wo Entwickler darauf zugreifen und es ausprobieren können, was neue Möglichkeiten im Bereich der Sprachinteraktion eröffnet.
Verwandter Artikel
 Das MacWhisper 14-Update ermöglicht die direkte Bearbeitung von Transkripten und behebt das Problem der hohen CPU-Auslastung
Jodi Bruijn, die unabhängige Entwicklerin hinter MacWhisper, hat gestern die Version 14.0 veröffentlicht, deren Schwerpunkt auf einer verbesserten Transkriptionsleistung liegt und die eine eigene Edit
Qwen3.5-Max Preview führt LMArena an, während Chinas KI-Modelle weltweit an die Spitze rücken
Am 20. März enthüllten die neuesten Rankings der autoritativen Blindtest-Plattform für große Modelle, LMArena, dass das neueste Flaggschiff-Vorschau-Modell der Qwen-Serie von Alibaba, Qwen3.5-Max-Preview, außergewöhnliche Leistungen erbrachte. Mit 14
Von Marc Benioff unterstütztes Startup zielt darauf ab, Herausforderungen bei der KI-Implementierung zu lösen
Große Unternehmen stehen vor so massiven Herausforderungen beim Einsatz zuverlässiger KI-Tools, dass sich ganze Teams von vor Ort eingesetzten Ingenieuren – Spezialisten, die in Kundenunternehmen eingebettet sind, um KI-Systeme operativ umzusetzen –
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (0)
Das Alibaba-Qwen-Team hat das neue Echtzeit-Sprachsynthese-Modell „Qwen-Audio-3.0-TTS“ vorgestellt, das die Sprachsynthese von der einfachen Erzeugung hin zu echtem Ausdruck weiterentwickelt. Die Plus-Version belegt nun weltweit den ersten Platz in der „Speech Arena“, einem angesehenen Benchmark von Artificial Analysis, und übertrifft damit Gemini 3.1 TTS, ElevenLabs v3 und andere führende Modelle.
Es stehen zwei Versionen zur Verfügung: Die Flash-Version zielt auf Echtzeit-Interaktion mit einer anfänglichen Latenz von etwa 300 ms ab und eignet sich ideal für Smart-Assistenten und andere Anwendungsfälle mit geringer Latenz; die Plus-Version legt den Schwerpunkt auf eine hochwertige Sprachausgabe und bietet eine verbesserte Natürlichkeit sowie eine höhere Stimmähnlichkeit.
Vier wesentliche Durchbrüche bei den Kernfunktionen:
Erstens wurde die Unterstützung für mehrere Sprachen und Dialekte auf 16 Sprachen erweitert, wobei die Plus-Version über alle 16 Sprachen hinweg eine durchschnittliche Sprecherähnlichkeit von 82,75 % erreicht – der branchenweit höchste Wert. Sie deckt zudem 20 chinesische Dialekte ab und bewahrt dabei authentische Dialektmerkmale, anstatt sie zu verwässern, was zu muttersprachlicheren Äußerungen führt.
Zweitens ermöglichen flexible Anweisungen in natürlicher Sprache den Nutzern, präzise Sprachausgaben mit Vorgaben wie „sanfter Kundenservice-Tonfall“ oder „Live-Streaming-Moderator-Stil“ zu generieren, ohne dass professionelle Annotationen erforderlich sind.
Drittens unterstützt die fein abgestufte Tag-Steuerung strukturierte Tags wie [gasp] und [angry], was eine präzise Steuerung nonverbaler Details wie Atmung und Lachen ermöglicht – geeignet für Spiele, Hörbücher und ähnliche Szenarien.
Viertens: hohe akustische Robustheit: Selbst wenn das Referenzaudio starkes Rauschen oder Nachhall enthält, filtert das Modell Hintergrundgeräusche automatisch heraus und bewahrt dabei die Sprachqualität, wodurch eine stabile Syntheseausgabe gewährleistet wird.
Die dazugehörige Premium-Stimmenbibliothek umfasst verschiedene Stimmtypen – Anweisungen, Dialekte und seltener verwendete Sprachen –, unterstützt eine hochauflösende Audioausgabe mit 48K (voraussichtlich ab dem 24. Juli verfügbar) und kann pro Sitzung bis zu 3 Minuten langen Text synthetisieren. Das Modell ist ab sofort vollständig auf der Alibaba Cloud BaiLian-Plattform verfügbar, wo Entwickler darauf zugreifen und es ausprobieren können, was neue Möglichkeiten im Bereich der Sprachinteraktion eröffnet.








 Das MacWhisper 14-Update ermöglicht die direkte Bearbeitung von Transkripten und behebt das Problem der hohen CPU-Auslastung
Jodi Bruijn, die unabhängige Entwicklerin hinter MacWhisper, hat gestern die Version 14.0 veröffentlicht, deren Schwerpunkt auf einer verbesserten Transkriptionsleistung liegt und die eine eigene Edit
 Qwen3.5-Max Preview führt LMArena an, während Chinas KI-Modelle weltweit an die Spitze rücken
Am 20. März enthüllten die neuesten Rankings der autoritativen Blindtest-Plattform für große Modelle, LMArena, dass das neueste Flaggschiff-Vorschau-Modell der Qwen-Serie von Alibaba, Qwen3.5-Max-Preview, außergewöhnliche Leistungen erbrachte. Mit 14
 Von Marc Benioff unterstütztes Startup zielt darauf ab, Herausforderungen bei der KI-Implementierung zu lösen
Große Unternehmen stehen vor so massiven Herausforderungen beim Einsatz zuverlässiger KI-Tools, dass sich ganze Teams von vor Ort eingesetzten Ingenieuren – Spezialisten, die in Kundenunternehmen eingebettet sind, um KI-Systeme operativ umzusetzen –

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai












