


 Maison
Tongyi Qianwen Qwen-Audio-3.0-TTS est désormais disponible avec un délai de transmission du premier paquet de 300 ms et 20 dialectes
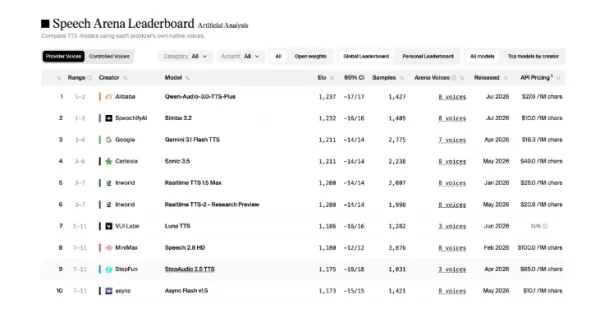
L'équipe Qwen d'Alibaba a lancé le nouveau modèle de synthèse vocale en temps réel Qwen-Audio-3.0-TTS, faisant ainsi passer la synthèse vocale de la simple génération à une véritable expression. La version Plus occupe désormais la première place mondiale du classement Speech Arena, une référence reconnue par Artificial Analysis, devançant ainsi Gemini 3.1 TTS, ElevenLabs v3 et d’autres modèles majeurs.
Deux versions sont disponibles : la version Flash est destinée aux interactions en temps réel avec une latence initiale d’environ 300 ms, ce qui est idéal pour les assistants intelligents et autres cas d’utilisation nécessitant une faible latence ; la version Plus privilégie une génération de haute qualité, offrant un naturel et une ressemblance vocale améliorés.
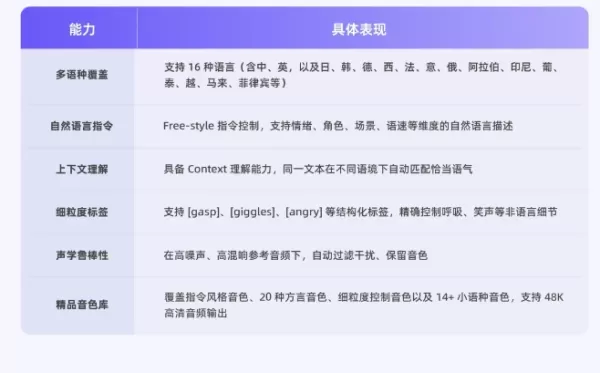
Quatre avancées majeures au niveau des capacités de base :
Premièrement, la prise en charge multilingue et des dialectes a été étendue à 16 langues, la version Plus atteignant une similitude moyenne avec l’orateur de 82,75 % sur l’ensemble de ces 16 langues — le taux le plus élevé du secteur. Elle couvre également 20 dialectes chinois, en conservant les caractéristiques authentiques de ces dialectes plutôt qu’en les atténuant, pour des expressions plus proches de celles d’un locuteur natif.
Deuxièmement, des instructions en langage naturel flexibles permettent aux utilisateurs de générer une parole précise à l’aide de consignes telles que « ton doux de service client » ou « style d’animateur de streaming en direct », sans avoir besoin d’annotations professionnelles.
Troisièmement, le contrôle fin des balises prend en charge des balises structurées telles que [halètement] et [colère], permettant une gestion précise des détails non verbaux comme la respiration et le rire — ce qui convient particulièrement aux jeux, aux livres audio et à des scénarios similaires.
Quatrièmement, une grande robustesse acoustique : même si l’enregistrement de référence contient beaucoup de bruit ou de réverbération, le modèle filtre automatiquement les bruits de fond tout en préservant la qualité vocale, garantissant ainsi un résultat de synthèse stable.
La bibliothèque de voix premium qui l’accompagne comprend divers types de voix — instructions, dialectes et langues moins courantes —, prend en charge une sortie audio haute définition à 48 K (dont le lancement est prévu le 24 juillet) et peut synthétiser jusqu’à 3 minutes de texte long par session. Le modèle est désormais entièrement disponible sur la plateforme BaiLian d’Alibaba Cloud, où les développeurs peuvent y accéder et l’essayer, ouvrant ainsi de nouvelles possibilités en matière d’interaction vocale.
Article connexe
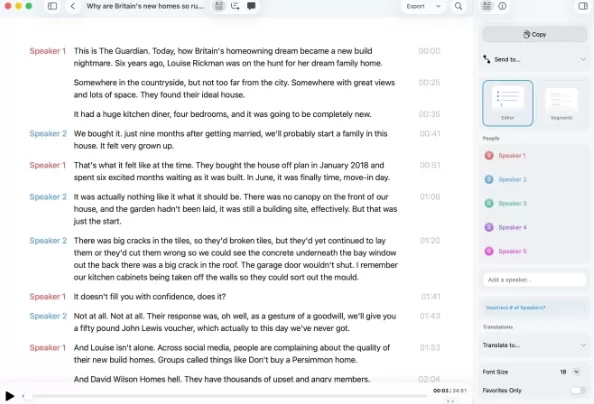
 La mise à jour de MacWhisper 14 permet désormais de modifier directement les transcriptions et corrige le problème de consommation excessive du processeur
Jodi Bruijn, la développeuse indépendante à l’origine de MacWhisper, a publié hier la version 14.0, qui met l’accent sur l’amélioration des performances de transcription et introduit un éditeur dédié.
Qwen3.5-Max Preview en tête du LMArena alors que les modèles d'IA chinois atteignent le premier rang mondial
Le 20 mars, les derniers classements de la plateforme d’évaluation aveugle des grands modèles d’autorité LMArena ont révélé que le tout dernier modèle phare de la série Qwen d’Alibaba, Qwen3.5-Max-Preview, a offert des performances exceptionnelles. A
La startup soutenue par Marc Benioff vise à résoudre les défis du déploiement de l'IA
Les grandes entreprises font face à des défis si considérables dans le déploiement d’outils d’intelligence artificielle fiables que des équipes entières d’ingénieurs déployés sur site – des spécialistes intégrés au sein des entreprises clientes pour
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (0)
L'équipe Qwen d'Alibaba a lancé le nouveau modèle de synthèse vocale en temps réel Qwen-Audio-3.0-TTS, faisant ainsi passer la synthèse vocale de la simple génération à une véritable expression. La version Plus occupe désormais la première place mondiale du classement Speech Arena, une référence reconnue par Artificial Analysis, devançant ainsi Gemini 3.1 TTS, ElevenLabs v3 et d’autres modèles majeurs.
Deux versions sont disponibles : la version Flash est destinée aux interactions en temps réel avec une latence initiale d’environ 300 ms, ce qui est idéal pour les assistants intelligents et autres cas d’utilisation nécessitant une faible latence ; la version Plus privilégie une génération de haute qualité, offrant un naturel et une ressemblance vocale améliorés.
Quatre avancées majeures au niveau des capacités de base :
Premièrement, la prise en charge multilingue et des dialectes a été étendue à 16 langues, la version Plus atteignant une similitude moyenne avec l’orateur de 82,75 % sur l’ensemble de ces 16 langues — le taux le plus élevé du secteur. Elle couvre également 20 dialectes chinois, en conservant les caractéristiques authentiques de ces dialectes plutôt qu’en les atténuant, pour des expressions plus proches de celles d’un locuteur natif.
Deuxièmement, des instructions en langage naturel flexibles permettent aux utilisateurs de générer une parole précise à l’aide de consignes telles que « ton doux de service client » ou « style d’animateur de streaming en direct », sans avoir besoin d’annotations professionnelles.
Troisièmement, le contrôle fin des balises prend en charge des balises structurées telles que [halètement] et [colère], permettant une gestion précise des détails non verbaux comme la respiration et le rire — ce qui convient particulièrement aux jeux, aux livres audio et à des scénarios similaires.
Quatrièmement, une grande robustesse acoustique : même si l’enregistrement de référence contient beaucoup de bruit ou de réverbération, le modèle filtre automatiquement les bruits de fond tout en préservant la qualité vocale, garantissant ainsi un résultat de synthèse stable.
La bibliothèque de voix premium qui l’accompagne comprend divers types de voix — instructions, dialectes et langues moins courantes —, prend en charge une sortie audio haute définition à 48 K (dont le lancement est prévu le 24 juillet) et peut synthétiser jusqu’à 3 minutes de texte long par session. Le modèle est désormais entièrement disponible sur la plateforme BaiLian d’Alibaba Cloud, où les développeurs peuvent y accéder et l’essayer, ouvrant ainsi de nouvelles possibilités en matière d’interaction vocale.








 La mise à jour de MacWhisper 14 permet désormais de modifier directement les transcriptions et corrige le problème de consommation excessive du processeur
Jodi Bruijn, la développeuse indépendante à l’origine de MacWhisper, a publié hier la version 14.0, qui met l’accent sur l’amélioration des performances de transcription et introduit un éditeur dédié.
 Qwen3.5-Max Preview en tête du LMArena alors que les modèles d'IA chinois atteignent le premier rang mondial
Le 20 mars, les derniers classements de la plateforme d’évaluation aveugle des grands modèles d’autorité LMArena ont révélé que le tout dernier modèle phare de la série Qwen d’Alibaba, Qwen3.5-Max-Preview, a offert des performances exceptionnelles. A
 La startup soutenue par Marc Benioff vise à résoudre les défis du déploiement de l'IA
Les grandes entreprises font face à des défis si considérables dans le déploiement d’outils d’intelligence artificielle fiables que des équipes entières d’ingénieurs déployés sur site – des spécialistes intégrés au sein des entreprises clientes pour

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai












