


 家
NvidiaはAIベンチマークを支配していますが、Intelは重要な競争を提供しています
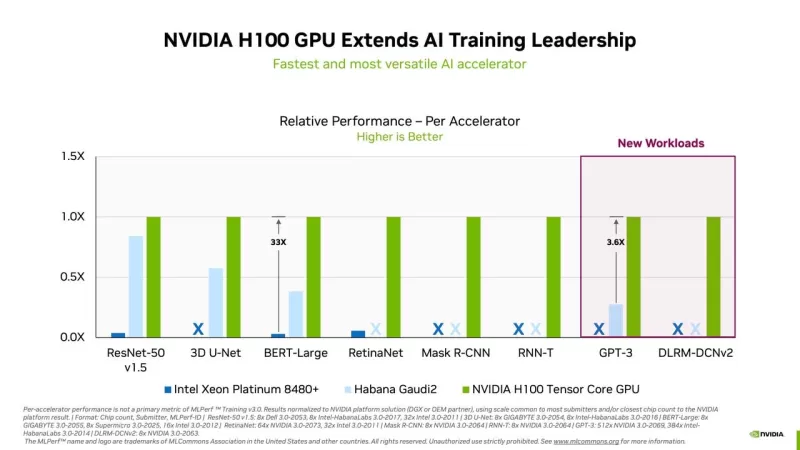
火曜日に業界コンソーシアムMLCommonsが発表した最新のニューラルネットワークトレーニング速度ベンチマークでは、NvidiaがMLPerfテストの全カテゴリーで再び最高のパフォーマーとして君臨しました。Google、Graphcore、Advanced Micro Devicesなどの主要な競合他社がこのラウンドに参加しなかったため、Nvidiaの完全な勝利は揺るぎないものでした。
しかし、IntelのHabana部門はGuadi2チップで顕著な成果を上げ、競争力のある優位性を示しました。Intelは大胆にも、今年の秋までにNvidiaのフラッグシップH100 GPUを上回ると約束しています。
MLPerfトレーニングバージョン3.0ベンチマークは、ニューラルネットワークの「重み」やパラメータを特定のタスクで設定された精度レベルに調整するのに必要な時間、つまり「トレーニング」に焦点を当てています。このバージョンのテストは8つの異なるタスクを包含し、複数の実験を通じてニューラルネットワークを改良するのに必要な時間を測定します。これはニューラルネットワークのパフォーマンスの一つの側面であり、もう一つは「推論」で、トレーニングされたネットワークが新しいデータに対して予測を行うものです。推論のパフォーマンスはMLCommonsによって別途評価されます。
サーバーベースのトレーニングに加えて、MLCommonsは超低消費電力デバイスでの予測パフォーマンスを評価するMLPerf Tinyバージョン1.1ベンチマークを導入しました。
Nvidiaは8つのテストすべてでトップを獲得し、最速のトレーニング時間を達成しました。新しいタスクとして、OpenAIのGPT-3大規模言語モデル(LLM)を含む2つのタスクが導入されました。ChatGPTの人気によって引き起こされた生成AIへの熱狂がこれを注目の的としています。NvidiaはCoreWeaveと協力して、896個のIntel Xeonプロセッサと3,584個のNvidia H100 GPUを搭載したシステムを利用し、GPT-3タスクでリードしました。このセットアップは、NvidiaのNeMOフレームワーク上で動作し、Colossal Cleaned Common Crawlデータセットを使用してわずか11分弱でトレーニングを完了しました。テストでは、実行時間を管理可能にするために、1750億パラメータを持つ「大規模」バージョンのGPT-3を使用し、完全なトレーニングセットの0.4%に制限しました。
もう一つの新しい追加は、レコメンダーエンジンのテストの拡張バージョンで、従来の1テラバイトのデータセットを置き換え、より大規模な4テラバイトのデータセットであるCriteo 4TBマルチホットを使用しました。MLCommonsは、サイズ、計算能力、メモリオペレーションの点で本番レコメンデーションモデルの規模が拡大していると指摘しました。
AIチップ分野での唯一の他の競合はIntelのHabanaで、Gaudi2アクセラレータを使用した5つの提出と、SuperMicroからの同じチップを使用した1つの提出がありました。これらのエントリーは8つのタスクのうち4つをカバーしましたが、Nvidiaの最良のシステムに大きく遅れをとりました。例えば、BERT Wikipediaテストでは、Habanaは5位で、Nvidia-CoreWeaveの3,072 GPUセットアップの8秒に対し、2分かかりました。
それでも、IntelのAI製品責任者であるJordan Plawnerは、ZDNETのインタビューで、同様の規模のシステムでは、HabanaとNvidiaのパフォーマンスギャップが多くの企業にとってそれほど重要ではないかもしれないと強調しました。彼は、2つのIntel Xeonプロセッサを搭載した8デバイスのHabanaシステムが、BERT Wikipediaタスクをわずか14分強で完了し、より多くのNvidia A100 GPUを使用した多くの提出を上回ったと指摘しました。
Plawnerは、Gaudi2のコスト効率を強調し、NvidiaのA100と同等の価格でありながら、トレーニングにおけるコストパフォーマンスが優れていると述べました。彼はまた、Nvidiaが提出でFP-8データ形式を使用したのに対し、Habanaはより高い精度を持つBF-16形式を使用したが、これがトレーニングをわずかに遅くしたと述べました。Plawnerは、今年後半にFP-8に切り替えることで、Gaudi2のパフォーマンスが向上し、NvidiaのH100を上回る可能性があると予測しています。
彼は、NvidiaのGPUの現在の供給制約を考慮して、Nvidiaの代替品が必要だと強調しました。遅延に不満を抱く顧客は、Nvidiaの部品を待たずにサービスを開始できるGaudi2のような代替品にますますオープンです。
世界第2位のチップメーカーであるIntelは、台湾セミコンダクターに次ぐ立場として、サプライチェーンを管理する戦略的優位性を持っています。Plawnerは、Intelが数千のGaudi2クラスタを構築する計画をほのめかし、将来のMLPerfテストでの強力な競争相手となる可能性を示唆しました。
これで、Nvidiaのトレーニングテストでのトップの地位に他のチップメーカーが挑戦しなかったのは2四半期連続です。1年前、GoogleはTPUを使用してNvidiaとトップの座を分け合いましたが、最新のラウンドではGoogleとGraphcoreはベンチマーク競争ではなくビジネスに注力し、参加しませんでした。
MLCommonsのディレクターであるDavid Kanterは、より多くの参加者を望むと述べ、幅広い参加が業界に利益をもたらすと指摘しました。GoogleとAMDはこのラウンドでの不参加についての問い合わせに応じませんでした。興味深いことに、AMDのCPUが競合システムで使用された一方、すべての勝利したNvidiaのセットアップはIntel Xeon CPUを使用し、IntelのSapphire Rapidsのリリースにより、昨年AMDのEPYCプロセッサが支配していた状況からの変化を示しました。
一部の大手企業の参加が欠けたにもかかわらず、MLPerfテストはCoreWeave、IEI、Quanta Cloud Technologyなどの新しい参加者を引きつけ続けており、AIチップパフォーマンスの分野での継続的な関心と競争を示しています。
関連記事
 AppleのスマートグラスはWWDC27でデビューする可能性があり、プライバシー保護を強調している
Bloombergのマーク・ガーマン氏によると、Appleのスマートグラス(コードネームN50)は2027年6月のWWDC27で初公開され、2027年秋に小売店での発売が予定されている。当初は今年後半から2027年初頭にかけての発売が目標だったが、製品のさらなる洗練とプライバシー保護プロトコルの強化を可能にするため、発売時期が延期された。プライバシーはAppleのスマートグラス戦略の中核的な柱である。Metaなどの競合他社をめぐるプライバシー論争から教訓を得て、Appleは堅牢な機能とポリシー
内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策
関連特集おすすめ
作曲
 曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
 8 ツール
 xix.ai
チャットボット
面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

 コメント (11)
0/500
![HarrySmith]()
Intel stepping up to Nvidia's AI game is wild! 🤯 It's like the underdog finally landing some solid punches. Curious to see how this shakes up the market!
![HenryJackson]()
NvidiaのAIベンチマークでの支配力は印象的ですが、Intelの競争が物事を面白くしています。私はプロジェクトにNvidiaのツールを使っていますが、速いです。しかし、Intelの提供するものにも興味があります。もっと詳細な比較があればいいのにと思います。同じように感じる人はいますか?🤔
![BruceSmith]()
El dominio de Nvidia en los benchmarks de IA es impresionante, pero la competencia de Intel mantiene las cosas emocionantes. He estado usando las herramientas de Nvidia para mis proyectos, y son rápidas, pero las ofertas de Intel son intrigantes. Ojalá hubiera más comparaciones detalladas, sin embargo. ¿Alguien más siente lo mismo? 🤔
![AlbertDavis]()
Nvidia's dominance in AI benchmarks is impressive, but Intel's competition keeps things interesting! I've been using Nvidia's tech for my projects, and it's super fast. Intel's not far behind though, which is great for us users. Keep pushing the limits, guys! 🚀
![ThomasYoung]()
A dominância da Nvidia nos benchmarks de IA é impressionante, mas a competição da Intel está mantendo as coisas emocionantes. Estou usando as ferramentas da Nvidia para meus projetos, e elas são rápidas, mas as ofertas da Intel são intrigantes. Gostaria que houvesse comparações mais detalhadas, no entanto. Alguém mais sente o mesmo? 🤔
![WillieJackson]()
La dominancia de Nvidia en los benchmarks de IA es impresionante, pero la competencia de Intel mantiene las cosas interesantes. He estado usando la tecnología de Nvidia para mis proyectos y es súper rápida. Intel no se queda atrás, lo cual es genial para nosotros los usuarios. ¡Sigan empujando los límites, chicos! 🚀
火曜日に業界コンソーシアムMLCommonsが発表した最新のニューラルネットワークトレーニング速度ベンチマークでは、NvidiaがMLPerfテストの全カテゴリーで再び最高のパフォーマーとして君臨しました。Google、Graphcore、Advanced Micro Devicesなどの主要な競合他社がこのラウンドに参加しなかったため、Nvidiaの完全な勝利は揺るぎないものでした。
しかし、IntelのHabana部門はGuadi2チップで顕著な成果を上げ、競争力のある優位性を示しました。Intelは大胆にも、今年の秋までにNvidiaのフラッグシップH100 GPUを上回ると約束しています。
MLPerfトレーニングバージョン3.0ベンチマークは、ニューラルネットワークの「重み」やパラメータを特定のタスクで設定された精度レベルに調整するのに必要な時間、つまり「トレーニング」に焦点を当てています。このバージョンのテストは8つの異なるタスクを包含し、複数の実験を通じてニューラルネットワークを改良するのに必要な時間を測定します。これはニューラルネットワークのパフォーマンスの一つの側面であり、もう一つは「推論」で、トレーニングされたネットワークが新しいデータに対して予測を行うものです。推論のパフォーマンスはMLCommonsによって別途評価されます。
サーバーベースのトレーニングに加えて、MLCommonsは超低消費電力デバイスでの予測パフォーマンスを評価するMLPerf Tinyバージョン1.1ベンチマークを導入しました。
Nvidiaは8つのテストすべてでトップを獲得し、最速のトレーニング時間を達成しました。新しいタスクとして、OpenAIのGPT-3大規模言語モデル(LLM)を含む2つのタスクが導入されました。ChatGPTの人気によって引き起こされた生成AIへの熱狂がこれを注目の的としています。NvidiaはCoreWeaveと協力して、896個のIntel Xeonプロセッサと3,584個のNvidia H100 GPUを搭載したシステムを利用し、GPT-3タスクでリードしました。このセットアップは、NvidiaのNeMOフレームワーク上で動作し、Colossal Cleaned Common Crawlデータセットを使用してわずか11分弱でトレーニングを完了しました。テストでは、実行時間を管理可能にするために、1750億パラメータを持つ「大規模」バージョンのGPT-3を使用し、完全なトレーニングセットの0.4%に制限しました。
もう一つの新しい追加は、レコメンダーエンジンのテストの拡張バージョンで、従来の1テラバイトのデータセットを置き換え、より大規模な4テラバイトのデータセットであるCriteo 4TBマルチホットを使用しました。MLCommonsは、サイズ、計算能力、メモリオペレーションの点で本番レコメンデーションモデルの規模が拡大していると指摘しました。
AIチップ分野での唯一の他の競合はIntelのHabanaで、Gaudi2アクセラレータを使用した5つの提出と、SuperMicroからの同じチップを使用した1つの提出がありました。これらのエントリーは8つのタスクのうち4つをカバーしましたが、Nvidiaの最良のシステムに大きく遅れをとりました。例えば、BERT Wikipediaテストでは、Habanaは5位で、Nvidia-CoreWeaveの3,072 GPUセットアップの8秒に対し、2分かかりました。
それでも、IntelのAI製品責任者であるJordan Plawnerは、ZDNETのインタビューで、同様の規模のシステムでは、HabanaとNvidiaのパフォーマンスギャップが多くの企業にとってそれほど重要ではないかもしれないと強調しました。彼は、2つのIntel Xeonプロセッサを搭載した8デバイスのHabanaシステムが、BERT Wikipediaタスクをわずか14分強で完了し、より多くのNvidia A100 GPUを使用した多くの提出を上回ったと指摘しました。
Plawnerは、Gaudi2のコスト効率を強調し、NvidiaのA100と同等の価格でありながら、トレーニングにおけるコストパフォーマンスが優れていると述べました。彼はまた、Nvidiaが提出でFP-8データ形式を使用したのに対し、Habanaはより高い精度を持つBF-16形式を使用したが、これがトレーニングをわずかに遅くしたと述べました。Plawnerは、今年後半にFP-8に切り替えることで、Gaudi2のパフォーマンスが向上し、NvidiaのH100を上回る可能性があると予測しています。
彼は、NvidiaのGPUの現在の供給制約を考慮して、Nvidiaの代替品が必要だと強調しました。遅延に不満を抱く顧客は、Nvidiaの部品を待たずにサービスを開始できるGaudi2のような代替品にますますオープンです。
世界第2位のチップメーカーであるIntelは、台湾セミコンダクターに次ぐ立場として、サプライチェーンを管理する戦略的優位性を持っています。Plawnerは、Intelが数千のGaudi2クラスタを構築する計画をほのめかし、将来のMLPerfテストでの強力な競争相手となる可能性を示唆しました。
これで、Nvidiaのトレーニングテストでのトップの地位に他のチップメーカーが挑戦しなかったのは2四半期連続です。1年前、GoogleはTPUを使用してNvidiaとトップの座を分け合いましたが、最新のラウンドではGoogleとGraphcoreはベンチマーク競争ではなくビジネスに注力し、参加しませんでした。
MLCommonsのディレクターであるDavid Kanterは、より多くの参加者を望むと述べ、幅広い参加が業界に利益をもたらすと指摘しました。GoogleとAMDはこのラウンドでの不参加についての問い合わせに応じませんでした。興味深いことに、AMDのCPUが競合システムで使用された一方、すべての勝利したNvidiaのセットアップはIntel Xeon CPUを使用し、IntelのSapphire Rapidsのリリースにより、昨年AMDのEPYCプロセッサが支配していた状況からの変化を示しました。
一部の大手企業の参加が欠けたにもかかわらず、MLPerfテストはCoreWeave、IEI、Quanta Cloud Technologyなどの新しい参加者を引きつけ続けており、AIチップパフォーマンスの分野での継続的な関心と競争を示しています。








 AppleのスマートグラスはWWDC27でデビューする可能性があり、プライバシー保護を強調している
Bloombergのマーク・ガーマン氏によると、Appleのスマートグラス(コードネームN50)は2027年6月のWWDC27で初公開され、2027年秋に小売店での発売が予定されている。当初は今年後半から2027年初頭にかけての発売が目標だったが、製品のさらなる洗練とプライバシー保護プロトコルの強化を可能にするため、発売時期が延期された。プライバシーはAppleのスマートグラス戦略の中核的な柱である。Metaなどの競合他社をめぐるプライバシー論争から教訓を得て、Appleは堅牢な機能とポリシー
 内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
 OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

Intel stepping up to Nvidia's AI game is wild! 🤯 It's like the underdog finally landing some solid punches. Curious to see how this shakes up the market!
NvidiaのAIベンチマークでの支配力は印象的ですが、Intelの競争が物事を面白くしています。私はプロジェクトにNvidiaのツールを使っていますが、速いです。しかし、Intelの提供するものにも興味があります。もっと詳細な比較があればいいのにと思います。同じように感じる人はいますか?🤔
El dominio de Nvidia en los benchmarks de IA es impresionante, pero la competencia de Intel mantiene las cosas emocionantes. He estado usando las herramientas de Nvidia para mis proyectos, y son rápidas, pero las ofertas de Intel son intrigantes. Ojalá hubiera más comparaciones detalladas, sin embargo. ¿Alguien más siente lo mismo? 🤔
Nvidia's dominance in AI benchmarks is impressive, but Intel's competition keeps things interesting! I've been using Nvidia's tech for my projects, and it's super fast. Intel's not far behind though, which is great for us users. Keep pushing the limits, guys! 🚀
A dominância da Nvidia nos benchmarks de IA é impressionante, mas a competição da Intel está mantendo as coisas emocionantes. Estou usando as ferramentas da Nvidia para meus projetos, e elas são rápidas, mas as ofertas da Intel são intrigantes. Gostaria que houvesse comparações mais detalhadas, no entanto. Alguém mais sente o mesmo? 🤔
La dominancia de Nvidia en los benchmarks de IA es impresionante, pero la competencia de Intel mantiene las cosas interesantes. He estado usando la tecnología de Nvidia para mis proyectos y es súper rápida. Intel no se queda atrás, lo cual es genial para nosotros los usuarios. ¡Sigan empujando los límites, chicos! 🚀












