


 家
MiniCPM-V 4.6の「1.3Bモデル」による次元削減アプローチが、エッジマルチモーダル技術の概念を一新する
5月11日、Mingshi Intelligenceは清華大学およびオープンソースコミュニティ「OpenBMB」と提携し、新たなエッジサイド向けマルチモーダル大規模モデル「MiniCPM-V4.6」を発表した。 パラメータ数はわずか13億とコンパクトなサイズでありながら、この軽量モデルは卓越した知能密度とクロスプラットフォーム対応力を備え、大規模モデルの限界を押し広げ、エッジ側AIの実用化を加速させます。
1. ピークパフォーマンス:13億パラメータが卓越した結果をもたらす
MiniCPM-V4.6には「Instruct」と「Thinking」の2つのバージョンがあり、いずれも同規模のモデルと比較して、さまざまなベンチマークにおいて優れた推論能力と理解力を発揮しています。
世界トップクラスの性能:Artificial Analysis(AA)のリーダーボードにおいて、 MiniCPM-V4.6は13ポイントという驚異的なスコアを記録し、同規模の競合モデル(例:アリババのQwen3.5-0.8BやGoogleのGemma4-E2B-it)を大幅に上回り、Qwen3.5-2Bのような大規模モデルの性能にほぼ匹敵しました。 これにより、10億パラメータモデルにおける新たなベンチマークが確立されました。
高度な機能:一般的な画像・テキストの理解や複雑なSTEM(科学・技術・工学・数学)分野の推論から、難易度の高い文書OCRや動画の時系列理解に至るまで、本モデルは強力な知能を発揮します。特に「Thinking」バージョンは、複数画像を用いた推論や幻覚の抑制において卓越した性能を示します。
2. 効率性の飛躍:エッジにおける極限の知能密度
エッジ展開におけるメモリの制約に対処するため、MiniCPM-V4.6は推論速度とリソース効率の面で徹底的に最適化されています。
低メモリ消費:メモリ要件はわずか6GBに抑えられ、一般的なスマートフォン、PC、スマートホームデバイスでのスムーズな動作を実現します。
推論効率:vLLMを搭載し、推論スループットは競合モデルの1.5倍に達します。エッジ環境で3136²の超高解像度画像を処理する場合、初回応答遅延はわずか75.7msであり、競合モデルよりも2.2倍高速です。
スループット:単一のGPUで、1秒あたり7,013トークンのテキスト生成が可能であり、1,344²の画像を1秒あたり54.79枚のペースで処理でき、卓越した効率性を発揮します。
3. コア技術:LLaVA-UHD v4によるオーバーヘッドの最小化
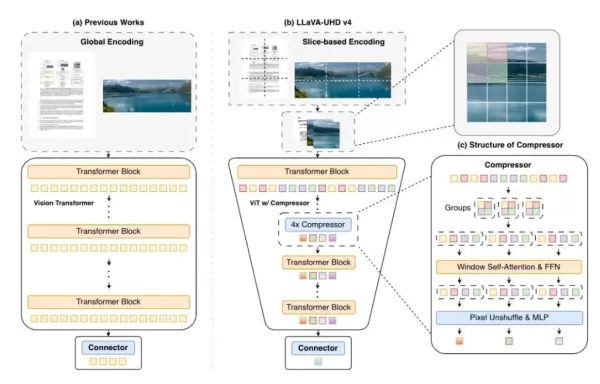
このモデルの軽量設計は、Mingshi Intelligenceと清華大学が共同開発したLLaVA-UHD v4によって実現されています。
エンコーディングの再設計:改良されたViT画像エンコーディングと浅層圧縮モジュールにより、画像エンコーディングのオーバーヘッドを50%、高解像度浮動小数点演算を55.8%削減しました。
ハイブリッド圧縮:4×/16×のハイブリッドトークン圧縮を導入し、性能優先モードと速度優先モードの柔軟な切り替えを可能にしました。この技術は、膨大なトラフィックを処理するKuaishouのレコメンデーションモデル「OneRec」において実証済みです。
4. エコシステムへの展開:研究室から実産業へ
MiniCPM-V4.6のオープンソースリリースは、技術面およびエコシステム面における重要なマイルストーンとなります。
容易な開発:ms-swiftやLLaMA-Factoryなどの微調整フレームワークとシームレスに統合され、単一のRTX 4090 GPU上で本格的な微調整が可能になります。
クロスプラットフォーム対応:vLLM、Ollama、その他の主要フレームワークと互換性があり、iOS、Android、HarmonyOS向けのテスト版を提供することで、より幅広いハードウェアにAIを導入します。
実社会への影響:このモデルシリーズはすでに、自動車、PC、スマートホーム、産業用検査の各分野で導入されており、Lenovo、Geely、SAIC Volkswagen、Xiaomi、OPPOなどがパートナーとして参画しています。
関連記事
 李飛飛氏のチーム、1本の動画から無限のロボット訓練場を生成する手法を発表
エンボディッド・インテリジェンスにおいて、シミュレーションと現実のギャップを埋めること――いわゆる「Sim2Real」――は、長年にわたり解決すべき課題として残されてきました。シミュレーション環境の構築には多額の費用がかかり、また、物理的な環境にモデルを導入すると、その性能が低下してしまうことが頻繁にあります。 李飛飛(Li Fei-Fei)氏のチーム、NVIDIA GEAR Lab、ジョージア工
アドビ・クリエイター・レポート:80%が「AIがファン層の拡大とビジネスの成長を促進している」と回答
人工知能の世界的な普及が加速する中、コンテンツ制作業界は根本的な変革を遂げつつあります。クリエイティブAIツールはもはや単なるワークフローの効率化ツールにとどまらず、ビジネスの成長を牽引し、クリエイターがより多くの視聴者を獲得できるよう支援しています。生産性と競争力の向上アドビが最近発表した「2026年クリエイター・ツールキット・レポート」では、世界中のクリエイター16,000人を対象に調査が行わ
Google、AIデザイン分野での主要プレイヤーであることを宣言
火曜日の年間I/Oカンファレンスにおいて、GoogleはGoogle Workspace向けの新しいAI駆動のデザインおよび画像作成ツール「Pics」を発表した。同社は、このアプリはアクセシビリティを重視して構築されており、教育者から小規模事業者まで、すべてのユーザーに提供されていると述べている。Picsを使用すれば、高度な編集スキルや専門的なソフトウェアを必要とせず、シンプルなテキストプロンプトからソーシャルメディア用のグラフィック、招待状、マーケティング素材、モックアップを作成できる。視覚
関連特集おすすめ
仕事
 スタートアップの事業検証に役立つAIビジネスプラン作成ツール
2026年最新版:スタートアップの事業検証に最適なAIビジネスプランツール!XIX.AIは、実環境でのテストを経て正確な結果をもたらす、画期的な高評価ツールを厳選しました。 無料版と有料版の比較、詳細なランキング、そしてわかりやすい分析情報が掲載されており、最適なソリューション選びとスタートアップの成功率向上に役立ちます。今すぐチェックして、AIの優位性を手に入れましょう!
 9 ツール
 xix.ai
チャットボット
ロールプレイと会話練習のためのAIチャットアプリ
2026年最新版!ロールプレイと会話練習に最適なAIチャットアプリBEST!XIX.AIは、厳格な実世界テストを経て卓越した結果をもたらす強力な必須ツールを厳選した高評価リストを提供しています。無料版と有料版の詳細比較、包括的なランキング、これらのアプリがどのように言語スキルとコミュニケーションの自信を効果的に向上させるかに関する洞察をご覧いただけます。今すぐ探索して、練習に最適な完璧なツールを見つけましょう!
10 ツール
xix.ai
デザイン
プロダクトチームに最適なAIワイヤーフレームツール
2026年版 プロダクトチーム向け最新・最高評価のAIワイヤーフレームツール!この厳選リストでは、実地テストと厳格なランキングを通じて、生産性を大幅に向上させる、強力で画期的なソリューションを紹介しています。最適なツールを見つけるお手伝いをするため、無料版と有料版の詳細な比較も掲載しています。XIX.AIは、意思決定の指針となる専門家の知見を提供します。 今すぐチェックして、最適なツールを見つけ、プロダクト開発におけるAIの優位性を手に入れましょう!
8 ツール
xix.ai
ソフトウェア開発
デプロイメント監視のためのベストなAI DevOpsツール
2026年の最新・最高評価のAI DevOpsツールが、当社の厳選リストで紹介されています。これらの強力なツールは、実際のテストと厳格なランキングを通じて、チームの生産性を大幅に向上させるのに役立ちます。無料版と有料版の比較を無料で入手し、あなたのニーズに最適なオプションを見つけてください。今すぐ探索して、AIによる優位性を解き放ちましょう!
11 ツール
xix.ai
データ分析
ExcelおよびSQLのための最高のAIデータ分析ツール
2026年最新版・最高評価のAIデータ分析ツール【ExcelおよびSQL対応】がXIX.AIにて公開中!厳選リストには、データ処理の高速化、生産性の向上、分析課題の克服を支援する革新的なソリューションが含まれています。パフォーマンス、使いやすさ、コストパフォーマンスに基づいた正確なランキングを提供するため、実際の環境でのテストを実施しました。今すぐチェックして、あなたのニーズに完璧に合う必須ツールを見つけ、データ業務におけるAIの優位性を解き放ってください。
10 ツール
xix.ai
テキスト読み上げ
長編エピソード、ホストのCM、オーディオ講座向けのAIポッドキャスト音声クローンツール
2026年最新の、高評価を得ているAIポッドキャスト・ボイスクローニングツールを、長編エピソード、ホスト向け広告、オーディオコース向けに厳選してご紹介します。これらの強力で画期的なソリューションは、信頼性を確保するために実環境でのテストを経ています。 無料版と有料版の比較や詳細なランキングもご覧いただけます。XIX.AIは、生産性を大幅に向上させる「必試」のツール群を提供しています。今すぐチェックして、あなたにぴったりのツールを見つけ、AIの力を最大限に引き出しましょう。
9 ツール
xix.ai

 コメント (0)
0/500
5月11日、Mingshi Intelligenceは清華大学およびオープンソースコミュニティ「OpenBMB」と提携し、新たなエッジサイド向けマルチモーダル大規模モデル「MiniCPM-V4.6」を発表した。 パラメータ数はわずか13億とコンパクトなサイズでありながら、この軽量モデルは卓越した知能密度とクロスプラットフォーム対応力を備え、大規模モデルの限界を押し広げ、エッジ側AIの実用化を加速させます。
1. ピークパフォーマンス:13億パラメータが卓越した結果をもたらす
MiniCPM-V4.6には「Instruct」と「Thinking」の2つのバージョンがあり、いずれも同規模のモデルと比較して、さまざまなベンチマークにおいて優れた推論能力と理解力を発揮しています。
世界トップクラスの性能:Artificial Analysis(AA)のリーダーボードにおいて、 MiniCPM-V4.6は13ポイントという驚異的なスコアを記録し、同規模の競合モデル(例:アリババのQwen3.5-0.8BやGoogleのGemma4-E2B-it)を大幅に上回り、Qwen3.5-2Bのような大規模モデルの性能にほぼ匹敵しました。 これにより、10億パラメータモデルにおける新たなベンチマークが確立されました。
高度な機能:一般的な画像・テキストの理解や複雑なSTEM(科学・技術・工学・数学)分野の推論から、難易度の高い文書OCRや動画の時系列理解に至るまで、本モデルは強力な知能を発揮します。特に「Thinking」バージョンは、複数画像を用いた推論や幻覚の抑制において卓越した性能を示します。
2. 効率性の飛躍:エッジにおける極限の知能密度
エッジ展開におけるメモリの制約に対処するため、MiniCPM-V4.6は推論速度とリソース効率の面で徹底的に最適化されています。
低メモリ消費:メモリ要件はわずか6GBに抑えられ、一般的なスマートフォン、PC、スマートホームデバイスでのスムーズな動作を実現します。
推論効率:vLLMを搭載し、推論スループットは競合モデルの1.5倍に達します。エッジ環境で3136²の超高解像度画像を処理する場合、初回応答遅延はわずか75.7msであり、競合モデルよりも2.2倍高速です。
スループット:単一のGPUで、1秒あたり7,013トークンのテキスト生成が可能であり、1,344²の画像を1秒あたり54.79枚のペースで処理でき、卓越した効率性を発揮します。
3. コア技術:LLaVA-UHD v4によるオーバーヘッドの最小化
このモデルの軽量設計は、Mingshi Intelligenceと清華大学が共同開発したLLaVA-UHD v4によって実現されています。
エンコーディングの再設計:改良されたViT画像エンコーディングと浅層圧縮モジュールにより、画像エンコーディングのオーバーヘッドを50%、高解像度浮動小数点演算を55.8%削減しました。
ハイブリッド圧縮:4×/16×のハイブリッドトークン圧縮を導入し、性能優先モードと速度優先モードの柔軟な切り替えを可能にしました。この技術は、膨大なトラフィックを処理するKuaishouのレコメンデーションモデル「OneRec」において実証済みです。
4. エコシステムへの展開:研究室から実産業へ
MiniCPM-V4.6のオープンソースリリースは、技術面およびエコシステム面における重要なマイルストーンとなります。
容易な開発:ms-swiftやLLaMA-Factoryなどの微調整フレームワークとシームレスに統合され、単一のRTX 4090 GPU上で本格的な微調整が可能になります。
クロスプラットフォーム対応:vLLM、Ollama、その他の主要フレームワークと互換性があり、iOS、Android、HarmonyOS向けのテスト版を提供することで、より幅広いハードウェアにAIを導入します。
実社会への影響:このモデルシリーズはすでに、自動車、PC、スマートホーム、産業用検査の各分野で導入されており、Lenovo、Geely、SAIC Volkswagen、Xiaomi、OPPOなどがパートナーとして参画しています。








 李飛飛氏のチーム、1本の動画から無限のロボット訓練場を生成する手法を発表
エンボディッド・インテリジェンスにおいて、シミュレーションと現実のギャップを埋めること――いわゆる「Sim2Real」――は、長年にわたり解決すべき課題として残されてきました。シミュレーション環境の構築には多額の費用がかかり、また、物理的な環境にモデルを導入すると、その性能が低下してしまうことが頻繁にあります。 李飛飛(Li Fei-Fei)氏のチーム、NVIDIA GEAR Lab、ジョージア工
 アドビ・クリエイター・レポート:80%が「AIがファン層の拡大とビジネスの成長を促進している」と回答
人工知能の世界的な普及が加速する中、コンテンツ制作業界は根本的な変革を遂げつつあります。クリエイティブAIツールはもはや単なるワークフローの効率化ツールにとどまらず、ビジネスの成長を牽引し、クリエイターがより多くの視聴者を獲得できるよう支援しています。生産性と競争力の向上アドビが最近発表した「2026年クリエイター・ツールキット・レポート」では、世界中のクリエイター16,000人を対象に調査が行わ
 Google、AIデザイン分野での主要プレイヤーであることを宣言
火曜日の年間I/Oカンファレンスにおいて、GoogleはGoogle Workspace向けの新しいAI駆動のデザインおよび画像作成ツール「Pics」を発表した。同社は、このアプリはアクセシビリティを重視して構築されており、教育者から小規模事業者まで、すべてのユーザーに提供されていると述べている。Picsを使用すれば、高度な編集スキルや専門的なソフトウェアを必要とせず、シンプルなテキストプロンプトからソーシャルメディア用のグラフィック、招待状、マーケティング素材、モックアップを作成できる。視覚

2026年最新版:スタートアップの事業検証に最適なAIビジネスプランツール!XIX.AIは、実環境でのテストを経て正確な結果をもたらす、画期的な高評価ツールを厳選しました。 無料版と有料版の比較、詳細なランキング、そしてわかりやすい分析情報が掲載されており、最適なソリューション選びとスタートアップの成功率向上に役立ちます。今すぐチェックして、AIの優位性を手に入れましょう!
9 ツール
xix.ai

2026年最新版!ロールプレイと会話練習に最適なAIチャットアプリBEST!XIX.AIは、厳格な実世界テストを経て卓越した結果をもたらす強力な必須ツールを厳選した高評価リストを提供しています。無料版と有料版の詳細比較、包括的なランキング、これらのアプリがどのように言語スキルとコミュニケーションの自信を効果的に向上させるかに関する洞察をご覧いただけます。今すぐ探索して、練習に最適な完璧なツールを見つけましょう!
10 ツール
xix.ai

2026年版 プロダクトチーム向け最新・最高評価のAIワイヤーフレームツール!この厳選リストでは、実地テストと厳格なランキングを通じて、生産性を大幅に向上させる、強力で画期的なソリューションを紹介しています。最適なツールを見つけるお手伝いをするため、無料版と有料版の詳細な比較も掲載しています。XIX.AIは、意思決定の指針となる専門家の知見を提供します。 今すぐチェックして、最適なツールを見つけ、プロダクト開発におけるAIの優位性を手に入れましょう!
8 ツール
xix.ai
2026年の最新・最高評価のAI DevOpsツールが、当社の厳選リストで紹介されています。これらの強力なツールは、実際のテストと厳格なランキングを通じて、チームの生産性を大幅に向上させるのに役立ちます。無料版と有料版の比較を無料で入手し、あなたのニーズに最適なオプションを見つけてください。今すぐ探索して、AIによる優位性を解き放ちましょう!
11 ツール
xix.ai
2026年最新版・最高評価のAIデータ分析ツール【ExcelおよびSQL対応】がXIX.AIにて公開中!厳選リストには、データ処理の高速化、生産性の向上、分析課題の克服を支援する革新的なソリューションが含まれています。パフォーマンス、使いやすさ、コストパフォーマンスに基づいた正確なランキングを提供するため、実際の環境でのテストを実施しました。今すぐチェックして、あなたのニーズに完璧に合う必須ツールを見つけ、データ業務におけるAIの優位性を解き放ってください。
10 ツール
xix.ai
2026年最新の、高評価を得ているAIポッドキャスト・ボイスクローニングツールを、長編エピソード、ホスト向け広告、オーディオコース向けに厳選してご紹介します。これらの強力で画期的なソリューションは、信頼性を確保するために実環境でのテストを経ています。 無料版と有料版の比較や詳細なランキングもご覧いただけます。XIX.AIは、生産性を大幅に向上させる「必試」のツール群を提供しています。今すぐチェックして、あなたにぴったりのツールを見つけ、AIの力を最大限に引き出しましょう。
9 ツール
xix.ai












