


 Maison
L'attaque de réduction des dimensions du modèle 1.3B de MiniCPM-V 4.6 redéfinit la technologie multimodale en périphérie
Le 11 mai, Mingshi Intelligence s'est associée à l'université de Tsinghua et à la communauté open source OpenBMB pour dévoiler le nouveau modèle multimodal de grande envergure destiné à la périphérie , le MiniCPM-V4.6. Malgré sa taille compacte — seulement 1,3 milliard de paramètres —, ce modèle léger repousse les limites des modèles plus volumineux grâce à une densité intelligente exceptionnelle et à une adaptabilité multiplateforme, accélérant ainsi le déploiement concret de l’IA en périphérie.
1. Performances de pointe : 1,3 milliard de paramètres pour des résultats exceptionnels
MiniCPM-V4.6 se décline en deux versions — « Instruct » et « Thinking » — qui font toutes deux preuve d’une capacité de raisonnement et de compréhension impressionnante dans divers tests de performance, par rapport à des modèles de taille similaire.
Leadership mondial : dans le classement Artificial Analysis (AA), MiniCPM-V4.6 a obtenu un score impressionnant de 13 points, surpassant largement ses concurrents de taille similaire (par exemple, le Qwen3.5-0.8B d’Alibaba et le Gemma4-E2B-it de Google) tout en égalant presque les performances de modèles plus volumineux comme le Qwen3.5-2B. Cela établit une nouvelle référence pour les modèles à 1 milliard de paramètres.
Capacités avancées : De la compréhension générale image-texte et du raisonnement mathématique complexe en sciences, technologie, ingénierie et mathématiques (STEM) à la reconnaissance optique de caractères (OCR) de documents exigeants et à la compréhension temporelle des vidéos, le modèle fait preuve d’une grande intelligence. La version « Thinking », en particulier, excelle dans le raisonnement multi-images et la suppression des hallucinations.
2. Percée en matière d’efficacité : une densité intelligente extrême en périphérie
Pour pallier les contraintes de mémoire liées au déploiement en périphérie, MiniCPM-V4.6 a été profondément optimisé en termes de vitesse d’inférence et d’efficacité des ressources.
Faible empreinte mémoire : les besoins en mémoire sont réduits à seulement 6 Go, ce qui permet un fonctionnement fluide sur les smartphones, PC et appareils domestiques connectés courants.
Efficacité de l’inférence : grâce à la technologie vLLM, le débit d’inférence est 1,5 fois supérieur à celui des concurrents. Lors du traitement d’une image ultra-haute définition de 3 136² à la périphérie, la latence de la première réponse n’est que de 75,7 ms, soit 2,2 fois plus rapide que les modèles concurrents.
Débit : un seul GPU permet de générer du texte à un rythme de 7 013 tokens par seconde et peut traiter des images de 1 344² à une cadence de 54,79 images par seconde, démontrant ainsi une efficacité remarquable.
3. Technologie de base : LLaVA-UHD v4 minimise la surcharge
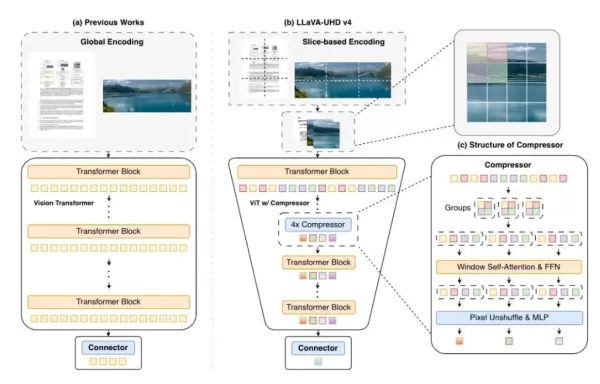
La conception allégée du modèle est rendue possible par LLaVA-UHD v4, développé conjointement par Mingshi Intelligence et l’université de Tsinghua.
Refonte de l’encodage : grâce à un module d’encodage d’images ViT repensé et à un module de compression superficielle, la surcharge liée à l’encodage des images est réduite de 50 % et les opérations en virgule flottante haute résolution de 55,8 %.
Compression hybride : elle introduit une compression hybride de jetons 4×/16× qui permet de basculer de manière flexible entre les modes « performance d’abord » et « vitesse d’abord ». Cette technologie a été validée dans le modèle de recommandation OneRec de Kuaishou, qui gère un trafic massif.
4. Déploiement dans l’écosystème : du laboratoire à l’industrie
La publication en open source de MiniCPM-V4.6 marque une étape importante tant sur le plan technique que pour l’écosystème.
Développement simplifié : elle s’intègre de manière transparente à des frameworks de réglage fin tels que ms-swift et LLaMA-Factory, permettant un réglage fin à grande échelle sur un seul GPU RTX 4090.
Prise en charge multiplateforme : compatible avec vLLM, Ollama et d’autres frameworks majeurs, il propose des versions de test pour iOS, Android et HarmonyOS, étendant ainsi l’IA à une gamme plus large de matériels.
Impact concret : cette série de modèles est déjà déployée dans les secteurs de l’automobile, de l’informatique, de la maison connectée et de l’inspection industrielle, avec des partenaires tels que Lenovo, Geely, SAIC Volkswagen, Xiaomi et OPPO.
Article connexe
 L'équipe de Li Feifei dévoile une méthode permettant de générer une infinité de terrains d'entraînement pour robots à partir d'une seule vidéo
Dans le domaine de l’intelligence incarnée, combler le fossé entre la simulation et la réalité — un processus connu sous le nom de « Sim2Real » — constitue depuis longtemps un obstacle tenace. Les ins
Rapport Adobe Creator : 80 % des personnes interrogées affirment que l'IA favorise la croissance de leur communauté et de leur activité
Alors que l'intelligence artificielle accélère son expansion mondiale, le secteur de la création de contenu connaît une mutation profonde. Les outils d'IA créative ne se contentent plus d'optimiser le
Google se déclare un acteur majeur dans la conception de l'IA
Lors de sa conférence annuelle I/O mardi, Google a dévoilé Pics, un nouvel outil de conception et de création d’images alimenté par l’intelligence artificielle pour Google Workspace. L’entreprise indique que cette application est conçue pour être acc
Recommandations de sujets spéciaux liés
Entreprise
 Outils de plan d'affaires basés sur l'IA pour la validation des start-ups
Les meilleurs outils de 2026 pour élaborer un business plan basé sur l'IA et valider votre start-up ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour fournir des résultats précis. Vous y trouverez un comparatif entre les versions gratuites et payantes, des classements détaillés et des analyses claires pour vous aider à choisir la solution idéale et à augmenter les chances de réussite de votre start-up. Découvrez-les dès maintenant pour exploiter pleinement votre avantage en matière d’IA !
 9 outils
 xix.ai
chatbot
Applications de chat IA pour le jeu de rôle et la pratique de la conversation
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle et la Pratique de la Conversation ! XIX.AI sélectionne une liste hautement évaluée d’outils puissants à absolument essayer, qui ont subi des tests rigoureux dans des conditions réelles pour offrir des résultats exceptionnels. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements complets, ainsi que des analyses sur la manière dont ces applications peuvent améliorer efficacement vos compétences linguistiques et votre confiance en communication. Explorez dès maintenant pour découvrir l’outil parfait adapté à vos besoins de pratique !
10 outils
xix.ai
conception
Les meilleurs outils de création de maquettes fonctionnelles basés sur l'IA pour les équipes produit
Les meilleurs outils de wireframing basés sur l'IA les mieux notés de 2026 pour les équipes produit ! Cette sélection présente des solutions puissantes et révolutionnaires qui améliorent considérablement la productivité, validées par des tests concrets et un classement rigoureux. Elle comprend une comparaison détaillée entre les versions gratuites et payantes pour vous aider à trouver celle qui vous convient le mieux. XIX.AI vous propose des conseils d'experts pour vous guider dans votre choix. Découvrez dès maintenant l'outil qui vous convient le mieux et tirez pleinement parti de l'IA pour le développement de vos produits !
8 outils
xix.ai
Développement de logiciels
Meilleurs outils DevOps d’IA pour la surveillance du déploiement
Les meilleurs outils d’IA DevOps les plus récents de 2026, classés parmi les mieux notés pour le déploiement et la surveillance, sont présentés ici dans notre liste soigneusement sélectionnée. Ces outils puissants aident les équipes à augmenter considérablement leur productivité grâce à des tests concrets et à des classements rigoureux. Obtenez une comparaison gratuite entre les versions gratuites et payantes afin de trouver l’option idéale adaptée à vos besoins. Explorez dès maintenant pour débloquer votre avantage grâce à l’IA !
11 outils
xix.ai
Analyse des données
Meilleurs outils d’analyse de données par IA pour Excel et SQL
2026 Derniers Meilleurs Outils d'Analyse de Données par IA les mieux notés pour Excel et SQL sont ici sur XIX.AI ! Notre liste soigneusement sélectionnée comprend des solutions puissantes et révolutionnaires qui vous aident à accélérer le traitement des données, à améliorer la productivité et à surmonter les défis d'analyse. Nous avons réalisé des tests concrets pour fournir des classements précis basés sur les performances, la facilité d'utilisation et la valeur. Explorez dès maintenant pour trouver l'outil incontournable qui correspond parfaitement à vos besoins et Débloquez votre avantage IA dans le travail avec les données.
10 outils
xix.ai
Synthèse vocale
Outils d'IA de clonage vocal pour les podcasts destinés aux épisodes longs, aux publicités présentées par l'animateur et aux cours audio
2026 : vous trouverez ici une sélection des meilleurs outils de clonage vocal par IA pour les podcasts, les épisodes longs, les publicités d'animateurs et les cours audio. Ces solutions puissantes et révolutionnaires sont soumises à des tests en conditions réelles afin de garantir leur fiabilité. Vous trouverez ici un comparatif entre les versions gratuites et payantes, ainsi que des classements détaillés. XIX.AI propose une sélection incontournable qui améliore considérablement la productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux et tirer pleinement parti de l'IA.
9 outils
xix.ai

 commentaires (0)
Le 11 mai, Mingshi Intelligence s'est associée à l'université de Tsinghua et à la communauté open source OpenBMB pour dévoiler le nouveau modèle multimodal de grande envergure destiné à la périphérie , le MiniCPM-V4.6. Malgré sa taille compacte — seulement 1,3 milliard de paramètres —, ce modèle léger repousse les limites des modèles plus volumineux grâce à une densité intelligente exceptionnelle et à une adaptabilité multiplateforme, accélérant ainsi le déploiement concret de l’IA en périphérie.
1. Performances de pointe : 1,3 milliard de paramètres pour des résultats exceptionnels
MiniCPM-V4.6 se décline en deux versions — « Instruct » et « Thinking » — qui font toutes deux preuve d’une capacité de raisonnement et de compréhension impressionnante dans divers tests de performance, par rapport à des modèles de taille similaire.
Leadership mondial : dans le classement Artificial Analysis (AA), MiniCPM-V4.6 a obtenu un score impressionnant de 13 points, surpassant largement ses concurrents de taille similaire (par exemple, le Qwen3.5-0.8B d’Alibaba et le Gemma4-E2B-it de Google) tout en égalant presque les performances de modèles plus volumineux comme le Qwen3.5-2B. Cela établit une nouvelle référence pour les modèles à 1 milliard de paramètres.
Capacités avancées : De la compréhension générale image-texte et du raisonnement mathématique complexe en sciences, technologie, ingénierie et mathématiques (STEM) à la reconnaissance optique de caractères (OCR) de documents exigeants et à la compréhension temporelle des vidéos, le modèle fait preuve d’une grande intelligence. La version « Thinking », en particulier, excelle dans le raisonnement multi-images et la suppression des hallucinations.
2. Percée en matière d’efficacité : une densité intelligente extrême en périphérie
Pour pallier les contraintes de mémoire liées au déploiement en périphérie, MiniCPM-V4.6 a été profondément optimisé en termes de vitesse d’inférence et d’efficacité des ressources.
Faible empreinte mémoire : les besoins en mémoire sont réduits à seulement 6 Go, ce qui permet un fonctionnement fluide sur les smartphones, PC et appareils domestiques connectés courants.
Efficacité de l’inférence : grâce à la technologie vLLM, le débit d’inférence est 1,5 fois supérieur à celui des concurrents. Lors du traitement d’une image ultra-haute définition de 3 136² à la périphérie, la latence de la première réponse n’est que de 75,7 ms, soit 2,2 fois plus rapide que les modèles concurrents.
Débit : un seul GPU permet de générer du texte à un rythme de 7 013 tokens par seconde et peut traiter des images de 1 344² à une cadence de 54,79 images par seconde, démontrant ainsi une efficacité remarquable.
3. Technologie de base : LLaVA-UHD v4 minimise la surcharge
La conception allégée du modèle est rendue possible par LLaVA-UHD v4, développé conjointement par Mingshi Intelligence et l’université de Tsinghua.
Refonte de l’encodage : grâce à un module d’encodage d’images ViT repensé et à un module de compression superficielle, la surcharge liée à l’encodage des images est réduite de 50 % et les opérations en virgule flottante haute résolution de 55,8 %.
Compression hybride : elle introduit une compression hybride de jetons 4×/16× qui permet de basculer de manière flexible entre les modes « performance d’abord » et « vitesse d’abord ». Cette technologie a été validée dans le modèle de recommandation OneRec de Kuaishou, qui gère un trafic massif.
4. Déploiement dans l’écosystème : du laboratoire à l’industrie
La publication en open source de MiniCPM-V4.6 marque une étape importante tant sur le plan technique que pour l’écosystème.
Développement simplifié : elle s’intègre de manière transparente à des frameworks de réglage fin tels que ms-swift et LLaMA-Factory, permettant un réglage fin à grande échelle sur un seul GPU RTX 4090.
Prise en charge multiplateforme : compatible avec vLLM, Ollama et d’autres frameworks majeurs, il propose des versions de test pour iOS, Android et HarmonyOS, étendant ainsi l’IA à une gamme plus large de matériels.
Impact concret : cette série de modèles est déjà déployée dans les secteurs de l’automobile, de l’informatique, de la maison connectée et de l’inspection industrielle, avec des partenaires tels que Lenovo, Geely, SAIC Volkswagen, Xiaomi et OPPO.








 L'équipe de Li Feifei dévoile une méthode permettant de générer une infinité de terrains d'entraînement pour robots à partir d'une seule vidéo
Dans le domaine de l’intelligence incarnée, combler le fossé entre la simulation et la réalité — un processus connu sous le nom de « Sim2Real » — constitue depuis longtemps un obstacle tenace. Les ins
 Rapport Adobe Creator : 80 % des personnes interrogées affirment que l'IA favorise la croissance de leur communauté et de leur activité
Alors que l'intelligence artificielle accélère son expansion mondiale, le secteur de la création de contenu connaît une mutation profonde. Les outils d'IA créative ne se contentent plus d'optimiser le
 Google se déclare un acteur majeur dans la conception de l'IA
Lors de sa conférence annuelle I/O mardi, Google a dévoilé Pics, un nouvel outil de conception et de création d’images alimenté par l’intelligence artificielle pour Google Workspace. L’entreprise indique que cette application est conçue pour être acc

Les meilleurs outils de 2026 pour élaborer un business plan basé sur l'IA et valider votre start-up ! XIX.AI a sélectionné une liste des outils les mieux notés, puissants et révolutionnaires, qui ont fait leurs preuves dans la pratique pour fournir des résultats précis. Vous y trouverez un comparatif entre les versions gratuites et payantes, des classements détaillés et des analyses claires pour vous aider à choisir la solution idéale et à augmenter les chances de réussite de votre start-up. Découvrez-les dès maintenant pour exploiter pleinement votre avantage en matière d’IA !
9 outils
xix.ai

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle et la Pratique de la Conversation ! XIX.AI sélectionne une liste hautement évaluée d’outils puissants à absolument essayer, qui ont subi des tests rigoureux dans des conditions réelles pour offrir des résultats exceptionnels. Vous y trouverez des comparaisons détaillées entre les versions gratuites et payantes, des classements complets, ainsi que des analyses sur la manière dont ces applications peuvent améliorer efficacement vos compétences linguistiques et votre confiance en communication. Explorez dès maintenant pour découvrir l’outil parfait adapté à vos besoins de pratique !
10 outils
xix.ai

Les meilleurs outils de wireframing basés sur l'IA les mieux notés de 2026 pour les équipes produit ! Cette sélection présente des solutions puissantes et révolutionnaires qui améliorent considérablement la productivité, validées par des tests concrets et un classement rigoureux. Elle comprend une comparaison détaillée entre les versions gratuites et payantes pour vous aider à trouver celle qui vous convient le mieux. XIX.AI vous propose des conseils d'experts pour vous guider dans votre choix. Découvrez dès maintenant l'outil qui vous convient le mieux et tirez pleinement parti de l'IA pour le développement de vos produits !
8 outils
xix.ai
Les meilleurs outils d’IA DevOps les plus récents de 2026, classés parmi les mieux notés pour le déploiement et la surveillance, sont présentés ici dans notre liste soigneusement sélectionnée. Ces outils puissants aident les équipes à augmenter considérablement leur productivité grâce à des tests concrets et à des classements rigoureux. Obtenez une comparaison gratuite entre les versions gratuites et payantes afin de trouver l’option idéale adaptée à vos besoins. Explorez dès maintenant pour débloquer votre avantage grâce à l’IA !
11 outils
xix.ai
2026 Derniers Meilleurs Outils d'Analyse de Données par IA les mieux notés pour Excel et SQL sont ici sur XIX.AI ! Notre liste soigneusement sélectionnée comprend des solutions puissantes et révolutionnaires qui vous aident à accélérer le traitement des données, à améliorer la productivité et à surmonter les défis d'analyse. Nous avons réalisé des tests concrets pour fournir des classements précis basés sur les performances, la facilité d'utilisation et la valeur. Explorez dès maintenant pour trouver l'outil incontournable qui correspond parfaitement à vos besoins et Débloquez votre avantage IA dans le travail avec les données.
10 outils
xix.ai
2026 : vous trouverez ici une sélection des meilleurs outils de clonage vocal par IA pour les podcasts, les épisodes longs, les publicités d'animateurs et les cours audio. Ces solutions puissantes et révolutionnaires sont soumises à des tests en conditions réelles afin de garantir leur fiabilité. Vous trouverez ici un comparatif entre les versions gratuites et payantes, ainsi que des classements détaillés. XIX.AI propose une sélection incontournable qui améliore considérablement la productivité. Explorez-la dès maintenant pour découvrir l'outil qui vous convient le mieux et tirer pleinement parti de l'IA.
9 outils
xix.ai












