


 首页
MiniCPM-V 4.6 的 1.3B 模型维度缩减技术重新定义了边缘多模态技术
5月11日,明视智能携手清华大学和OpenBMB开源社区,共同发布了全新的边缘端多模态大模型MiniCPM-V4.6。 尽管该模型规模精简——仅含13亿个参数——但凭借卓越的智能密度和跨平台适应性,这款轻量级模型突破了大型模型的局限,加速了边缘AI在实际场景中的部署。
1. 巅峰性能:13亿参数带来卓越表现
MiniCPM-V4.6 提供“Instruct”和“Thinking”两个版本,与同等规模的模型相比,两者在各类基准测试中均展现出令人印象深刻的推理和理解能力。
全球领先:在人工分析(AA)排行榜上, MiniCPM-V4.6 取得了令人瞩目的13 分,远超同等规模的竞争对手(如阿里巴巴的 Qwen3.5-0.8B 和谷歌的 Gemma4-E2B-it),同时其性能几乎可与 Qwen3.5-2B 等更大规模模型相媲美。 这为10亿参数模型树立了新的标杆。
先进能力:从通用图文理解、复杂的STEM数学推理,到高难度的文档OCR和视频时序理解,该模型均展现出强大的智能。其中,“Thinking”版本在多图推理和幻觉抑制方面尤为出色。
2. 效率突破:边缘端的极致智能密度
为解决边缘部署中的内存限制问题,MiniCPM-V4.6 在推理速度和资源效率方面进行了深度优化。
低内存占用:内存需求降至仅6GB,可在主流智能手机、PC 和智能家居设备上流畅运行。
推理效率:依托 vLLM 技术,推理吞吐量达到竞争对手的 1.5 倍。在边缘端处理 3136² 超高清图像时,首次响应延迟仅为75.7 毫秒——比竞争模型快 2.2 倍。
吞吐量:单张GPU每秒可生成7,013个令牌的文本,并以每秒54.79张的速度处理1,344²张图像,展现出卓越的效率。
3. 核心技术:LLaVA-UHD v4 最大限度降低开销
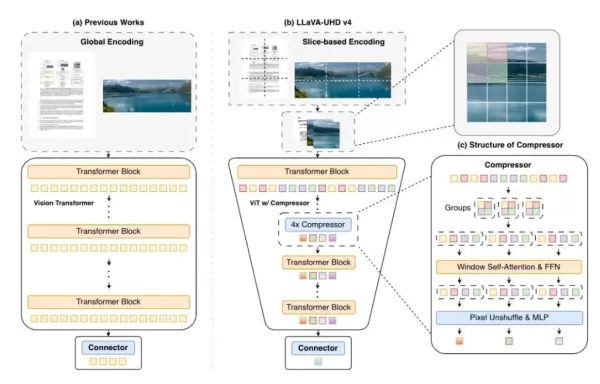
该模型的轻量级设计得益于明视智能与清华大学联合开发的LLaVA-UHD v4。
编码重构:通过重新设计的ViT图像编码和浅层压缩模块,图像编码开销减少50%,高精度浮点运算开销减少55.8%。
混合压缩:引入了4×/16×混合令牌压缩技术,可在“性能优先”和“速度优先”模式之间灵活切换。该技术已在快手推荐模型OneRec中经过验证,能够处理海量流量。
4. 生态系统部署:从实验室走向产业
MiniCPM-V4.6 的开源发布标志着技术与生态系统双重里程碑。
开发便捷:它与 ms-swift 和 LLaMA-Factory 等微调框架无缝集成,支持在单块 RTX 4090 GPU 上进行全规模微调。
跨平台支持:兼容 vLLM、Ollama 及其他主流框架,并提供适用于 iOS、Android 和 HarmonyOS 的测试版本,将 AI 带入更广泛的硬件领域。
实际应用影响:该模型系列已部署于汽车、PC、智能家居及工业检测等领域,合作伙伴包括联想、吉利、上汽大众、小米和OPPO。
相关文章
 李飞飞团队公布了一种从单段视频中生成无限机器人训练场的方法
在具身智能领域,弥合模拟与现实之间的鸿沟——即所谓的“Sim2Real”——长期以来一直是一道难以逾越的障碍。模拟实验环境成本高昂,且模型在实际环境中部署时,性能往往会下降。 李飞飞团队、NVIDIA GEAR Lab 以及佐治亚理工学院近期开展的一项合作研究提出了一种创新解决方案:Real2Sim。该系统名为“SimFoundry”,能够利用简单的真实世界视频创建交互式、可训练且可测试的机器人仿
Adobe创作者报告:80%的受访者表示人工智能推动了粉丝数量和业务的增长
随着人工智能在全球范围内的加速普及,内容创作领域正经历着一场根本性的变革。创意人工智能工具不再仅仅是工作流程的优化工具,它们正在推动业务增长,并帮助创作者拓展更广泛的受众群体。提升生产力与竞争优势Adobe 最近发布的《2026 年创作者工具包报告》对全球 16,000 名创作者进行了调查,结果显示 75% 的受访者现已将创意 AI 作为其工作流程的核心部分。AI的整合极大地缩短了制作时间,直接推
谷歌宣布自己成为人工智能设计领域的重要参与者
在周二的年度 I/O 大会上,Google 发布了 Pics,这是一款面向 Google Workspace 的全新 AI 驱动设计与图像创建工具。该公司表示,该应用旨在提升可访问性,服务于从教育工作者到小企业主等各类用户。Pics 允许用户使用简单的文本提示创建社交媒体图形、邀请函、营销素材和样机,无需具备高级编辑技能或专业软件。通过简化视觉创作,Google 旨在与 Canva 等成熟设计平台以及 Anthropic 的 Claude Design 等原生 AI 产品展开竞争。此举凸显了
相关专题推荐
商业
 用于初创企业验证的AI商业计划书工具
2026年最新最佳AI商业计划工具,助力初创企业验证!XIX.AI精心筛选出一份备受好评的榜单,收录了经过实际测试、能够提供精准结果的强大且具有颠覆性的工具。 您将看到免费版与付费版的对比分析、详细排名以及通俗易懂的深度解析,助您选择最合适的解决方案,从而提升初创企业的成功率。立即探索,释放您的AI竞争优势!
 9 个工具
 xix.ai
聊天机器人
用于角色扮演和对话练习的 AI 聊天应用
2026 年最新最佳角色扮演与对话练习 AI 聊天应用!XIX.AI 精心策划了一份顶级评分列表,收录了经过严格现实世界测试、能带来卓越结果的重磅必备工具。您将找到详细的免费与付费对比、全面排名,以及这些应用如何有效提升您的语言技能和沟通自信的见解。立即探索,发现最适合您的练习工具!
10 个工具
xix.ai
设计
适合产品团队的最佳 AI 线框图工具
2026年产品团队必备的最新最佳高评分AI线框图工具!这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,这些工具经过实际测试和严格排名,能显著提升工作效率。其中包含详细的免费版与付费版对比分析,助您找到最适合的工具。XIX.AI 提供专家见解,为您决策提供指导。 立即探索,发现最适合您的工具,在产品开发中释放您的 AI 优势!
8 个工具
xix.ai
软件开发
部署监控的最佳 AI DevOps 工具
我们精心整理的这份清单中,收录了2026年最新、最受欢迎且评价最高的AI DevOps部署监控工具。这些功能强大的工具经过实际测试和严格评估,可帮助团队显著提升工作效率。查看免费版与付费版的对比,找到最适合您需求的理想方案。立即探索,释放您的AI优势!
11 个工具
xix.ai
数据分析
适用于 Excel 和 SQL 的最佳 AI 数据分析工具
2026 年最新、最佳、顶级评价的 AI 数据分析工具,适用于 Excel 和 SQL,现已在 XIX.AI 上线!我们精心策划的列表包含强大且能改变游戏规则的工具,帮助您加快数据处理速度、提高生产力并克服分析挑战。我们进行了真实场景测试,根据性能、易用性和价值提供准确的排名。立即探索,找到最适合您的必试工具,释放您在数据工作中的 AI 优势。
10 个工具
xix.ai
文字转语音
适用于长篇播客、主持人广告和音频课程的AI播客语音克隆工具
本文精选了2026年最新、最受欢迎且评价最高的人工智能播客语音克隆工具,适用于长篇剧集、主持人广告和音频课程。这些功能强大、具有颠覆性的解决方案均经过实际测试,以确保其可靠性。 您可在此查阅免费版与付费版的对比分析及详细排名。XIX.AI 精选了一系列必试工具,能显著提升工作效率。立即探索,找到最适合您的工具,释放您的 AI 优势。
9 个工具
xix.ai

 评论 (0)
0/500
5月11日,明视智能携手清华大学和OpenBMB开源社区,共同发布了全新的边缘端多模态大模型MiniCPM-V4.6。 尽管该模型规模精简——仅含13亿个参数——但凭借卓越的智能密度和跨平台适应性,这款轻量级模型突破了大型模型的局限,加速了边缘AI在实际场景中的部署。
1. 巅峰性能:13亿参数带来卓越表现
MiniCPM-V4.6 提供“Instruct”和“Thinking”两个版本,与同等规模的模型相比,两者在各类基准测试中均展现出令人印象深刻的推理和理解能力。
全球领先:在人工分析(AA)排行榜上, MiniCPM-V4.6 取得了令人瞩目的13 分,远超同等规模的竞争对手(如阿里巴巴的 Qwen3.5-0.8B 和谷歌的 Gemma4-E2B-it),同时其性能几乎可与 Qwen3.5-2B 等更大规模模型相媲美。 这为10亿参数模型树立了新的标杆。
先进能力:从通用图文理解、复杂的STEM数学推理,到高难度的文档OCR和视频时序理解,该模型均展现出强大的智能。其中,“Thinking”版本在多图推理和幻觉抑制方面尤为出色。
2. 效率突破:边缘端的极致智能密度
为解决边缘部署中的内存限制问题,MiniCPM-V4.6 在推理速度和资源效率方面进行了深度优化。
低内存占用:内存需求降至仅6GB,可在主流智能手机、PC 和智能家居设备上流畅运行。
推理效率:依托 vLLM 技术,推理吞吐量达到竞争对手的 1.5 倍。在边缘端处理 3136² 超高清图像时,首次响应延迟仅为75.7 毫秒——比竞争模型快 2.2 倍。
吞吐量:单张GPU每秒可生成7,013个令牌的文本,并以每秒54.79张的速度处理1,344²张图像,展现出卓越的效率。
3. 核心技术:LLaVA-UHD v4 最大限度降低开销
该模型的轻量级设计得益于明视智能与清华大学联合开发的LLaVA-UHD v4。
编码重构:通过重新设计的ViT图像编码和浅层压缩模块,图像编码开销减少50%,高精度浮点运算开销减少55.8%。
混合压缩:引入了4×/16×混合令牌压缩技术,可在“性能优先”和“速度优先”模式之间灵活切换。该技术已在快手推荐模型OneRec中经过验证,能够处理海量流量。
4. 生态系统部署:从实验室走向产业
MiniCPM-V4.6 的开源发布标志着技术与生态系统双重里程碑。
开发便捷:它与 ms-swift 和 LLaMA-Factory 等微调框架无缝集成,支持在单块 RTX 4090 GPU 上进行全规模微调。
跨平台支持:兼容 vLLM、Ollama 及其他主流框架,并提供适用于 iOS、Android 和 HarmonyOS 的测试版本,将 AI 带入更广泛的硬件领域。
实际应用影响:该模型系列已部署于汽车、PC、智能家居及工业检测等领域,合作伙伴包括联想、吉利、上汽大众、小米和OPPO。








 李飞飞团队公布了一种从单段视频中生成无限机器人训练场的方法
在具身智能领域,弥合模拟与现实之间的鸿沟——即所谓的“Sim2Real”——长期以来一直是一道难以逾越的障碍。模拟实验环境成本高昂,且模型在实际环境中部署时,性能往往会下降。 李飞飞团队、NVIDIA GEAR Lab 以及佐治亚理工学院近期开展的一项合作研究提出了一种创新解决方案:Real2Sim。该系统名为“SimFoundry”,能够利用简单的真实世界视频创建交互式、可训练且可测试的机器人仿
 Adobe创作者报告:80%的受访者表示人工智能推动了粉丝数量和业务的增长
随着人工智能在全球范围内的加速普及,内容创作领域正经历着一场根本性的变革。创意人工智能工具不再仅仅是工作流程的优化工具,它们正在推动业务增长,并帮助创作者拓展更广泛的受众群体。提升生产力与竞争优势Adobe 最近发布的《2026 年创作者工具包报告》对全球 16,000 名创作者进行了调查,结果显示 75% 的受访者现已将创意 AI 作为其工作流程的核心部分。AI的整合极大地缩短了制作时间,直接推
 谷歌宣布自己成为人工智能设计领域的重要参与者
在周二的年度 I/O 大会上,Google 发布了 Pics,这是一款面向 Google Workspace 的全新 AI 驱动设计与图像创建工具。该公司表示,该应用旨在提升可访问性,服务于从教育工作者到小企业主等各类用户。Pics 允许用户使用简单的文本提示创建社交媒体图形、邀请函、营销素材和样机,无需具备高级编辑技能或专业软件。通过简化视觉创作,Google 旨在与 Canva 等成熟设计平台以及 Anthropic 的 Claude Design 等原生 AI 产品展开竞争。此举凸显了
2026年最新最佳AI商业计划工具,助力初创企业验证!XIX.AI精心筛选出一份备受好评的榜单,收录了经过实际测试、能够提供精准结果的强大且具有颠覆性的工具。 您将看到免费版与付费版的对比分析、详细排名以及通俗易懂的深度解析,助您选择最合适的解决方案,从而提升初创企业的成功率。立即探索,释放您的AI竞争优势!
9 个工具
xix.ai
2026 年最新最佳角色扮演与对话练习 AI 聊天应用!XIX.AI 精心策划了一份顶级评分列表,收录了经过严格现实世界测试、能带来卓越结果的重磅必备工具。您将找到详细的免费与付费对比、全面排名,以及这些应用如何有效提升您的语言技能和沟通自信的见解。立即探索,发现最适合您的练习工具!
10 个工具
xix.ai
2026年产品团队必备的最新最佳高评分AI线框图工具!这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,这些工具经过实际测试和严格排名,能显著提升工作效率。其中包含详细的免费版与付费版对比分析,助您找到最适合的工具。XIX.AI 提供专家见解,为您决策提供指导。 立即探索,发现最适合您的工具,在产品开发中释放您的 AI 优势!
8 个工具
xix.ai
我们精心整理的这份清单中,收录了2026年最新、最受欢迎且评价最高的AI DevOps部署监控工具。这些功能强大的工具经过实际测试和严格评估,可帮助团队显著提升工作效率。查看免费版与付费版的对比,找到最适合您需求的理想方案。立即探索,释放您的AI优势!
11 个工具
xix.ai
2026 年最新、最佳、顶级评价的 AI 数据分析工具,适用于 Excel 和 SQL,现已在 XIX.AI 上线!我们精心策划的列表包含强大且能改变游戏规则的工具,帮助您加快数据处理速度、提高生产力并克服分析挑战。我们进行了真实场景测试,根据性能、易用性和价值提供准确的排名。立即探索,找到最适合您的必试工具,释放您在数据工作中的 AI 优势。
10 个工具
xix.ai
本文精选了2026年最新、最受欢迎且评价最高的人工智能播客语音克隆工具,适用于长篇剧集、主持人广告和音频课程。这些功能强大、具有颠覆性的解决方案均经过实际测试,以确保其可靠性。 您可在此查阅免费版与付费版的对比分析及详细排名。XIX.AI 精选了一系列必试工具,能显著提升工作效率。立即探索,找到最适合您的工具,释放您的 AI 优势。
9 个工具
xix.ai












