


 首頁
MiniCPM-V 4.6 的 1.3B 模型尺寸縮減技術,重新定義了邊緣多模態技術
5月11日,明智智能攜手清華大學及 OpenBMB 開源社群,正式發布了全新的邊緣端多模態大模型MiniCPM-V4.6。 儘管參數規模僅有 13 億,這款輕量級模型憑藉卓越的智能密度與跨平台適應性,突破了大型模型的極限,加速了邊緣端 AI 在現實世界的部署。
1. 巔峰效能:13 億參數展現卓越成果
MiniCPM-V4.6 提供「指令型」(Instruct)與「思考型」(Thinking)兩種版本,相較於同規模模型,兩者在各類基準測試中均展現出令人印象深刻的推理與理解能力。
全球領先:在人工分析(AA)排行榜上, MiniCPM-V4.6 取得令人驚豔的13 分,遠遠超越同規模的競爭對手(例如阿里巴巴的 Qwen3.5-0.8B 和 Google 的 Gemma4-E2B-it),同時表現幾乎可與 Qwen3.5-2B 等更大規模的模型相媲美。 這為 10 億參數模型樹立了新的標竿。
先進能力:從一般的圖文理解、複雜的 STEM 數學推理,到高難度的文件 OCR 及影片時序理解,該模型皆展現出強大的智能。其中,「Thinking」版本在多圖像推理與幻覺抑制方面尤為出色。
2. 效率突破:邊緣端的極致智能密度
為解決邊緣部署中的記憶體限制,MiniCPM-V4.6 針對推論速度與資源效率進行了深度優化。
低記憶體佔用:記憶體需求降至僅6GB,可在主流智慧型手機、個人電腦及智慧家庭裝置上流暢運作。
推論效率:憑藉 vLLM 技術驅動,推論吞吐量達競爭對手的 1.5 倍。在邊緣端處理 3136² 超高解析度影像時,首次回應延遲僅75.7 毫秒——比競爭模型快 2.2 倍。
吞吐量:單顆 GPU 可實現每秒 7,013 個標記的文字生成速度,並能以每秒 54.79 張的速率處理 1,344² 張影像,展現出卓越的效率。
3. 核心技術:LLaVA-UHD v4 將開銷降至最低
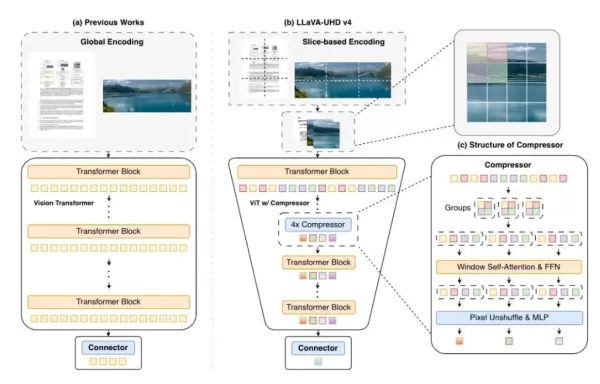
該模型的輕量級設計得益於由明視智能與清華大學共同開發的LLaVA-UHD v4。
編碼重新設計:透過重新設計的 ViT 影像編碼與淺層壓縮模組,將影像編碼開銷削減50%,並將高解析度浮點運算開銷降低55.8%。
混合壓縮:導入 4×/16× 混合標記壓縮技術,可在「效能優先」與「速度優先」模式之間靈活切換。此技術已於快手推薦模型 OneRec 中通過驗證,並能處理龐大流量。
4. 生態系部署:從實驗室到產業
MiniCPM-V4.6 的開源發布標誌著技術與生態系統的雙重里程碑。
簡易開發:它能與 ms-swift 和 LLaMA-Factory 等微調框架無縫整合,支援在單張 RTX 4090 GPU 上進行全面微調。
跨平台支援:相容於 vLLM、Ollama 及其他主要框架,並提供 iOS、Android 及 HarmonyOS 的測試版本,將 AI 帶入更廣泛的硬體領域。
實際應用影響:該模型系列已部署於汽車、個人電腦、智慧家庭及工業檢測等領域,合作夥伴包括聯想、吉利、上汽大眾、小米及 OPPO。
相關文章
 Adobe 創作者報告:80% 受訪者表示 AI 推動了粉絲數與業務的成長
隨著人工智慧加速全球擴張,內容創作領域正經歷根本性的轉變。創意人工智慧工具不再僅僅是工作流程的輔助工具;它們正推動業務成長,並協助創作者拓展更廣大的受眾群體。提升生產力與競爭優勢Adobe 近期發布的《2026 年創作者工具包報告》針對全球 16,000 名創作者進行了調查,結果顯示 75% 的受訪者現已將創意 AI 作為其工作流程的核心組成部分。AI 的整合大幅縮短了製作時間,直接提升了商業成功
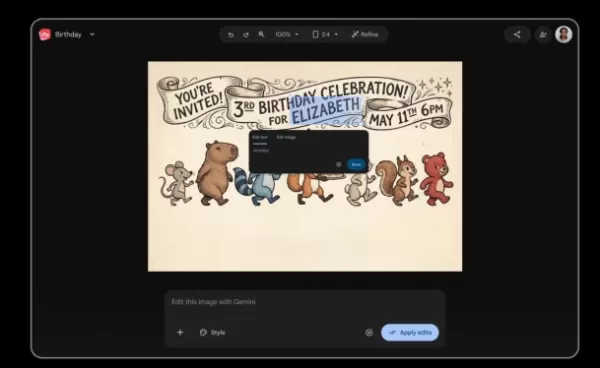
谷歌宣佈自己成為人工智慧設計領域的重要參與者
在週二的年度 I/O 大會上,Google 釋出了 Pics,這是一款面向 Google Workspace 的全新 AI 驅動設計與影象建立工具。該公司表示,該應用旨在提升可訪問性,服務於從教育工作者到小企業主等各類使用者。Pics 允許使用者使用簡單的文字提示建立社交媒體圖形、邀請函、營銷素材和樣機,無需具備高階編輯技能或專業軟體。透過簡化視覺創作,Google 旨在與 Canva 等成熟設計平臺以及 Anthropic 的 Claude Design 等原生 AI 產品展開競爭。此舉凸顯了
EverMind 向 ReUnite 投資 300 萬美元,利用 AI 長期記憶助力全球家庭團聚
EverMind,山東集團旗下的子公司,正式推出了“ReUnite”,這是一款由人工智慧驅動的公益工具,旨在透過先進的長期記憶技術,幫助全球分離的家庭團聚。該專案由一位化工行業的人工智慧工程師開發,源自EverMind開源社羣於2026年舉辦的“記憶創世大賽”。透過利用大模型在長期記憶和邏輯推理方面的能力,ReUnite對碎片化的身體特徵、童年記憶和日常習慣進行深度模糊匹配,有效跨越時間和空間的障礙,提高丟失線索的匹配成功率。憑藉技術創新和社會影響力,ReUnite榮獲大賽公益獎,並被選為E
相關專題推薦
聊天機器人
 用於角色扮演和對話練習的 AI 聊天應用
2026 年最新最佳角色扮演與對話練習 AI 聊天應用!XIX.AI 精心策劃了一份頂級評分列表,收錄了經過嚴格現實世界測試、能帶來卓越結果的重磅必備工具。您將找到詳細的免費與付費對比、全面排名,以及這些應用如何有效提升您的語言技能和溝通自信的見解。立即探索,發現最適合您的練習工具!
 10 個工具
 xix.ai
設計
最適合產品團隊的 AI 線框圖工具
2026 年最新、最佳且評價最高的 AI 線框圖工具,專為產品團隊打造!這份精心篩選的清單展示了多款強大且具顛覆性的解決方案,這些工具已通過實際測試與嚴格評比,能顯著提升工作效率。清單中包含詳盡的免費版與付費版比較,協助您找到最適合的工具。XIX.AI 提供專家見解,引導您做出決策。 立即探索,發掘最適合您的工具,並在產品開發中釋放您的 AI 優勢!
8 個工具
xix.ai
軟件開發
最佳的 AI DevOps 工具:用於部署監控
我們在此精心整理的清單中,收錄了 2026 年最新、最佳且評價最高的 AI DevOps 部署監控工具。這些強大的工具經過實際測試與嚴格評比,能協助團隊顯著提升生產力。透過免費版與付費版的比較,找出最符合您需求的理想方案。立即探索,釋放您的 AI 優勢!
11 個工具
xix.ai
數據分析
適用於 Excel 和 SQL 的最佳 AI 資料分析工具
2026 年最新、最佳、頂級評價的 AI 資料分析工具,適用於 Excel 和 SQL,現已在 XIX.AI 上線!我們精心策劃的列表包含強大且能改變遊戲規則的工具,幫助您加快資料處理速度、提高生產力並克服分析挑戰。我們進行了真實場景測試,根據效能、易用性和價值提供準確的排名。立即探索,找到最適合您的必試工具,釋放您在資料工作中的 AI 優勢。
10 個工具
xix.ai
文字轉語音
適用於長篇集數、主持人廣告及音頻課程的 AI 播客聲音複製工具
2026 年最新、最受好評的 AI 播客聲音複製工具精選集,適用於長篇集數、主持人廣告及音頻課程,均於此處精心彙整。這些強大且顛覆業界的解決方案皆經過實務測試,以確保其可靠性。 您可在此查閱免費版與付費版的比較分析,以及詳細的排名列表。XIX.AI 提供一系列絕對值得一試的精選工具,能顯著提升工作效率。立即探索,找出最適合您的工具,並釋放您的 AI 競爭優勢。
9 個工具
xix.ai
設計與藝術
適用於角色設定表、靈感板及簡報的 AI 視覺風格參考工具
2026 年最新最佳 AI 視覺風格參考工具,適用於角色設定表、 moodboard 及提案簡報,現已登陸 XIX.AI!這份精心精選的高評分清單收錄了經過嚴格實測、能徹底改變遊戲規則的強大工具。 您將在此找到免費與付費版本的對比、詳細排名,以及必試選項,助您激發創意並優化工作流程。立即探索,發掘能提升生產力的完美工具!
11 個工具
xix.ai

 評論 (0)
0/500
5月11日,明智智能攜手清華大學及 OpenBMB 開源社群,正式發布了全新的邊緣端多模態大模型MiniCPM-V4.6。 儘管參數規模僅有 13 億,這款輕量級模型憑藉卓越的智能密度與跨平台適應性,突破了大型模型的極限,加速了邊緣端 AI 在現實世界的部署。
1. 巔峰效能:13 億參數展現卓越成果
MiniCPM-V4.6 提供「指令型」(Instruct)與「思考型」(Thinking)兩種版本,相較於同規模模型,兩者在各類基準測試中均展現出令人印象深刻的推理與理解能力。
全球領先:在人工分析(AA)排行榜上, MiniCPM-V4.6 取得令人驚豔的13 分,遠遠超越同規模的競爭對手(例如阿里巴巴的 Qwen3.5-0.8B 和 Google 的 Gemma4-E2B-it),同時表現幾乎可與 Qwen3.5-2B 等更大規模的模型相媲美。 這為 10 億參數模型樹立了新的標竿。
先進能力:從一般的圖文理解、複雜的 STEM 數學推理,到高難度的文件 OCR 及影片時序理解,該模型皆展現出強大的智能。其中,「Thinking」版本在多圖像推理與幻覺抑制方面尤為出色。
2. 效率突破:邊緣端的極致智能密度
為解決邊緣部署中的記憶體限制,MiniCPM-V4.6 針對推論速度與資源效率進行了深度優化。
低記憶體佔用:記憶體需求降至僅6GB,可在主流智慧型手機、個人電腦及智慧家庭裝置上流暢運作。
推論效率:憑藉 vLLM 技術驅動,推論吞吐量達競爭對手的 1.5 倍。在邊緣端處理 3136² 超高解析度影像時,首次回應延遲僅75.7 毫秒——比競爭模型快 2.2 倍。
吞吐量:單顆 GPU 可實現每秒 7,013 個標記的文字生成速度,並能以每秒 54.79 張的速率處理 1,344² 張影像,展現出卓越的效率。
3. 核心技術:LLaVA-UHD v4 將開銷降至最低
該模型的輕量級設計得益於由明視智能與清華大學共同開發的LLaVA-UHD v4。
編碼重新設計:透過重新設計的 ViT 影像編碼與淺層壓縮模組,將影像編碼開銷削減50%,並將高解析度浮點運算開銷降低55.8%。
混合壓縮:導入 4×/16× 混合標記壓縮技術,可在「效能優先」與「速度優先」模式之間靈活切換。此技術已於快手推薦模型 OneRec 中通過驗證,並能處理龐大流量。
4. 生態系部署:從實驗室到產業
MiniCPM-V4.6 的開源發布標誌著技術與生態系統的雙重里程碑。
簡易開發:它能與 ms-swift 和 LLaMA-Factory 等微調框架無縫整合,支援在單張 RTX 4090 GPU 上進行全面微調。
跨平台支援:相容於 vLLM、Ollama 及其他主要框架,並提供 iOS、Android 及 HarmonyOS 的測試版本,將 AI 帶入更廣泛的硬體領域。
實際應用影響:該模型系列已部署於汽車、個人電腦、智慧家庭及工業檢測等領域,合作夥伴包括聯想、吉利、上汽大眾、小米及 OPPO。








 Adobe 創作者報告:80% 受訪者表示 AI 推動了粉絲數與業務的成長
隨著人工智慧加速全球擴張,內容創作領域正經歷根本性的轉變。創意人工智慧工具不再僅僅是工作流程的輔助工具;它們正推動業務成長,並協助創作者拓展更廣大的受眾群體。提升生產力與競爭優勢Adobe 近期發布的《2026 年創作者工具包報告》針對全球 16,000 名創作者進行了調查,結果顯示 75% 的受訪者現已將創意 AI 作為其工作流程的核心組成部分。AI 的整合大幅縮短了製作時間,直接提升了商業成功
 谷歌宣佈自己成為人工智慧設計領域的重要參與者
在週二的年度 I/O 大會上,Google 釋出了 Pics,這是一款面向 Google Workspace 的全新 AI 驅動設計與影象建立工具。該公司表示,該應用旨在提升可訪問性,服務於從教育工作者到小企業主等各類使用者。Pics 允許使用者使用簡單的文字提示建立社交媒體圖形、邀請函、營銷素材和樣機,無需具備高階編輯技能或專業軟體。透過簡化視覺創作,Google 旨在與 Canva 等成熟設計平臺以及 Anthropic 的 Claude Design 等原生 AI 產品展開競爭。此舉凸顯了
 EverMind 向 ReUnite 投資 300 萬美元,利用 AI 長期記憶助力全球家庭團聚
EverMind,山東集團旗下的子公司,正式推出了“ReUnite”,這是一款由人工智慧驅動的公益工具,旨在透過先進的長期記憶技術,幫助全球分離的家庭團聚。該專案由一位化工行業的人工智慧工程師開發,源自EverMind開源社羣於2026年舉辦的“記憶創世大賽”。透過利用大模型在長期記憶和邏輯推理方面的能力,ReUnite對碎片化的身體特徵、童年記憶和日常習慣進行深度模糊匹配,有效跨越時間和空間的障礙,提高丟失線索的匹配成功率。憑藉技術創新和社會影響力,ReUnite榮獲大賽公益獎,並被選為E

2026 年最新最佳角色扮演與對話練習 AI 聊天應用!XIX.AI 精心策劃了一份頂級評分列表,收錄了經過嚴格現實世界測試、能帶來卓越結果的重磅必備工具。您將找到詳細的免費與付費對比、全面排名,以及這些應用如何有效提升您的語言技能和溝通自信的見解。立即探索,發現最適合您的練習工具!
10 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 線框圖工具,專為產品團隊打造!這份精心篩選的清單展示了多款強大且具顛覆性的解決方案,這些工具已通過實際測試與嚴格評比,能顯著提升工作效率。清單中包含詳盡的免費版與付費版比較,協助您找到最適合的工具。XIX.AI 提供專家見解,引導您做出決策。 立即探索,發掘最適合您的工具,並在產品開發中釋放您的 AI 優勢!
8 個工具
xix.ai
我們在此精心整理的清單中,收錄了 2026 年最新、最佳且評價最高的 AI DevOps 部署監控工具。這些強大的工具經過實際測試與嚴格評比,能協助團隊顯著提升生產力。透過免費版與付費版的比較,找出最符合您需求的理想方案。立即探索,釋放您的 AI 優勢!
11 個工具
xix.ai
2026 年最新、最佳、頂級評價的 AI 資料分析工具,適用於 Excel 和 SQL,現已在 XIX.AI 上線!我們精心策劃的列表包含強大且能改變遊戲規則的工具,幫助您加快資料處理速度、提高生產力並克服分析挑戰。我們進行了真實場景測試,根據效能、易用性和價值提供準確的排名。立即探索,找到最適合您的必試工具,釋放您在資料工作中的 AI 優勢。
10 個工具
xix.ai
2026 年最新、最受好評的 AI 播客聲音複製工具精選集,適用於長篇集數、主持人廣告及音頻課程,均於此處精心彙整。這些強大且顛覆業界的解決方案皆經過實務測試,以確保其可靠性。 您可在此查閱免費版與付費版的比較分析,以及詳細的排名列表。XIX.AI 提供一系列絕對值得一試的精選工具,能顯著提升工作效率。立即探索,找出最適合您的工具,並釋放您的 AI 競爭優勢。
9 個工具
xix.ai
2026 年最新最佳 AI 視覺風格參考工具,適用於角色設定表、 moodboard 及提案簡報,現已登陸 XIX.AI!這份精心精選的高評分清單收錄了經過嚴格實測、能徹底改變遊戲規則的強大工具。 您將在此找到免費與付費版本的對比、詳細排名,以及必試選項,助您激發創意並優化工作流程。立即探索,發掘能提升生產力的完美工具!
11 個工具
xix.ai












