


 家
Meituanが「LongCat-Video-Avatar1.5」をオープンソース化、主流のクローズドモデルを上回る性能を発揮
美団(Meituan)のLongCat大規模モデルチームは、商用グレードのデジタルヒューマン動画生成モデル「LongCat-Video-Avatar 1.5」を正式にオープンソース化しました。このバージョンは、オープンソースの最先端技術から実世界の商用展開へと完全に移行したものであり、リップシンク、物理的リアリズム、長尺動画の安定性、複数人物間の相互作用、および効率的な推論において大幅な強化が図られています。
商用化の障壁を克服するための3つの主要なアップグレード
デジタルヒューマンが実世界のさまざまなアプリケーションで確実に機能するようにするため、「LongCat-Video-Avatar 1.5」は、従来のデジタルヒューマン動画に見られるジッター、歪み、高遅延といった根深い問題に対し、以下の3つの包括的な改善を通じて取り組んでいます:
商用グレードのオーディオエンコーディングのアップグレード
モデルの音声特徴抽出エンコーダーが、Wav2Vec2からWhisper-largeへとアップグレードされました。 パラメータ数の増加と、より豊富な多言語の事前知識により、微妙な音素のバリエーションや話し方のリズムを捉えることが可能になりました。これにより、長い文章、早口、歌唱などの複雑な音声におけるリップシンクが改善されるだけでなく、表情、頭部の動き、発話間の自然な連携も実現され、長時間の動画におけるフレームスキップやアイデンティティドリフトが大幅に低減されます。
多段階データ拡張による堅牢なオープンドメイン汎化
実在の人物、バーチャルアイドル、アニメキャラクター、動物など、多様な被写体において安定した性能を確保するため、チームはオフラインアノテーションとオンライン検証を組み込んだ多段階データパイプラインを開発し、以下の3種類のターゲットを絞った拡張データを導入しました:
複数人物データ:アクティブスピーカー検出を用いて、複数人物が登場するシーンにおける音声と映像の不一致を解消し、話者と聴き手を正確に区別します。
静寂データ:音声が含まれない動画を厳選することで、モデルは沈黙状態における自然な微細な表情を学習し、発話していないキャラクターの不要な口の動きを防止します。
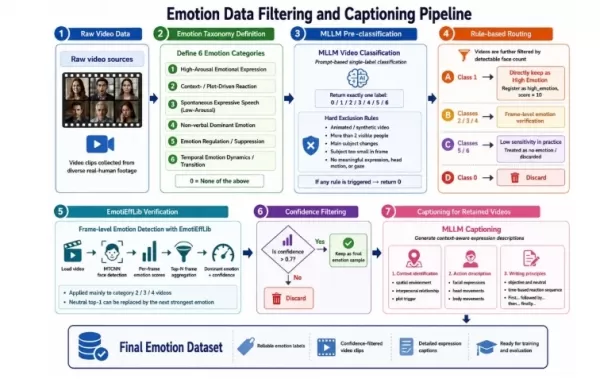
感情データ:フレーム単位の感情認識フィルタリングと組み合わせることで、感情の変動を取り込み、モデルが発話と表情の深い関連性を把握できるよう支援します。
GRPOによる手の位置合わせと時間的連続性
ECライブ配信や製品デモなど、手が頻繁に映るユースケース向けに、本モデルはGRPO(Human Preference Alignment)を導入しています。これにより、報酬信号をフレーム単位で微調整し、初フレームでの手検出メカニズムを追加します。これにより、手の歪み、局所的な構造の崩壊、動作の不整合といった一般的な問題が大幅に軽減されます。
推論速度が15倍向上:計算リソースの負荷を解消
コストも商用展開における重要な要素です。LongCat-Video-Avatar 1.5はDMD(Distributed Matching Distillation)技術を採用し、元の50ステップの生成プロセスをわずか8ステップに圧縮しています。 さらに、チームは従来の3モデル並列構成を、単一の共有ベースモデルと複数のLoRAアダプターによる構成に置き換え、VRAMの使用量を劇的に削減しました。
実環境でのテストでは、このモデルは約15倍高速な推論を実現し、10秒間の動画を約1分で生成しました。
ベンチマーク評価:業界トップクラスのモデルを上回る性能
EvalTalkerベンチマークを用いて、770名の評価者と10名の分野専門家が、ニュース、教育、エンターテインメントなどの複雑な分野の動画に対して体系的な品質分析を行いました。その結果、LongCat-Video-Avatar 1.5はいくつかの主要な指標において優れた性能を発揮していることが示されました:
ユーザーの選好率:Kling Avatar2.0を65.9%、OmniHuman-1.5を61.1%、HeyGenを54.3%上回っています。
単一人物および複数人物シナリオのスコア:単一人物のスコアは3.336に達し、HeyGenなどの競合他社を大幅に上回っています。複数人物のスコアは2.730で、InfiniteTalk(2.339)を大幅に上回っています。
映像の安定性:被写体の変形率はわずか23.1%、背景の変形率はわずか9.4%であり、フレームスキップ率は0.8%と低く、比較対象となったすべてのモデルの中で最高水準です。
音声・映像の協調性:顔と体の同期不具合率は5.1%に、リップシンクの不具合率は29.8%に低下し、いずれも従来の商用システムを上回っています。
Meituan LongCat 大型モデルチームは、「LongCat-Video-Avatar 1.5」のオープンソース化は単なるバージョンアップにとどまらず、世界中の開発者やクリエイターコミュニティへの招待であると述べています。 同チームは、このモデルが検証可能かつ改良可能な技術的基盤となり、デジタルヒューマン動画アプリケーションの実用的な限界を押し広げる一助となることを期待している。
オープンソースリンク:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
技術レポート:https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
プロジェクトページ: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope:https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary
関連記事
 Preplyの「ユニコーン」としての地位は、ウクライナの回復力を反映している
語学学習プラットフォーム「Preply」は、1億5000万ドルのシリーズD資金調達ラウンドを経て、企業価値が12億ドルに達し、創業14年となる同社にとって重要な節目を迎えた。これまでの投資家には、ホライゾン・キャピタル、ホクストン・ベンチャーズ、オウル・ベンチャーズ、テックスターズ・ベルリンなどが名を連ねている。2013年に語学学習者と講師をつなぎ始めて以来、Preplyは12ヶ月連続でEBITD
王興興氏:エンボディッドAI、2~3年以内にChatGPTのような画期的な進展が見込まれる
BotSchoolの創業者兼CEOである王興興氏は、2026年世界ロボット会議(WRC2026)のメインフォーラムでの講演の中で、具現化された知能が「ChatGPTモーメント」に匹敵する産業上の転換点に近づいていると強調した。 同氏は、画期的な進展が早ければ2~3年以内に起こる可能性もある一方、普及のペースが緩やかなシナリオでは5~10年かかる可能性もあると予測した。BotSchoolの上海証券取
Microsoft、Claudeのコスト急騰を受け、新しいコーディングモデルで自社AI戦略を再始動
AI支援のコーディングは現代のソフトウェア開発において不可欠なものとなっていますが、Microsoftのようなテック大手でさえ、高額なサードパーティの大規模言語モデル(LLM)のサブスクリプション費用に苦戦しています。外部依存関係と運用オーバーヘッドを削減するため、Microsoftは独自のAIモデルシリーズを準備しており、直接AIコーディング分野を対象としています。高騰するコストがMicrosoftの自社ソリューション推進を促すMicrosoftは最近、Claudeの利用およびレンタルが極
関連特集おすすめ
動画作成
 Reels、Shorts、広告、ソーシャルコマース向けのCapCut AIビデオ編集ツールがリリースされました
2026年最新の最高級CapCut AI動画編集ツールが、Reels、Shorts、広告、ソーシャルコマース向けに登場!こちらの厳選リストには、実際のテストを通じて優れた成果をもたらす、高評価を受けている画期的なツールが掲載されています。無料版と有料版の比較や詳細なランキングも掲載されているため、自分に最適なツールを選びやすくなっています。XIX.AIは、コンテンツ制作におけるAI活用の可能性を最大限に引き出すための専門的なアドバイスも提供しています。今すぐチェックして、理想のツールを見つけ、今日から生産性を向上させましょう!
 14 ツール
 xix.ai
学術研究
最高のAI学習発見ツール:ジャーナル、データセット、トレンドをすばやく見つける
2026年最新版・最高評価のAI学習・発見ツールのリストがXIX.AIにて公開されています!この厳選リストには、ジャーナル、データセット、業界動向への迅速なアクセスを可能にする革新的なリソースが含まれています。無料版と有料版の比較、実際のテスト結果、毎週更新されるランキングも提供しています。必須のオプションは研究効率を向上させ、AIによる優位性を引き出すのに役立ちます。今すぐ探索して、あなたに最適なツールを見つけましょう!
10 ツール
xix.ai
マーケティング
ライフサイクル・マーケティング向けAIメールキャンペーンツール
2026年版 ライフサイクルマーケティングに最適な、高評価のAIメールキャンペーンツール!XIX.AIは、文章作成の効率を高め、ターゲットを的確に絞ったコンテンツの作成を支援し、マーケティングワークフロー全体を効率化する、画期的で強力な「必試」ソリューションを厳選しました。 毎週更新されるランキング、実地テスト、無料版と有料版の比較情報を活用して、ニーズにぴったりのツールを見つけましょう。今すぐチェックして、AIの力を最大限に引き出しましょう!
11 ツール
xix.ai
ファイナンス
AI投資リサーチツールのトップ選定:シグナルとポートフォリオのリスクを比較
2026年最新の、高評価を得た最高のAI投資リサーチツールがXIX.AIに登場!この厳選リストには、ポートフォリオのリスクを評価し、データに基づいたより賢明な意思決定を支援する、極めて正確なシグナルが掲載されています。当社は毎週実地テストを実施してランキングを更新しており、無料版と有料版の比較情報も提供しています。今すぐ、投資分析の効率を高める最適なツールを見つけましょう。 今すぐチェック!
10 ツール
xix.ai
チャットボット
ウェブサイトのサポート向けAIカスタマーチャットボットツール
2026年最新の、ウェブサイトサポート向けAIカスタマーチャットボットツールの中でも最高評価のベストセレクションが、XIX.AIに登場!当サイトが厳選したこのリストには、応答速度の向上、顧客満足度の向上、そして膨大な手作業の削減を実現する、強力で画期的なソリューションが揃っています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較詳細も掲載されています。 今すぐチェックして、オンラインサポートの効率を飛躍的に高める最適なツールを見つけましょう!
10 ツール
xix.ai
ソーシャルメディア
ショップ、ダイレクトメッセージ、コミュニティ運営向けのInstagram AIコメント返信ツール
2026年最新の最強Instagram AIコメント返信ツールが、店舗運営、ダイレクトメッセージ対応、コミュニティ管理に活躍!XIX.AIは、毎週更新されるランキングや無料版と有料版の比較、実際の使用テスト結果を掲載した、高評価を誇る優れたソリューション一覧をまとめています。これらの必見ツールは、返信作業を効率化し、時間を節約し、あらゆるソーシャルメディアプラットフォームにおける顧客エンゲージメントを高めることで、生産性を大幅に向上させてくれます。シームレスなコミュニティ管理のための最適なツールを見つけ出すには、今すぐチェックしてみましょう!
10 ツール
xix.ai

 コメント (0)
0/500
美団(Meituan)のLongCat大規模モデルチームは、商用グレードのデジタルヒューマン動画生成モデル「LongCat-Video-Avatar 1.5」を正式にオープンソース化しました。このバージョンは、オープンソースの最先端技術から実世界の商用展開へと完全に移行したものであり、リップシンク、物理的リアリズム、長尺動画の安定性、複数人物間の相互作用、および効率的な推論において大幅な強化が図られています。
商用化の障壁を克服するための3つの主要なアップグレード
デジタルヒューマンが実世界のさまざまなアプリケーションで確実に機能するようにするため、「LongCat-Video-Avatar 1.5」は、従来のデジタルヒューマン動画に見られるジッター、歪み、高遅延といった根深い問題に対し、以下の3つの包括的な改善を通じて取り組んでいます:
商用グレードのオーディオエンコーディングのアップグレード
モデルの音声特徴抽出エンコーダーが、Wav2Vec2からWhisper-largeへとアップグレードされました。 パラメータ数の増加と、より豊富な多言語の事前知識により、微妙な音素のバリエーションや話し方のリズムを捉えることが可能になりました。これにより、長い文章、早口、歌唱などの複雑な音声におけるリップシンクが改善されるだけでなく、表情、頭部の動き、発話間の自然な連携も実現され、長時間の動画におけるフレームスキップやアイデンティティドリフトが大幅に低減されます。
多段階データ拡張による堅牢なオープンドメイン汎化
実在の人物、バーチャルアイドル、アニメキャラクター、動物など、多様な被写体において安定した性能を確保するため、チームはオフラインアノテーションとオンライン検証を組み込んだ多段階データパイプラインを開発し、以下の3種類のターゲットを絞った拡張データを導入しました:
複数人物データ:アクティブスピーカー検出を用いて、複数人物が登場するシーンにおける音声と映像の不一致を解消し、話者と聴き手を正確に区別します。
静寂データ:音声が含まれない動画を厳選することで、モデルは沈黙状態における自然な微細な表情を学習し、発話していないキャラクターの不要な口の動きを防止します。
感情データ:フレーム単位の感情認識フィルタリングと組み合わせることで、感情の変動を取り込み、モデルが発話と表情の深い関連性を把握できるよう支援します。
GRPOによる手の位置合わせと時間的連続性
ECライブ配信や製品デモなど、手が頻繁に映るユースケース向けに、本モデルはGRPO(Human Preference Alignment)を導入しています。これにより、報酬信号をフレーム単位で微調整し、初フレームでの手検出メカニズムを追加します。これにより、手の歪み、局所的な構造の崩壊、動作の不整合といった一般的な問題が大幅に軽減されます。
推論速度が15倍向上:計算リソースの負荷を解消
コストも商用展開における重要な要素です。LongCat-Video-Avatar 1.5はDMD(Distributed Matching Distillation)技術を採用し、元の50ステップの生成プロセスをわずか8ステップに圧縮しています。 さらに、チームは従来の3モデル並列構成を、単一の共有ベースモデルと複数のLoRAアダプターによる構成に置き換え、VRAMの使用量を劇的に削減しました。
実環境でのテストでは、このモデルは約15倍高速な推論を実現し、10秒間の動画を約1分で生成しました。
ベンチマーク評価:業界トップクラスのモデルを上回る性能
EvalTalkerベンチマークを用いて、770名の評価者と10名の分野専門家が、ニュース、教育、エンターテインメントなどの複雑な分野の動画に対して体系的な品質分析を行いました。その結果、LongCat-Video-Avatar 1.5はいくつかの主要な指標において優れた性能を発揮していることが示されました:
ユーザーの選好率:Kling Avatar2.0を65.9%、OmniHuman-1.5を61.1%、HeyGenを54.3%上回っています。
単一人物および複数人物シナリオのスコア:単一人物のスコアは3.336に達し、HeyGenなどの競合他社を大幅に上回っています。複数人物のスコアは2.730で、InfiniteTalk(2.339)を大幅に上回っています。
映像の安定性:被写体の変形率はわずか23.1%、背景の変形率はわずか9.4%であり、フレームスキップ率は0.8%と低く、比較対象となったすべてのモデルの中で最高水準です。
音声・映像の協調性:顔と体の同期不具合率は5.1%に、リップシンクの不具合率は29.8%に低下し、いずれも従来の商用システムを上回っています。
Meituan LongCat 大型モデルチームは、「LongCat-Video-Avatar 1.5」のオープンソース化は単なるバージョンアップにとどまらず、世界中の開発者やクリエイターコミュニティへの招待であると述べています。 同チームは、このモデルが検証可能かつ改良可能な技術的基盤となり、デジタルヒューマン動画アプリケーションの実用的な限界を押し広げる一助となることを期待している。
オープンソースリンク:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
技術レポート:https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
プロジェクトページ: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope:https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary








 Preplyの「ユニコーン」としての地位は、ウクライナの回復力を反映している
語学学習プラットフォーム「Preply」は、1億5000万ドルのシリーズD資金調達ラウンドを経て、企業価値が12億ドルに達し、創業14年となる同社にとって重要な節目を迎えた。これまでの投資家には、ホライゾン・キャピタル、ホクストン・ベンチャーズ、オウル・ベンチャーズ、テックスターズ・ベルリンなどが名を連ねている。2013年に語学学習者と講師をつなぎ始めて以来、Preplyは12ヶ月連続でEBITD
 王興興氏:エンボディッドAI、2~3年以内にChatGPTのような画期的な進展が見込まれる
BotSchoolの創業者兼CEOである王興興氏は、2026年世界ロボット会議(WRC2026)のメインフォーラムでの講演の中で、具現化された知能が「ChatGPTモーメント」に匹敵する産業上の転換点に近づいていると強調した。 同氏は、画期的な進展が早ければ2~3年以内に起こる可能性もある一方、普及のペースが緩やかなシナリオでは5~10年かかる可能性もあると予測した。BotSchoolの上海証券取
 Microsoft、Claudeのコスト急騰を受け、新しいコーディングモデルで自社AI戦略を再始動
AI支援のコーディングは現代のソフトウェア開発において不可欠なものとなっていますが、Microsoftのようなテック大手でさえ、高額なサードパーティの大規模言語モデル(LLM)のサブスクリプション費用に苦戦しています。外部依存関係と運用オーバーヘッドを削減するため、Microsoftは独自のAIモデルシリーズを準備しており、直接AIコーディング分野を対象としています。高騰するコストがMicrosoftの自社ソリューション推進を促すMicrosoftは最近、Claudeの利用およびレンタルが極
2026年最新の最高級CapCut AI動画編集ツールが、Reels、Shorts、広告、ソーシャルコマース向けに登場!こちらの厳選リストには、実際のテストを通じて優れた成果をもたらす、高評価を受けている画期的なツールが掲載されています。無料版と有料版の比較や詳細なランキングも掲載されているため、自分に最適なツールを選びやすくなっています。XIX.AIは、コンテンツ制作におけるAI活用の可能性を最大限に引き出すための専門的なアドバイスも提供しています。今すぐチェックして、理想のツールを見つけ、今日から生産性を向上させましょう!
14 ツール
xix.ai
2026年最新版・最高評価のAI学習・発見ツールのリストがXIX.AIにて公開されています!この厳選リストには、ジャーナル、データセット、業界動向への迅速なアクセスを可能にする革新的なリソースが含まれています。無料版と有料版の比較、実際のテスト結果、毎週更新されるランキングも提供しています。必須のオプションは研究効率を向上させ、AIによる優位性を引き出すのに役立ちます。今すぐ探索して、あなたに最適なツールを見つけましょう!
10 ツール
xix.ai
2026年版 ライフサイクルマーケティングに最適な、高評価のAIメールキャンペーンツール!XIX.AIは、文章作成の効率を高め、ターゲットを的確に絞ったコンテンツの作成を支援し、マーケティングワークフロー全体を効率化する、画期的で強力な「必試」ソリューションを厳選しました。 毎週更新されるランキング、実地テスト、無料版と有料版の比較情報を活用して、ニーズにぴったりのツールを見つけましょう。今すぐチェックして、AIの力を最大限に引き出しましょう!
11 ツール
xix.ai
2026年最新の、高評価を得た最高のAI投資リサーチツールがXIX.AIに登場!この厳選リストには、ポートフォリオのリスクを評価し、データに基づいたより賢明な意思決定を支援する、極めて正確なシグナルが掲載されています。当社は毎週実地テストを実施してランキングを更新しており、無料版と有料版の比較情報も提供しています。今すぐ、投資分析の効率を高める最適なツールを見つけましょう。 今すぐチェック!
10 ツール
xix.ai
2026年最新の、ウェブサイトサポート向けAIカスタマーチャットボットツールの中でも最高評価のベストセレクションが、XIX.AIに登場!当サイトが厳選したこのリストには、応答速度の向上、顧客満足度の向上、そして膨大な手作業の削減を実現する、強力で画期的なソリューションが揃っています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較詳細も掲載されています。 今すぐチェックして、オンラインサポートの効率を飛躍的に高める最適なツールを見つけましょう!
10 ツール
xix.ai
2026年最新の最強Instagram AIコメント返信ツールが、店舗運営、ダイレクトメッセージ対応、コミュニティ管理に活躍!XIX.AIは、毎週更新されるランキングや無料版と有料版の比較、実際の使用テスト結果を掲載した、高評価を誇る優れたソリューション一覧をまとめています。これらの必見ツールは、返信作業を効率化し、時間を節約し、あらゆるソーシャルメディアプラットフォームにおける顧客エンゲージメントを高めることで、生産性を大幅に向上させてくれます。シームレスなコミュニティ管理のための最適なツールを見つけ出すには、今すぐチェックしてみましょう!
10 ツール
xix.ai












