


 Heim
Meituan veröffentlicht „LongCat-Video-Avatar 1.5“ als Open-Source-Software – das Modell übertrifft gängige proprietäre Modelle
Das LongCat-Team für große Modelle bei Meituan hat „LongCat-Video-Avatar 1.5“, ein Modell zur Erzeugung digitaler Menschen in Videos auf kommerziellem Niveau, offiziell als Open Source veröffentlicht. Diese Version markiert einen vollständigen Übergang vom Open-Source-Stand der Technik zum praktischen kommerziellen Einsatz und bietet wesentliche Verbesserungen in den Bereichen Lippensynchronisation, physikalischer Realismus, Stabilität bei langen Videos, Interaktionen zwischen mehreren Personen sowie effiziente Inferenz.
Drei wichtige Verbesserungen zur Überwindung von Hürden bei der Kommerzialisierung
Damit digitale Menschen in verschiedenen realen Anwendungen zuverlässig funktionieren, geht LongCat-Video-Avatar 1.5 durch drei ganzheitliche Verbesserungen hartnäckige Probleme wie Bildflackern, Verzerrungen und hohe Latenz in herkömmlichen Videos mit digitalen Menschen an:
Verbesserung der Audio-Kodierung auf kommerziellem Niveau
Der Encoder zur Extraktion von Audio-Merkmalen des Modells wurde von Wav2Vec2 auf Whisper-large aktualisiert. Mit mehr Parametern und umfangreicheren mehrsprachigen Vorwissen erfasst er nun subtile Phonemvariationen und den Sprachrhythmus. Dies verbessert die Lippensynchronisation bei komplexen Audioinhalten wie langen Sätzen, schneller Sprache und Gesang und ermöglicht gleichzeitig eine natürliche Koordination zwischen Gesichtsausdrücken, Kopfbewegungen und Sprache – wodurch Frame-Skipping und Identitätsdrift in längeren Videos deutlich reduziert werden.
Robuste Open-Domain-Generalisierung durch mehrstufige Datenanreicherung
Um eine stabile Leistung bei unterschiedlichen Motiven – echte Menschen, virtuelle Idole, Anime-Figuren und Tiere – zu gewährleisten, entwickelte das Team eine mehrstufige Datenpipeline, die Offline-Annotation und Online-Validierung umfasst, und führte drei gezielte Arten von angereicherten Daten ein:
Daten mit mehreren Personen: Mithilfe der Erkennung des aktiven Sprechers werden audiovisuelle Mehrdeutigkeiten in Szenen mit mehreren Personen beseitigt, wobei Sprecher und Zuhörer präzise voneinander unterschieden werden.
Stille Daten: Durch die Auswahl von Videos ohne Sprache lernt das Modell natürliche Mikroausdrücke in stillen Zuständen kennen und verhindert so unerwünschte Mundbewegungen bei nicht sprechenden Figuren.
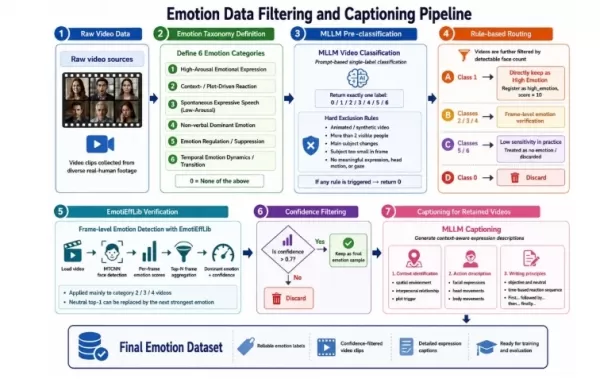
Emotionsdaten: In Kombination mit einem Filter zur Emotionserkennung auf Frame-Ebene werden emotionale Schwankungen einbezogen, was dem Modell hilft, den tiefen Zusammenhang zwischen Sprache und Gesichtsausdrücken zu erfassen.
Handausrichtung und zeitliche Kontinuität mit GRPO
Für Anwendungsfälle wie E-Commerce-Livestreams und Produktdemos, bei denen Hände häufig zu sehen sind, führt das Modell GRPO (Human Preference Alignment) ein, das Belohnungssignale auf Frame-Ebene verfeinert und einen Mechanismus zur Handerkennung im ersten Frame hinzufügt. Dies reduziert häufige Probleme wie Handverzerrungen, lokalen Strukturkollaps und inkonsistente Bewegungen erheblich.
15-mal schnellere Inferenz: Eliminierung hoher Rechenanforderungen
Die Kosten sind ein weiterer entscheidender Faktor für den kommerziellen Einsatz. LongCat-Video-Avatar 1.5 nutzt die DMD-Technologie (Distributed Matching Distillation) und komprimiert den ursprünglichen 50-stufigen Generierungsprozess auf nur 8 Schritte. Darüber hinaus ersetzte das Team die herkömmliche parallele Konfiguration mit drei Modellen durch ein einziges gemeinsames Basismodell sowie mehrere LoRA-Adapter, wodurch der VRAM-Verbrauch drastisch reduziert wurde.
In Praxistests liefert das Modell eine etwa 15-mal schnellere Inferenz und generiert ein 10-Sekunden-Video in etwa einer Minute.
Benchmark-Auswertung: Übertrifft führende Branchenmodelle
Mithilfe des EvalTalker-Benchmarks führten 770 Bewerter und 10 Fachexperten eine strukturierte Qualitätsanalyse von Videos aus komplexen Bereichen wie Nachrichten, Bildung und Unterhaltung durch. Die Ergebnisse zeigen, dass LongCat-Video-Avatar 1.5 bei mehreren Schlüsselkennzahlen herausragende Leistungen erbringt:
Gewinnquote bei den Nutzerpräferenzen: Es übertrifft Kling Avatar 2.0 um 65,9 %, OmniHuman-1.5 um 61,1 % und HeyGen um 54,3 %.
Bewertungen in Ein- und Mehrpersonen-Szenarien: Die Bewertung im Ein-Personen-Szenario erreicht 3,336 und liegt damit deutlich über der von Wettbewerbern wie HeyGen; die Bewertung im Mehrpersonen-Szenario beträgt 2,730 und übertrifft InfiniteTalk (2,339) deutlich.
Videostabilität: Die Verformungsrate der Testperson beträgt nur 23,1 % und die des Hintergrunds lediglich 9,4 %;die Bildausfallrate liegt bei nur 0,8 % und ist damit dieniedrigste aller verglichenen Modelle.
Audiovisuelle Koordination: Die Fehlerquote bei der Gesichts-Körper-Synchronisation sank auf 5,1 %, und die Fehlerquote bei der Lippensynchronisation fiel auf 29,8 % – beide Werte übertreffen herkömmliche kommerzielle Systeme.
Das Team des großen Meituan-LongCat-Modells erklärt, dass die Veröffentlichung von „LongCat-Video-Avatar 1.5“ als Open-Source-Projekt mehr ist als nur ein Versions-Update – es ist eine Einladung an die weltweite Entwickler- und Kreativ-Community. Sie hoffen, dass dieses Modell als überprüfbare, verbesserungsfähige technische Grundlage dienen wird, um die Grenzen digitaler Human-Video-Anwendungen in der Praxis weiter zu verschieben.
Open-Source-Links:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Technischer Bericht: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Projektseite: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary
Verwandter Artikel
 Preplys „Unicorn“-Status spiegelt die Widerstandsfähigkeit der Ukraine wider
Die Sprachlernplattform Preply hat nach einer Serie-D-Finanzierungsrunde in Höhe von 150 Millionen US-Dollar eine Bewertung von 1,2 Milliarden US-Dollar erreicht – ein bedeutender Meilenstein für das
Wang Xingxing: „Embodied AI“ soll in zwei bis drei Jahren einen Durchbruch wie ChatGPT erzielen
Wang Xingxing, Gründer und CEO von BotSchool, betonte in seiner Rede auf dem Hauptforum der World Robot Conference 2026 (WRC2026), dass sich die verkörperte Intelligenz einem industriellen Wendepunkt
Microsoft belebt die eigene KI-Strategie mit neuem Codierungsmodell wieder, während die Kosten für Claude stark ansteigen
Die KI-gestützte Programmierung ist zu einem festen Bestandteil der modernen Softwareentwicklung geworden, doch selbst Tech-Giganten wie Microsoft spüren die Last teurer Abos für Drittanbieter-Modelle großer Sprachmodelle. Um externe Abhängigkeiten u
Empfehlungen zu verwandten Spezialthemen
Videoerstellung
 CapCut AI-Videobearbeitungstools für Reels, Shorts, Werbung sowie Social Commerce werden jetzt verfügbar
2026 – Die neuesten und besten CapCut AI-Videobearbeitungstools für Reels, Shorts, Werbung sowie Social Commerce! Diese sorgfältig zusammengestellte Liste präsentiert hochbewertete, leistungsstarke Tools, die durch praktische Tests beeindruckende Ergebnisse liefern. Sie finden hier einen Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie detaillierte Ranglisten, die Ihnen bei der Auswahl des perfekten Tools helfen. XIX.AI bietet fachkundige Erkenntnisse, damit Sie Ihren Vorteil durch KI in der Inhaltscreation ausschöpfen können. Entdecken Sie jetzt Ihr ideales Tool und steigern Sie noch heute Ihre Produktivität!
 14 Tools
 xix.ai
Akademische Forschung
Die besten KI-gestützten Tools zur Entdeckung von Studien: Finden Sie Zeitschriften, Datensätze und Trends schnell
2026 Neueste Besten Top-bewerteten KI-Studien-Entdeckungstools sind hier auf XIX.AI! Diese kuratierte Liste umfasst leistungsstarke, bahnbrechende Ressourcen für den schnellen Zugriff auf Fachzeitschriften, Datensätze und Branchentrends. Erhalten Sie einen kostenlosen versus kostenpflichtigen Vergleich sowie reale Tests und wöchentlich aktualisierte Rankings. Unverzichtbare Optionen helfen, Ihre Forschungseffizienz zu steigern und Ihren KI-Vorteil freizuschalten. Entdecken Sie jetzt Ihr perfektes Tool!
10 Tools
xix.ai
Marketing
KI-Tools für E-Mail-Kampagnen im Lebenszyklus-Marketing
Die besten und am besten bewerteten KI-Tools für E-Mail-Kampagnen im Lifecycle-Marketing 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Lösungen zusammengestellt, die Sie unbedingt ausprobieren sollten: Sie steigern die Effizienz beim Verfassen von Texten, helfen bei der Erstellung zielgerichteter Inhalte und optimieren gesamte Marketing-Workflows. Profitieren Sie von wöchentlich aktualisierten Rankings, Praxistests und einem Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um das perfekte Tool für Ihre Anforderungen zu finden. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai
Finanzen
Die besten Tools für die KI-Investmentanalyse: Signale und Portfoliorisiken vergleichen
Die aktuellsten und am besten bewerteten KI-Tools für die Anlageanalyse des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält äußerst präzise Signale zur Bewertung von Portfoliorisiken und hilft Ihnen dabei, klügere, datengestützte Entscheidungen zu treffen. Wir führen wöchentlich Praxistests durch, um die Rangliste zu aktualisieren, und bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie noch heute das perfekte Tool, um die Effizienz Ihrer Anlageanalysen zu steigern. Jetzt entdecken!
10 Tools
xix.ai
Chatbot
KI-basierte Chatbot-Tools für den Kundensupport auf Websites
Die besten und am besten bewerteten KI-Chatbot-Tools für den Website-Support im Jahr 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Reaktionszeiten verkürzen, die Kundenzufriedenheit steigern und jede Menge manuelle Arbeit einsparen. Jede Option wird strengen Praxistests unterzogen, ergänzt durch einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie jetzt das perfekte Tool, um die Effizienz Ihres Online-Supports zu steigern!
10 Tools
xix.ai
Soziale Medien
Instagram-Tools mit KI zur Beantwortung von Kommentaren für Shops, Direktnachrichten und Community-Management
Die besten Instagram-Tools für KI-Kommentarantworten 2026 für Shops, Direktnachrichten und Community-Management! XIX.AI hat eine Liste der besten und leistungsstärksten Lösungen zusammengestellt, die bahnbrechende Neuerungen bieten – mit wöchentlich aktualisierten Rankings, einem Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Tests unter realen Bedingungen. Diese Tools, die Sie unbedingt ausprobieren sollten, tragen dazu bei, die Produktivität erheblich zu steigern, indem sie die Beantwortung von Nachrichten optimieren, Zeit sparen und die Kundenbindung auf allen Social-Media-Plattformen verbessern. Entdecken Sie jetzt das perfekte Tool für ein reibungsloses Community-Management!
10 Tools
xix.ai

 Kommentare (0)
Das LongCat-Team für große Modelle bei Meituan hat „LongCat-Video-Avatar 1.5“, ein Modell zur Erzeugung digitaler Menschen in Videos auf kommerziellem Niveau, offiziell als Open Source veröffentlicht. Diese Version markiert einen vollständigen Übergang vom Open-Source-Stand der Technik zum praktischen kommerziellen Einsatz und bietet wesentliche Verbesserungen in den Bereichen Lippensynchronisation, physikalischer Realismus, Stabilität bei langen Videos, Interaktionen zwischen mehreren Personen sowie effiziente Inferenz.
Drei wichtige Verbesserungen zur Überwindung von Hürden bei der Kommerzialisierung
Damit digitale Menschen in verschiedenen realen Anwendungen zuverlässig funktionieren, geht LongCat-Video-Avatar 1.5 durch drei ganzheitliche Verbesserungen hartnäckige Probleme wie Bildflackern, Verzerrungen und hohe Latenz in herkömmlichen Videos mit digitalen Menschen an:
Verbesserung der Audio-Kodierung auf kommerziellem Niveau
Der Encoder zur Extraktion von Audio-Merkmalen des Modells wurde von Wav2Vec2 auf Whisper-large aktualisiert. Mit mehr Parametern und umfangreicheren mehrsprachigen Vorwissen erfasst er nun subtile Phonemvariationen und den Sprachrhythmus. Dies verbessert die Lippensynchronisation bei komplexen Audioinhalten wie langen Sätzen, schneller Sprache und Gesang und ermöglicht gleichzeitig eine natürliche Koordination zwischen Gesichtsausdrücken, Kopfbewegungen und Sprache – wodurch Frame-Skipping und Identitätsdrift in längeren Videos deutlich reduziert werden.
Robuste Open-Domain-Generalisierung durch mehrstufige Datenanreicherung
Um eine stabile Leistung bei unterschiedlichen Motiven – echte Menschen, virtuelle Idole, Anime-Figuren und Tiere – zu gewährleisten, entwickelte das Team eine mehrstufige Datenpipeline, die Offline-Annotation und Online-Validierung umfasst, und führte drei gezielte Arten von angereicherten Daten ein:
Daten mit mehreren Personen: Mithilfe der Erkennung des aktiven Sprechers werden audiovisuelle Mehrdeutigkeiten in Szenen mit mehreren Personen beseitigt, wobei Sprecher und Zuhörer präzise voneinander unterschieden werden.
Stille Daten: Durch die Auswahl von Videos ohne Sprache lernt das Modell natürliche Mikroausdrücke in stillen Zuständen kennen und verhindert so unerwünschte Mundbewegungen bei nicht sprechenden Figuren.
Emotionsdaten: In Kombination mit einem Filter zur Emotionserkennung auf Frame-Ebene werden emotionale Schwankungen einbezogen, was dem Modell hilft, den tiefen Zusammenhang zwischen Sprache und Gesichtsausdrücken zu erfassen.
Handausrichtung und zeitliche Kontinuität mit GRPO
Für Anwendungsfälle wie E-Commerce-Livestreams und Produktdemos, bei denen Hände häufig zu sehen sind, führt das Modell GRPO (Human Preference Alignment) ein, das Belohnungssignale auf Frame-Ebene verfeinert und einen Mechanismus zur Handerkennung im ersten Frame hinzufügt. Dies reduziert häufige Probleme wie Handverzerrungen, lokalen Strukturkollaps und inkonsistente Bewegungen erheblich.
15-mal schnellere Inferenz: Eliminierung hoher Rechenanforderungen
Die Kosten sind ein weiterer entscheidender Faktor für den kommerziellen Einsatz. LongCat-Video-Avatar 1.5 nutzt die DMD-Technologie (Distributed Matching Distillation) und komprimiert den ursprünglichen 50-stufigen Generierungsprozess auf nur 8 Schritte. Darüber hinaus ersetzte das Team die herkömmliche parallele Konfiguration mit drei Modellen durch ein einziges gemeinsames Basismodell sowie mehrere LoRA-Adapter, wodurch der VRAM-Verbrauch drastisch reduziert wurde.
In Praxistests liefert das Modell eine etwa 15-mal schnellere Inferenz und generiert ein 10-Sekunden-Video in etwa einer Minute.
Benchmark-Auswertung: Übertrifft führende Branchenmodelle
Mithilfe des EvalTalker-Benchmarks führten 770 Bewerter und 10 Fachexperten eine strukturierte Qualitätsanalyse von Videos aus komplexen Bereichen wie Nachrichten, Bildung und Unterhaltung durch. Die Ergebnisse zeigen, dass LongCat-Video-Avatar 1.5 bei mehreren Schlüsselkennzahlen herausragende Leistungen erbringt:
Gewinnquote bei den Nutzerpräferenzen: Es übertrifft Kling Avatar 2.0 um 65,9 %, OmniHuman-1.5 um 61,1 % und HeyGen um 54,3 %.
Bewertungen in Ein- und Mehrpersonen-Szenarien: Die Bewertung im Ein-Personen-Szenario erreicht 3,336 und liegt damit deutlich über der von Wettbewerbern wie HeyGen; die Bewertung im Mehrpersonen-Szenario beträgt 2,730 und übertrifft InfiniteTalk (2,339) deutlich.
Videostabilität: Die Verformungsrate der Testperson beträgt nur 23,1 % und die des Hintergrunds lediglich 9,4 %;die Bildausfallrate liegt bei nur 0,8 % und ist damit dieniedrigste aller verglichenen Modelle.
Audiovisuelle Koordination: Die Fehlerquote bei der Gesichts-Körper-Synchronisation sank auf 5,1 %, und die Fehlerquote bei der Lippensynchronisation fiel auf 29,8 % – beide Werte übertreffen herkömmliche kommerzielle Systeme.
Das Team des großen Meituan-LongCat-Modells erklärt, dass die Veröffentlichung von „LongCat-Video-Avatar 1.5“ als Open-Source-Projekt mehr ist als nur ein Versions-Update – es ist eine Einladung an die weltweite Entwickler- und Kreativ-Community. Sie hoffen, dass dieses Modell als überprüfbare, verbesserungsfähige technische Grundlage dienen wird, um die Grenzen digitaler Human-Video-Anwendungen in der Praxis weiter zu verschieben.
Open-Source-Links:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Technischer Bericht: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Projektseite: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary








 Preplys „Unicorn“-Status spiegelt die Widerstandsfähigkeit der Ukraine wider
Die Sprachlernplattform Preply hat nach einer Serie-D-Finanzierungsrunde in Höhe von 150 Millionen US-Dollar eine Bewertung von 1,2 Milliarden US-Dollar erreicht – ein bedeutender Meilenstein für das
 Wang Xingxing: „Embodied AI“ soll in zwei bis drei Jahren einen Durchbruch wie ChatGPT erzielen
Wang Xingxing, Gründer und CEO von BotSchool, betonte in seiner Rede auf dem Hauptforum der World Robot Conference 2026 (WRC2026), dass sich die verkörperte Intelligenz einem industriellen Wendepunkt
 Microsoft belebt die eigene KI-Strategie mit neuem Codierungsmodell wieder, während die Kosten für Claude stark ansteigen
Die KI-gestützte Programmierung ist zu einem festen Bestandteil der modernen Softwareentwicklung geworden, doch selbst Tech-Giganten wie Microsoft spüren die Last teurer Abos für Drittanbieter-Modelle großer Sprachmodelle. Um externe Abhängigkeiten u
2026 – Die neuesten und besten CapCut AI-Videobearbeitungstools für Reels, Shorts, Werbung sowie Social Commerce! Diese sorgfältig zusammengestellte Liste präsentiert hochbewertete, leistungsstarke Tools, die durch praktische Tests beeindruckende Ergebnisse liefern. Sie finden hier einen Vergleich zwischen kostenlosen und kostenpflichtigen Versionen sowie detaillierte Ranglisten, die Ihnen bei der Auswahl des perfekten Tools helfen. XIX.AI bietet fachkundige Erkenntnisse, damit Sie Ihren Vorteil durch KI in der Inhaltscreation ausschöpfen können. Entdecken Sie jetzt Ihr ideales Tool und steigern Sie noch heute Ihre Produktivität!
14 Tools
xix.ai
2026 Neueste Besten Top-bewerteten KI-Studien-Entdeckungstools sind hier auf XIX.AI! Diese kuratierte Liste umfasst leistungsstarke, bahnbrechende Ressourcen für den schnellen Zugriff auf Fachzeitschriften, Datensätze und Branchentrends. Erhalten Sie einen kostenlosen versus kostenpflichtigen Vergleich sowie reale Tests und wöchentlich aktualisierte Rankings. Unverzichtbare Optionen helfen, Ihre Forschungseffizienz zu steigern und Ihren KI-Vorteil freizuschalten. Entdecken Sie jetzt Ihr perfektes Tool!
10 Tools
xix.ai
Die besten und am besten bewerteten KI-Tools für E-Mail-Kampagnen im Lifecycle-Marketing 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Auswahl an Lösungen zusammengestellt, die Sie unbedingt ausprobieren sollten: Sie steigern die Effizienz beim Verfassen von Texten, helfen bei der Erstellung zielgerichteter Inhalte und optimieren gesamte Marketing-Workflows. Profitieren Sie von wöchentlich aktualisierten Rankings, Praxistests und einem Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, um das perfekte Tool für Ihre Anforderungen zu finden. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil!
11 Tools
xix.ai
Die aktuellsten und am besten bewerteten KI-Tools für die Anlageanalyse des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält äußerst präzise Signale zur Bewertung von Portfoliorisiken und hilft Ihnen dabei, klügere, datengestützte Entscheidungen zu treffen. Wir führen wöchentlich Praxistests durch, um die Rangliste zu aktualisieren, und bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie noch heute das perfekte Tool, um die Effizienz Ihrer Anlageanalysen zu steigern. Jetzt entdecken!
10 Tools
xix.ai
Die besten und am besten bewerteten KI-Chatbot-Tools für den Website-Support im Jahr 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die die Reaktionszeiten verkürzen, die Kundenzufriedenheit steigern und jede Menge manuelle Arbeit einsparen. Jede Option wird strengen Praxistests unterzogen, ergänzt durch einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Entdecken Sie jetzt das perfekte Tool, um die Effizienz Ihres Online-Supports zu steigern!
10 Tools
xix.ai
Die besten Instagram-Tools für KI-Kommentarantworten 2026 für Shops, Direktnachrichten und Community-Management! XIX.AI hat eine Liste der besten und leistungsstärksten Lösungen zusammengestellt, die bahnbrechende Neuerungen bieten – mit wöchentlich aktualisierten Rankings, einem Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Tests unter realen Bedingungen. Diese Tools, die Sie unbedingt ausprobieren sollten, tragen dazu bei, die Produktivität erheblich zu steigern, indem sie die Beantwortung von Nachrichten optimieren, Zeit sparen und die Kundenbindung auf allen Social-Media-Plattformen verbessern. Entdecken Sie jetzt das perfekte Tool für ein reibungsloses Community-Management!
10 Tools
xix.ai












