


 Hogar
Meituan publica en código abierto LongCat-Video-Avatar 1.5, que supera a los modelos cerrados más habituales
El equipo de modelos a gran escala LongCat de Meituan ha publicado oficialmente en código abierto LongCat-Video-Avatar 1.5, un modelo de generación de vídeo de personas digitales de calidad comercial. Esta versión supone un cambio total, pasando de la tecnología de vanguardia de código abierto a la implementación comercial en el mundo real, con importantes mejoras en la sincronización labial, el realismo físico, la estabilidad en vídeos largos, las interacciones entre varias personas y la eficiencia en la inferencia.
Tres mejoras clave para superar los obstáculos de la comercialización
Para que los humanos digitales funcionen de forma fiable en diversas aplicaciones del mundo real, LongCat-Video-Avatar 1.5 aborda problemas persistentes como el jitter, la distorsión y la alta latencia en los vídeos tradicionales de humanos digitales mediante tres mejoras integrales:
Mejora de la codificación de audio de calidad comercial
El codificador de extracción de características de audio del modelo se ha actualizado de Wav2Vec2 a Whisper-large. Con más parámetros y un conocimiento previo multilingüe más rico, ahora capta variaciones sutiles de fonemas y el ritmo del habla. Esto mejora la sincronización labial en audios complejos, como frases largas, habla rápida y canto, al tiempo que permite una coordinación natural entre las expresiones faciales, los movimientos de la cabeza y el habla, lo que reduce significativamente el salto de fotogramas y la deriva de identidad en vídeos más largos.
Generalización robusta en dominio abierto mediante la mejora de datos en varias etapas
Para garantizar un rendimiento estable con sujetos diversos —personas reales, ídolos virtuales, personajes de anime y animales—, el equipo desarrolló un flujo de datos en varias etapas que incorpora anotación fuera de línea y validación en línea, e introdujo tres tipos específicos de datos mejorados:
Datos de múltiples personas: mediante la detección activa del hablante, elimina la ambigüedad audiovisual en escenas con varias personas, diferenciando con precisión a los hablantes de los oyentes.
Datos silenciosos: al seleccionar vídeos sin habla, el modelo aprende microexpresiones naturales durante los estados de silencio, lo que evita movimientos bucales no deseados en los personajes que no hablan.
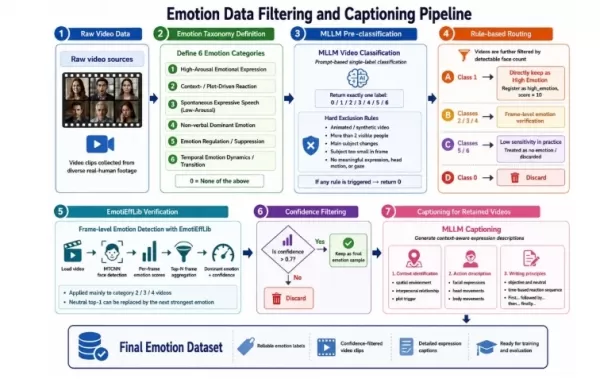
Datos emocionales: en combinación con un filtrado de reconocimiento emocional a nivel de fotograma, incorpora variaciones emocionales, lo que ayuda al modelo a comprender el profundo vínculo entre el habla y las expresiones faciales.
Alineación de manos y continuidad temporal con GRPO
Para casos de uso como las retransmisiones en directo de comercio electrónico y las demostraciones de productos, en las que las manos suelen estar visibles, el modelo introduce GRPO (Human Preference Alignment), que refina las señales de recompensa a nivel de fotograma y añade un mecanismo de detección de manos en el primer fotograma. Esto reduce sustancialmente problemas comunes como la distorsión de las manos, el colapso estructural local y el movimiento inconsistente.
Inferencia 15 veces más rápida: eliminación de los costosos requisitos de computación
El coste es otro factor crítico para el despliegue comercial. LongCat-Video-Avatar 1.5 utiliza la tecnología DMD (Distributed Matching Distillation), que comprime el proceso de generación original de 50 pasos a solo 8. Además, el equipo sustituyó la configuración paralela convencional de tres modelos por un único modelo base compartido más varios adaptadores LoRA, lo que redujo drásticamente el uso de VRAM.
En pruebas en condiciones reales, el modelo ofrece una inferencia aproximadamente 15 veces más rápida, generando un vídeo de 10 segundos en alrededor de un minuto.
Evaluación comparativa: superando a los mejores modelos del sector
Utilizando el benchmark EvalTalker, 770 evaluadores y 10 expertos en la materia realizaron un análisis estructurado de la calidad de vídeos de ámbitos complejos, como las noticias, la educación y el entretenimiento. Los resultados muestran que LongCat-Video-Avatar 1.5 destaca en varias métricas clave:
Índice de aceptación por parte de los usuarios: supera a Kling Avatar 2.0 en un 65,9 %, a OmniHuman-1.5 en un 61,1 % y a HeyGen en un 54,3 %.
Puntuaciones en escenarios con una o varias personas: la puntuación en el escenario con una sola persona alcanza los 3,336, muy por encima de competidores como HeyGen; la puntuación en el escenario con varias personas es de 2,730, superando significativamente a InfiniteTalk (2,339).
Estabilidad del vídeo: la tasa de deformación del sujeto es de solo el 23,1 %, y la del fondo, de apenas el 9,4 %;la tasa de saltos de fotogramas es tan baja como el 0,8 %, la mejor de todos los modelos comparados.
Coordinación audiovisual: La tasa de problemas de sincronización entre el rostro y el cuerpo se redujo al 5,1 %, y la tasa de problemas de sincronización labial descendió al 29,8 %, superando en ambos casos a los sistemas comerciales tradicionales.
El equipo del modelo a gran escala LongCat de Meituan afirma que la publicación en código abierto de LongCat-Video-Avatar 1.5 es más que una simple actualización de versión: es una invitación a la comunidad global de desarrolladores y creadores. Esperan que este modelo sirva como base técnica verificable y mejorable, contribuyendo a ampliar los límites reales de las aplicaciones de vídeo con humanos digitales.
Enlaces de código abierto:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Informe técnico: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Página del proyecto: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary
Artículo relacionado
 La condición de «unicornio» de Preply refleja la resiliencia de Ucrania
La plataforma de aprendizaje de idiomas Preply ha alcanzado una valoración de 1.200 millones de dólares tras una ronda de financiación de serie D de 150 millones de dólares, lo que supone un hito impo
Wang Xingxing: La IA incorporada está lista para lograr un avance similar al de ChatGPT en un plazo de dos o tres años
Wang Xingxing, fundador y director ejecutivo de BotSchool, destacó durante su intervención en el foro principal de la Conferencia Mundial de Robótica de 2026 (WRC2026) que la inteligencia incorporada
Microsoft reactiva su estrategia de inteligencia artificial interna con un nuevo modelo de codificación mientras los costos de Claude se disparan
La programación asistida por inteligencia artificial se ha convertido en un elemento básico del desarrollo de software moderno, pero incluso gigantes tecnológicos como Microsoft están sintiendo el impacto de las costosas suscripciones a modelos de le
Recomendaciones de temas especiales relacionados
Creación de vídeos
 Lanzamiento de los editores de video con inteligencia artificial CapCut para Reels, Shorts, anuncios y comercio en redes sociales
¡Los mejores editores de video con inteligencia artificial de CapCut para 2026, ideales para Reels, Shorts, anuncios y proyectos de comercio en redes sociales! Esta lista cuidadosamente seleccionada presenta herramientas de alto rendimiento y altamente valoradas que, según pruebas reales, ofrecen resultados impresionantes. Encontrará una comparación entre versiones gratuitas y de pago, además de clasificaciones detalladas que le ayudarán a elegir la opción más adecuada. XIX.AI brinda conocimientos especializados para que pueda aprovechar al máximo las ventajas de la inteligencia artificial en la creación de contenido. ¡Explore ahora para encontrar la herramienta ideal y mejorar su productividad hoy mismo!
 14 herramientas
 xix.ai
Investigación Académica
Las mejores herramientas de búsqueda de estudios sobre IA: encuentra revistas, conjuntos de datos y tendencias rápidamente
¡Las mejores herramientas de 2026 para la investigación en IA, con las más valoradas, ya están disponibles en XIX.AI! Esta lista seleccionada incluye potentes recursos revolucionarios que te permiten acceder rápidamente a revistas científicas, conjuntos de datos y tendencias del sector. Consigue una comparación entre las opciones gratuitas y las de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente. Estas opciones imprescindibles te ayudarán a mejorar la eficiencia de tu investigación y a sacar el máximo partido a la IA. ¡Explora ahora mismo y descubre tu herramienta perfecta!
10 herramientas
xix.ai
Marketing
Herramientas de campañas de correo electrónico basadas en IA para el marketing del ciclo de vida
¡Las mejores herramientas de 2026 para campañas de correo electrónico con IA, mejor valoradas para el marketing de ciclo de vida! XIX.AI ha seleccionado una potente colección de soluciones revolucionarias que no te puedes perder, ya que aumentan la eficiencia en la redacción, ayudan a crear contenido altamente segmentado y optimizan todos los flujos de trabajo de marketing. Disfruta de clasificaciones actualizadas semanalmente, pruebas en condiciones reales y una comparación entre opciones gratuitas y de pago para encontrar la herramienta perfecta para tus necesidades. ¡Explora ahora mismo y aprovecha tu ventaja con la IA!
11 herramientas
xix.ai
Finanzas
Las mejores herramientas de análisis de inversiones basadas en IA: compara señales y riesgos de cartera
¡Ya están aquí, en XIX.AI, las mejores herramientas de análisis de inversiones basadas en IA de 2026, según las valoraciones de los usuarios! Esta lista seleccionada incluye señales de gran precisión para evaluar los riesgos de tu cartera y ayudarte a tomar decisiones más inteligentes y basadas en datos. Realizamos pruebas en condiciones reales cada semana para actualizar las clasificaciones y ofrecemos una comparación entre las opciones gratuitas y las de pago. Descubre hoy mismo la herramienta perfecta para mejorar la eficiencia de tu análisis de inversiones. ¡Explora ahora!
10 herramientas
xix.ai
chatbot
Herramientas de chatbot con IA para la atención al cliente en sitios web
¡Las mejores herramientas de chatbot con IA para la atención al cliente en sitios web de 2026 ya están aquí, en XIX.AI! Nuestra lista seleccionada incluye soluciones potentes y revolucionarias que aceleran los tiempos de respuesta, mejoran la satisfacción del cliente y ahorran muchísimo trabajo manual. Cada opción se somete a rigurosas pruebas en condiciones reales, con detalles comparativos entre las versiones gratuitas y de pago. ¡Explórala ahora para encontrar la herramienta perfecta que potencie la eficiencia de tu servicio de atención en línea!
10 herramientas
xix.ai
Redes Sociales
Herramientas de respuesta a comentarios con IA de Instagram para tiendas, mensajes privados y gestión de comunidades
¡Las mejores herramientas de 2026 para responder comentarios con IA en Instagram, ideales para tiendas, mensajes privados y gestión de comunidades! XIX.AI ha elaborado una lista de las soluciones más destacadas y revolucionarias, con clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, además de pruebas en entornos reales. Estas herramientas imprescindibles permiten aumentar significativamente la productividad al simplificar las tareas de respuesta, ahorrar tiempo y mejorar la interacción con los clientes en todas las plataformas de redes sociales. ¡Explórelas ahora para encontrar la herramienta perfecta para una gestión de comunidades sin complicaciones!
10 herramientas
xix.ai

 comentario (0)
0/500
El equipo de modelos a gran escala LongCat de Meituan ha publicado oficialmente en código abierto LongCat-Video-Avatar 1.5, un modelo de generación de vídeo de personas digitales de calidad comercial. Esta versión supone un cambio total, pasando de la tecnología de vanguardia de código abierto a la implementación comercial en el mundo real, con importantes mejoras en la sincronización labial, el realismo físico, la estabilidad en vídeos largos, las interacciones entre varias personas y la eficiencia en la inferencia.
Tres mejoras clave para superar los obstáculos de la comercialización
Para que los humanos digitales funcionen de forma fiable en diversas aplicaciones del mundo real, LongCat-Video-Avatar 1.5 aborda problemas persistentes como el jitter, la distorsión y la alta latencia en los vídeos tradicionales de humanos digitales mediante tres mejoras integrales:
Mejora de la codificación de audio de calidad comercial
El codificador de extracción de características de audio del modelo se ha actualizado de Wav2Vec2 a Whisper-large. Con más parámetros y un conocimiento previo multilingüe más rico, ahora capta variaciones sutiles de fonemas y el ritmo del habla. Esto mejora la sincronización labial en audios complejos, como frases largas, habla rápida y canto, al tiempo que permite una coordinación natural entre las expresiones faciales, los movimientos de la cabeza y el habla, lo que reduce significativamente el salto de fotogramas y la deriva de identidad en vídeos más largos.
Generalización robusta en dominio abierto mediante la mejora de datos en varias etapas
Para garantizar un rendimiento estable con sujetos diversos —personas reales, ídolos virtuales, personajes de anime y animales—, el equipo desarrolló un flujo de datos en varias etapas que incorpora anotación fuera de línea y validación en línea, e introdujo tres tipos específicos de datos mejorados:
Datos de múltiples personas: mediante la detección activa del hablante, elimina la ambigüedad audiovisual en escenas con varias personas, diferenciando con precisión a los hablantes de los oyentes.
Datos silenciosos: al seleccionar vídeos sin habla, el modelo aprende microexpresiones naturales durante los estados de silencio, lo que evita movimientos bucales no deseados en los personajes que no hablan.
Datos emocionales: en combinación con un filtrado de reconocimiento emocional a nivel de fotograma, incorpora variaciones emocionales, lo que ayuda al modelo a comprender el profundo vínculo entre el habla y las expresiones faciales.
Alineación de manos y continuidad temporal con GRPO
Para casos de uso como las retransmisiones en directo de comercio electrónico y las demostraciones de productos, en las que las manos suelen estar visibles, el modelo introduce GRPO (Human Preference Alignment), que refina las señales de recompensa a nivel de fotograma y añade un mecanismo de detección de manos en el primer fotograma. Esto reduce sustancialmente problemas comunes como la distorsión de las manos, el colapso estructural local y el movimiento inconsistente.
Inferencia 15 veces más rápida: eliminación de los costosos requisitos de computación
El coste es otro factor crítico para el despliegue comercial. LongCat-Video-Avatar 1.5 utiliza la tecnología DMD (Distributed Matching Distillation), que comprime el proceso de generación original de 50 pasos a solo 8. Además, el equipo sustituyó la configuración paralela convencional de tres modelos por un único modelo base compartido más varios adaptadores LoRA, lo que redujo drásticamente el uso de VRAM.
En pruebas en condiciones reales, el modelo ofrece una inferencia aproximadamente 15 veces más rápida, generando un vídeo de 10 segundos en alrededor de un minuto.
Evaluación comparativa: superando a los mejores modelos del sector
Utilizando el benchmark EvalTalker, 770 evaluadores y 10 expertos en la materia realizaron un análisis estructurado de la calidad de vídeos de ámbitos complejos, como las noticias, la educación y el entretenimiento. Los resultados muestran que LongCat-Video-Avatar 1.5 destaca en varias métricas clave:
Índice de aceptación por parte de los usuarios: supera a Kling Avatar 2.0 en un 65,9 %, a OmniHuman-1.5 en un 61,1 % y a HeyGen en un 54,3 %.
Puntuaciones en escenarios con una o varias personas: la puntuación en el escenario con una sola persona alcanza los 3,336, muy por encima de competidores como HeyGen; la puntuación en el escenario con varias personas es de 2,730, superando significativamente a InfiniteTalk (2,339).
Estabilidad del vídeo: la tasa de deformación del sujeto es de solo el 23,1 %, y la del fondo, de apenas el 9,4 %;la tasa de saltos de fotogramas es tan baja como el 0,8 %, la mejor de todos los modelos comparados.
Coordinación audiovisual: La tasa de problemas de sincronización entre el rostro y el cuerpo se redujo al 5,1 %, y la tasa de problemas de sincronización labial descendió al 29,8 %, superando en ambos casos a los sistemas comerciales tradicionales.
El equipo del modelo a gran escala LongCat de Meituan afirma que la publicación en código abierto de LongCat-Video-Avatar 1.5 es más que una simple actualización de versión: es una invitación a la comunidad global de desarrolladores y creadores. Esperan que este modelo sirva como base técnica verificable y mejorable, contribuyendo a ampliar los límites reales de las aplicaciones de vídeo con humanos digitales.
Enlaces de código abierto:
Github: https://github.com/meituan-longcat/LongCat-Video
HuggingFace: https://huggingface.co/meituan-longcat/LongCat-Video-Avatar-1.5
Informe técnico: https://github.com/meituan-longcat/LongCat-Video/blob/main/assets/LongCat-Video-Avatar-1.5-Tech-Report.pdf
Página del proyecto: https://meigen-ai.github.io/LongCat-Video-Avatar-1.5-Page/
Modelscope: https://www.modelscope.cn/models/meituan-longcat/LongCat-Video-Avatar-1.5/summary








 La condición de «unicornio» de Preply refleja la resiliencia de Ucrania
La plataforma de aprendizaje de idiomas Preply ha alcanzado una valoración de 1.200 millones de dólares tras una ronda de financiación de serie D de 150 millones de dólares, lo que supone un hito impo
 Wang Xingxing: La IA incorporada está lista para lograr un avance similar al de ChatGPT en un plazo de dos o tres años
Wang Xingxing, fundador y director ejecutivo de BotSchool, destacó durante su intervención en el foro principal de la Conferencia Mundial de Robótica de 2026 (WRC2026) que la inteligencia incorporada
 Microsoft reactiva su estrategia de inteligencia artificial interna con un nuevo modelo de codificación mientras los costos de Claude se disparan
La programación asistida por inteligencia artificial se ha convertido en un elemento básico del desarrollo de software moderno, pero incluso gigantes tecnológicos como Microsoft están sintiendo el impacto de las costosas suscripciones a modelos de le
¡Los mejores editores de video con inteligencia artificial de CapCut para 2026, ideales para Reels, Shorts, anuncios y proyectos de comercio en redes sociales! Esta lista cuidadosamente seleccionada presenta herramientas de alto rendimiento y altamente valoradas que, según pruebas reales, ofrecen resultados impresionantes. Encontrará una comparación entre versiones gratuitas y de pago, además de clasificaciones detalladas que le ayudarán a elegir la opción más adecuada. XIX.AI brinda conocimientos especializados para que pueda aprovechar al máximo las ventajas de la inteligencia artificial en la creación de contenido. ¡Explore ahora para encontrar la herramienta ideal y mejorar su productividad hoy mismo!
14 herramientas
xix.ai
¡Las mejores herramientas de 2026 para la investigación en IA, con las más valoradas, ya están disponibles en XIX.AI! Esta lista seleccionada incluye potentes recursos revolucionarios que te permiten acceder rápidamente a revistas científicas, conjuntos de datos y tendencias del sector. Consigue una comparación entre las opciones gratuitas y las de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente. Estas opciones imprescindibles te ayudarán a mejorar la eficiencia de tu investigación y a sacar el máximo partido a la IA. ¡Explora ahora mismo y descubre tu herramienta perfecta!
10 herramientas
xix.ai
¡Las mejores herramientas de 2026 para campañas de correo electrónico con IA, mejor valoradas para el marketing de ciclo de vida! XIX.AI ha seleccionado una potente colección de soluciones revolucionarias que no te puedes perder, ya que aumentan la eficiencia en la redacción, ayudan a crear contenido altamente segmentado y optimizan todos los flujos de trabajo de marketing. Disfruta de clasificaciones actualizadas semanalmente, pruebas en condiciones reales y una comparación entre opciones gratuitas y de pago para encontrar la herramienta perfecta para tus necesidades. ¡Explora ahora mismo y aprovecha tu ventaja con la IA!
11 herramientas
xix.ai
¡Ya están aquí, en XIX.AI, las mejores herramientas de análisis de inversiones basadas en IA de 2026, según las valoraciones de los usuarios! Esta lista seleccionada incluye señales de gran precisión para evaluar los riesgos de tu cartera y ayudarte a tomar decisiones más inteligentes y basadas en datos. Realizamos pruebas en condiciones reales cada semana para actualizar las clasificaciones y ofrecemos una comparación entre las opciones gratuitas y las de pago. Descubre hoy mismo la herramienta perfecta para mejorar la eficiencia de tu análisis de inversiones. ¡Explora ahora!
10 herramientas
xix.ai
¡Las mejores herramientas de chatbot con IA para la atención al cliente en sitios web de 2026 ya están aquí, en XIX.AI! Nuestra lista seleccionada incluye soluciones potentes y revolucionarias que aceleran los tiempos de respuesta, mejoran la satisfacción del cliente y ahorran muchísimo trabajo manual. Cada opción se somete a rigurosas pruebas en condiciones reales, con detalles comparativos entre las versiones gratuitas y de pago. ¡Explórala ahora para encontrar la herramienta perfecta que potencie la eficiencia de tu servicio de atención en línea!
10 herramientas
xix.ai
¡Las mejores herramientas de 2026 para responder comentarios con IA en Instagram, ideales para tiendas, mensajes privados y gestión de comunidades! XIX.AI ha elaborado una lista de las soluciones más destacadas y revolucionarias, con clasificaciones actualizadas semanalmente, comparaciones entre versiones gratuitas y de pago, además de pruebas en entornos reales. Estas herramientas imprescindibles permiten aumentar significativamente la productividad al simplificar las tareas de respuesta, ahorrar tiempo y mejorar la interacción con los clientes en todas las plataformas de redes sociales. ¡Explórelas ahora para encontrar la herramienta perfecta para una gestión de comunidades sin complicaciones!
10 herramientas
xix.ai












